قاموس مبني على شجرة AVL (AVL Dictionary)
تفاصيل العمل
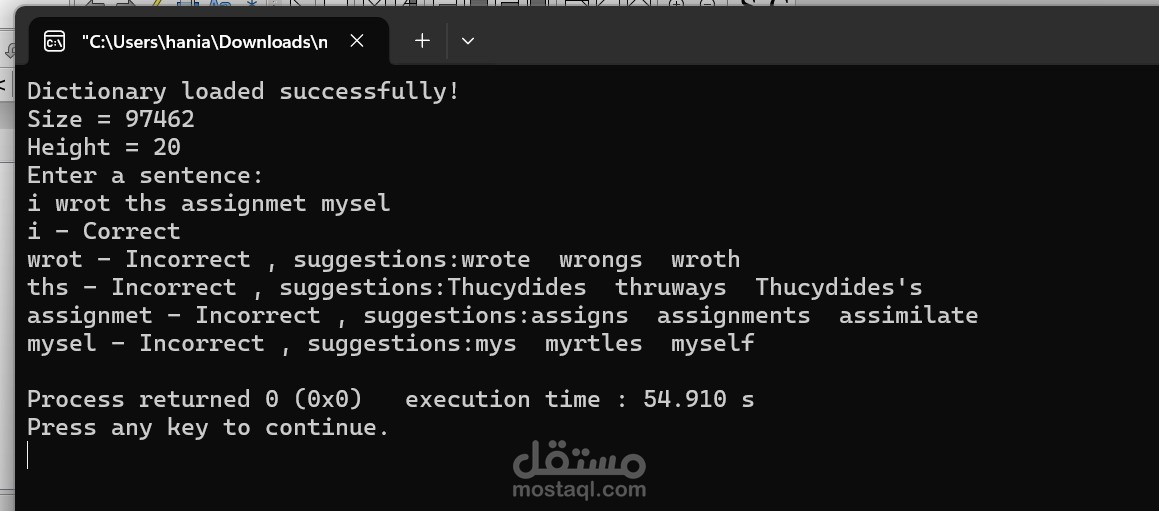
قمت بتصميم وتطوير نظام تدقيق إملائي فعّال يعتمد في تخزين قاموس الكلمات وتنظيمها على شجرة AVL المتوازنة ذاتيًا، وذلك لضمان أداء أسرع وأكثر كفاءة في عمليات البحث والإدراج بحيث تبقى دائمًا بتعقيد زمني O(log n) حتى مع تحميل قاموس يحتوي على عشرات الآلاف من الكلمات.
يقوم النظام بتحميل قاموس كامل للكلمات (أكثر من 97 ألف كلمة)، ثم يعرض حجم الشجرة وارتفاعها، بعدها يتيح للمستخدم إدخال جملة كاملة ليقوم بفحصها كلمة كلمة والتحقق من صحتها إملائيًا.
وأهم ما أضفته في هذا المشروع هو خاصية اقتراح الكلمات الصحيحة تلقائيًا عند اكتشاف خطأ إملائي: فإذا كانت الكلمة غير موجودة في القاموس، لا يكتفي النظام بالإشارة إلى الخطأ فقط، بل يعرض للمستخدم ثلاث كلمات بديلة مقترحة، مبنية على أقرب نقطة وصل إليها البحث داخل الشجرة (الكلمة السابقة والكلمة اللاحقة لها ترتيبيًا)، بأسلوب مشابه لآلية الاقتراحات الذكية المستخدمة في برامج تدقيق النصوص الاحترافية.
أهم ما يميز هذا المشروع:
- بنية بيانات متوازنة (AVL) تضمن أداءً ثابتًا وسريعًا بغض النظر عن حجم البيانات.
- خوارزمية ذكية لاقتراح الكلمات الصحيحة عند وقوع خطأ إملائي.
- معالجة الجمل الكاملة كلمة بكلمة مع تجاهل حالة الأحرف (كبيرة/صغيرة).
- تصميم عملي وقابل للتوسعة يمكن تطبيقه في تطبيقات تحرير النصوص، محركات البحث، أو أي نظام يحتاج للتحقق السريع من صحة الكلمات.
هذا النوع من الأنظمة يمثل الأساس الذي تُبنى عليه أدوات مثل مدقق الإملاء في محررات النصوص والمتصفحات ومحركات البحث، وأقدم خدمات مشابهة في تصميم وبناء هياكل بيانات مخصصة (Custom Data Structures) لحل مشكلات الأداء والبحث الفعّال ضمن أي مشروع برمجي.