Text Emotion Recognition System using Machine Learning
تفاصيل العمل
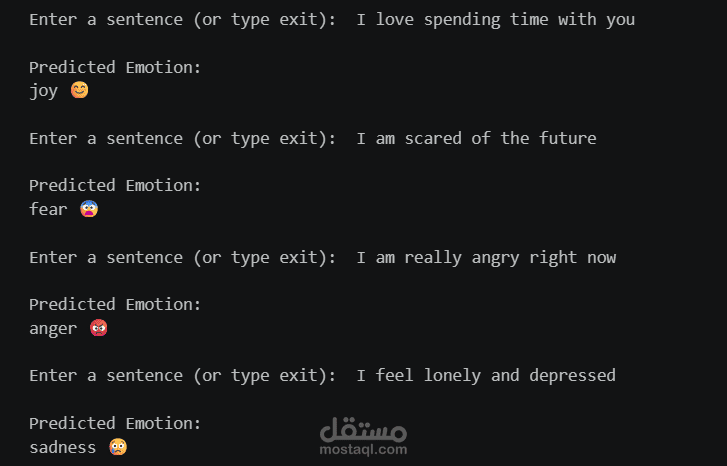
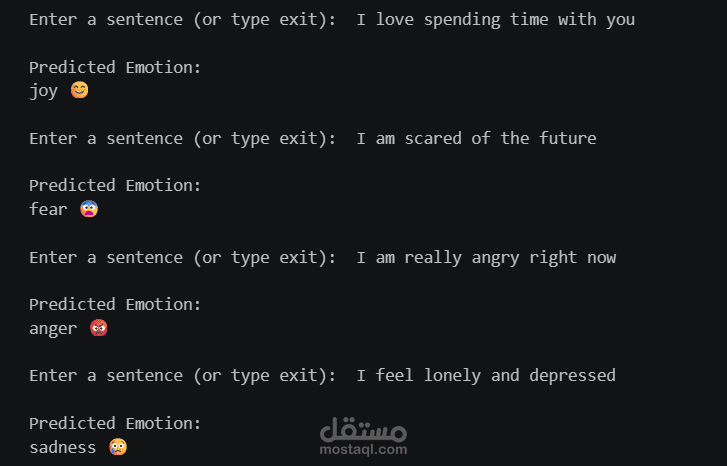
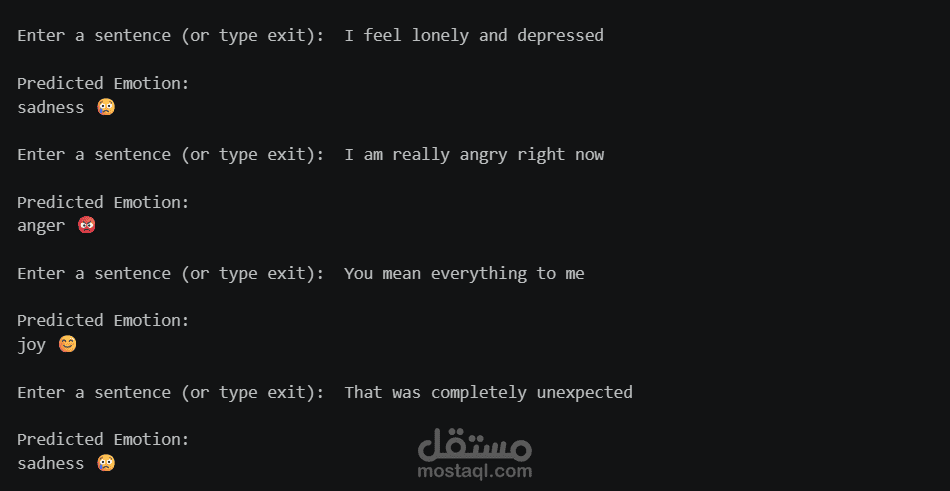
طورت نظامًا للتعرف على المشاعر من النصوص باستخدام تعلم الآلة، يقوم بتصنيف النصوص الإنجليزية تلقائيًا إلى ست فئات من المشاعر: الفرح، الحزن، الغضب، الخوف، الحب، والمفاجأة.
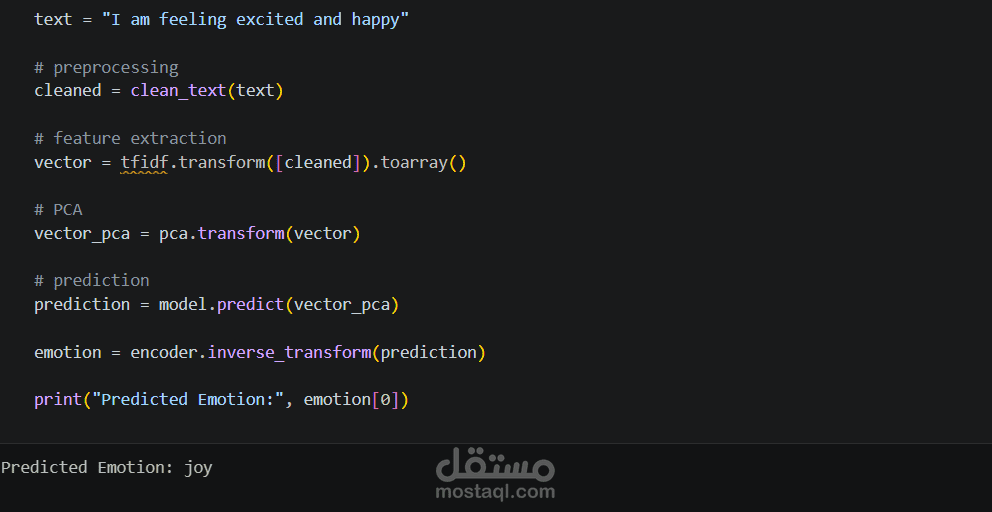
يعتمد المشروع على خط معالجة متكامل في مجال التعرف على الأنماط ومعالجة اللغة الطبيعية (NLP)، ويشمل معالجة النصوص، واستخراج الخصائص، وتقليل الأبعاد، ثم تصنيف البيانات.
يتضمن المشروع:
• تنظيف النصوص وتوحيدها وتقسيمها إلى كلمات.
• إزالة الكلمات الشائعة (Stop Words) وتطبيق Lemmatization.
• استخراج الخصائص باستخدام TF-IDF مع استخدام خصائص Unigram وBigram.
• استخدام PCA لتقليل أبعاد البيانات وتحسين الكفاءة الحسابية.
• تدريب ومقارنة نماذج Logistic Regression وSupport Vector Machine (SVM).
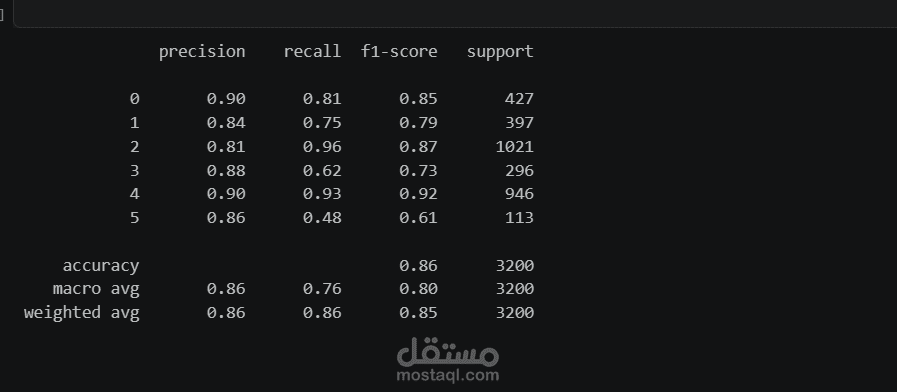
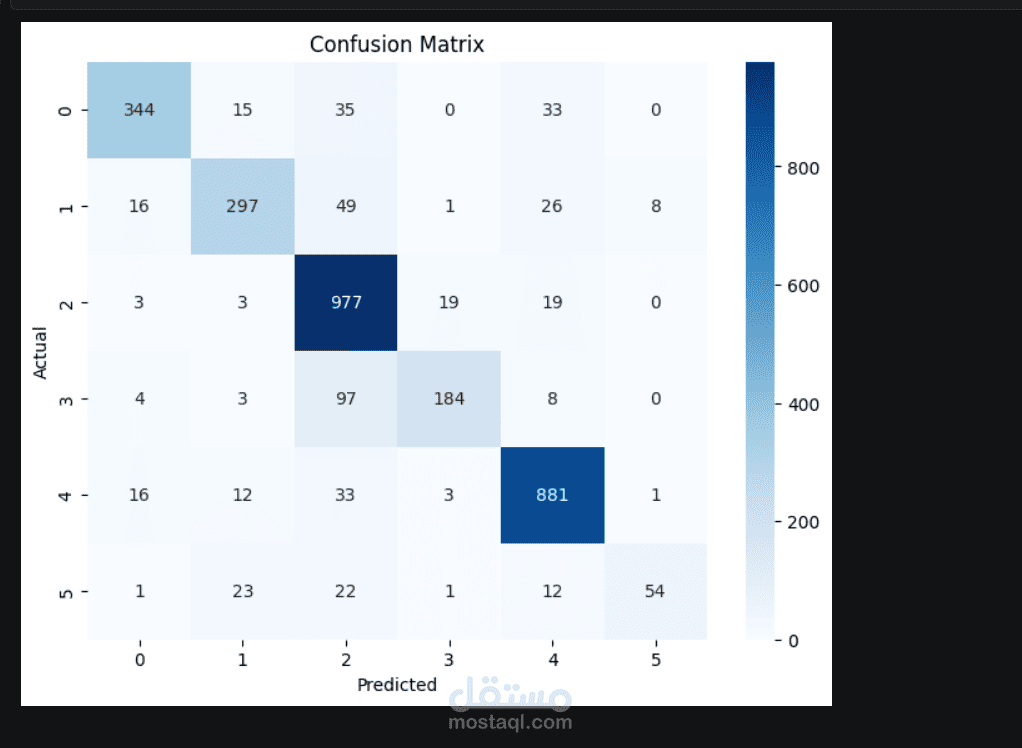
• تقييم أداء النماذج باستخدام Accuracy وPrecision وRecall وF1-Score وConfusion Matrix.
يوضح المشروع كيفية استخدام تقنيات تعلم الآلة ومعالجة اللغة الطبيعية لفهم المشاعر التي يعبر عنها المستخدمون في النصوص بشكل آلي، مع إمكانية تطبيقه في تحليل آراء العملاء، ومراقبة محتوى وسائل التواصل الاجتماعي، وتحليل الآراء والانطباعات.