Heart_Disease_Prediction.csv
تفاصيل العمل
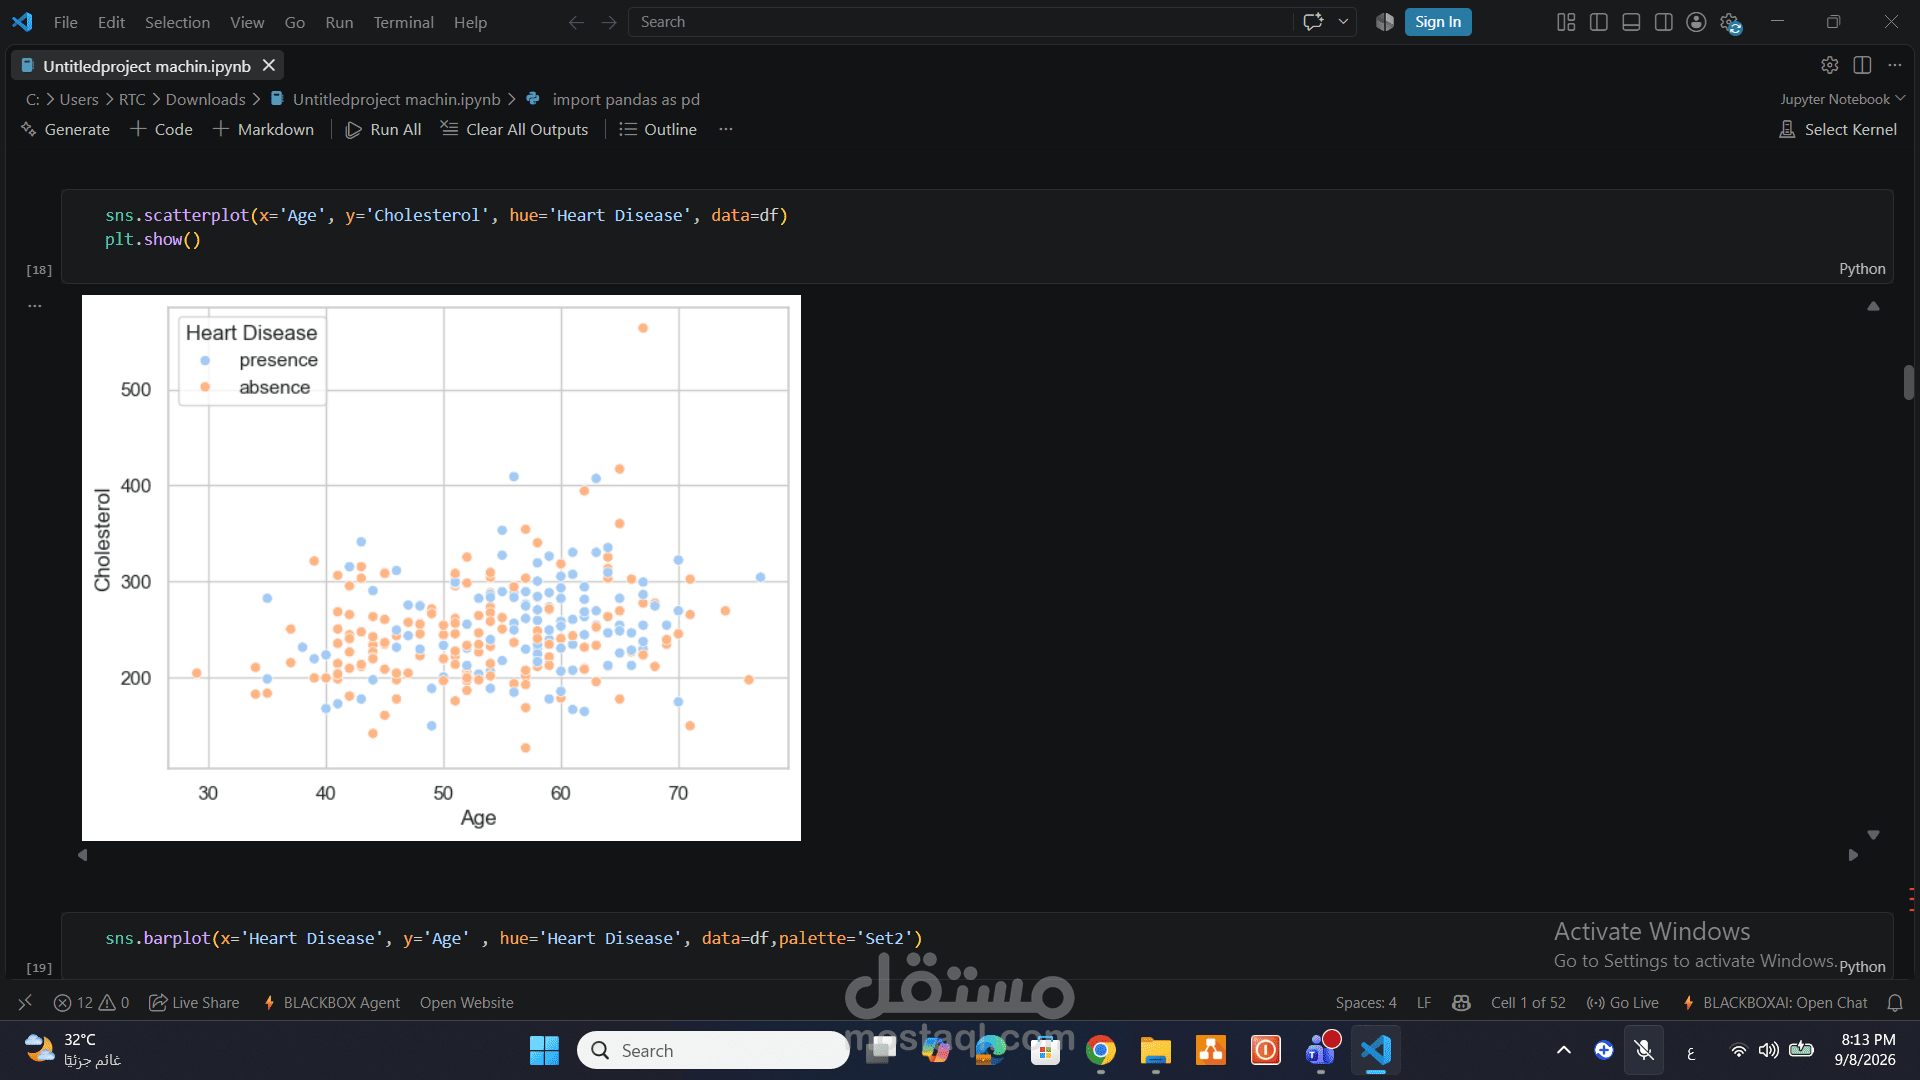
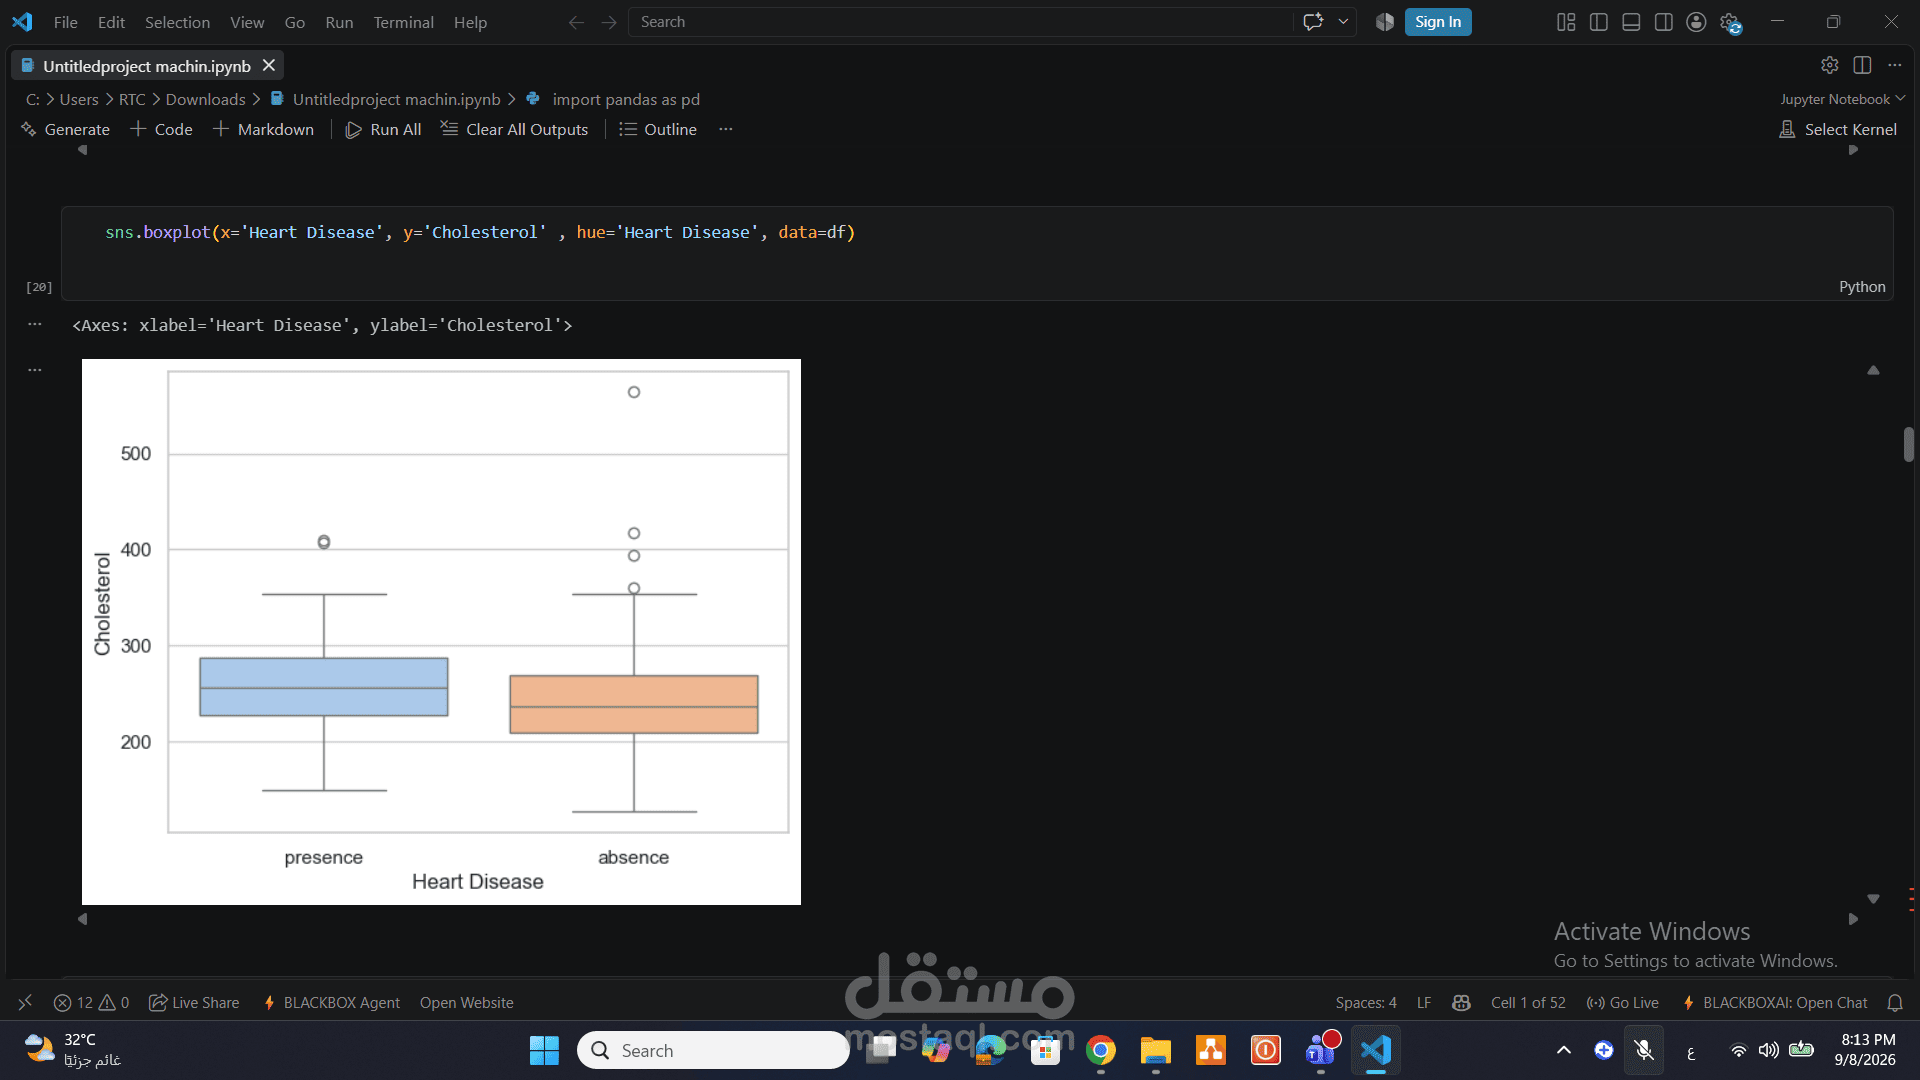
1. الهدف من المشروع (Project Goal)
التنبؤ بما إذا كان المريض مصاباً بمرض القلب أم لا بناءً على مجموعة من المؤشرات والأعراض الطبية.
2. مراحل وخطوات العمل (Workflow Steps):
أولاً: استكشاف ومعالجة البيانات (Data Exploration & Preprocessing)
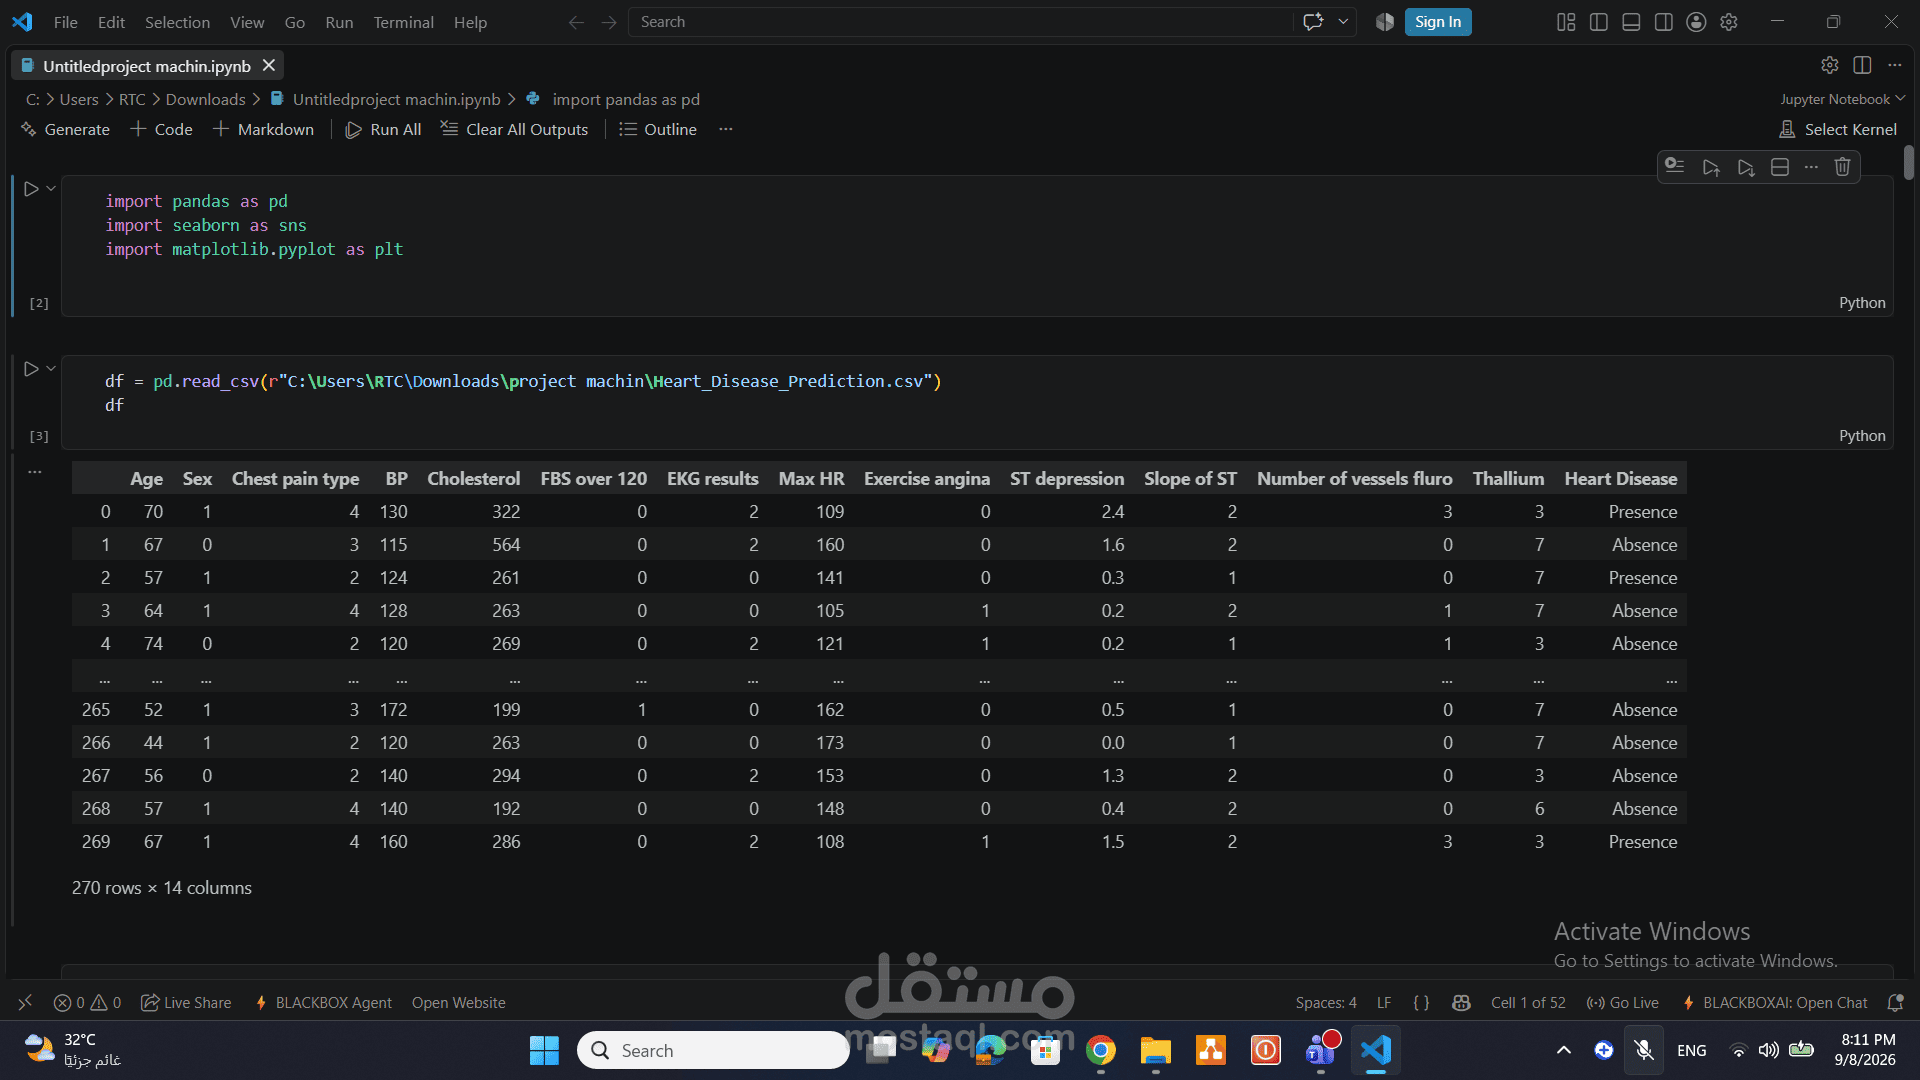
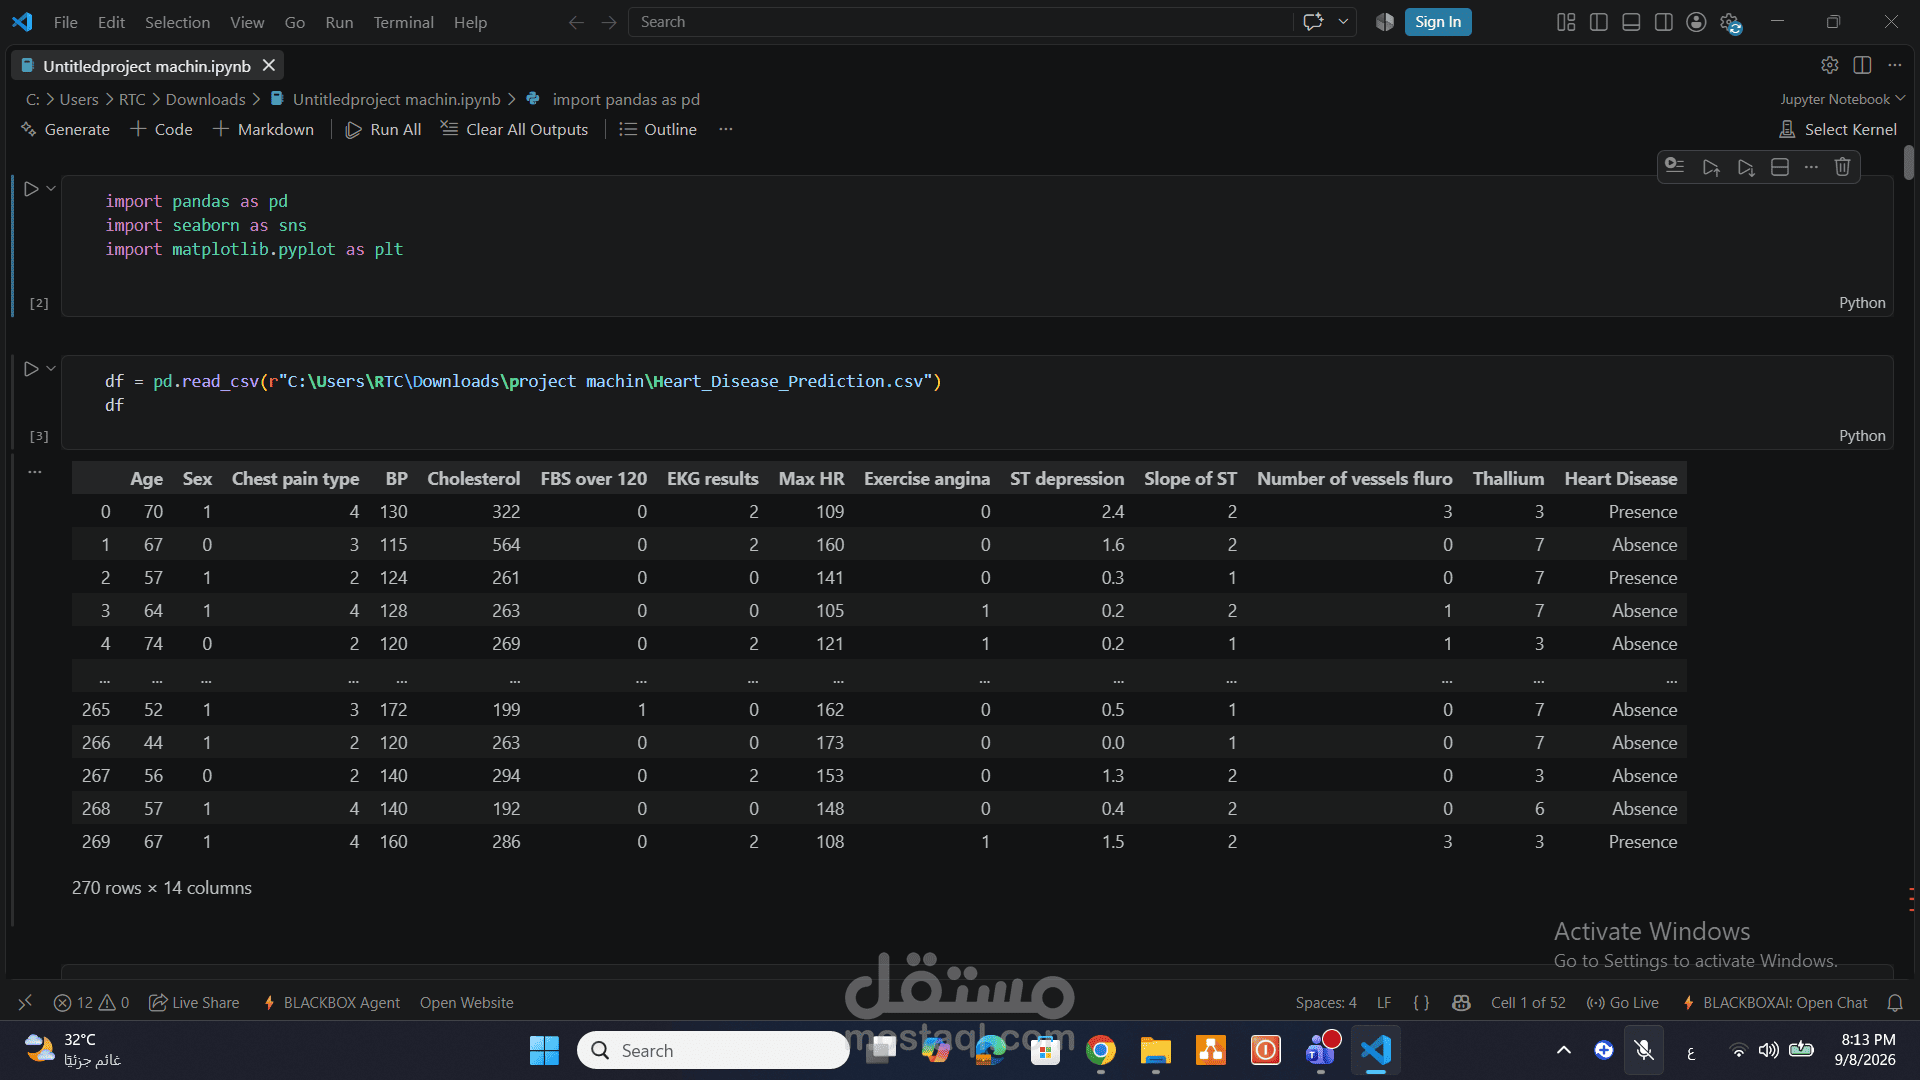
تحميل البيانات: تم استيراد مكتبات تحليل البيانات الأساسية (pandas, numpy) وقراءة ملف البيانات Heart_Disease_Prediction.csv.
استكشاف الهيكل:
عرض الصفوف الأولى من البيانات باستخدام df.head().
أخذ عشوائي للصفوف باستخدام df.sample(5).
معاينة الصفوف الأخيرة باستخدام df.tail().
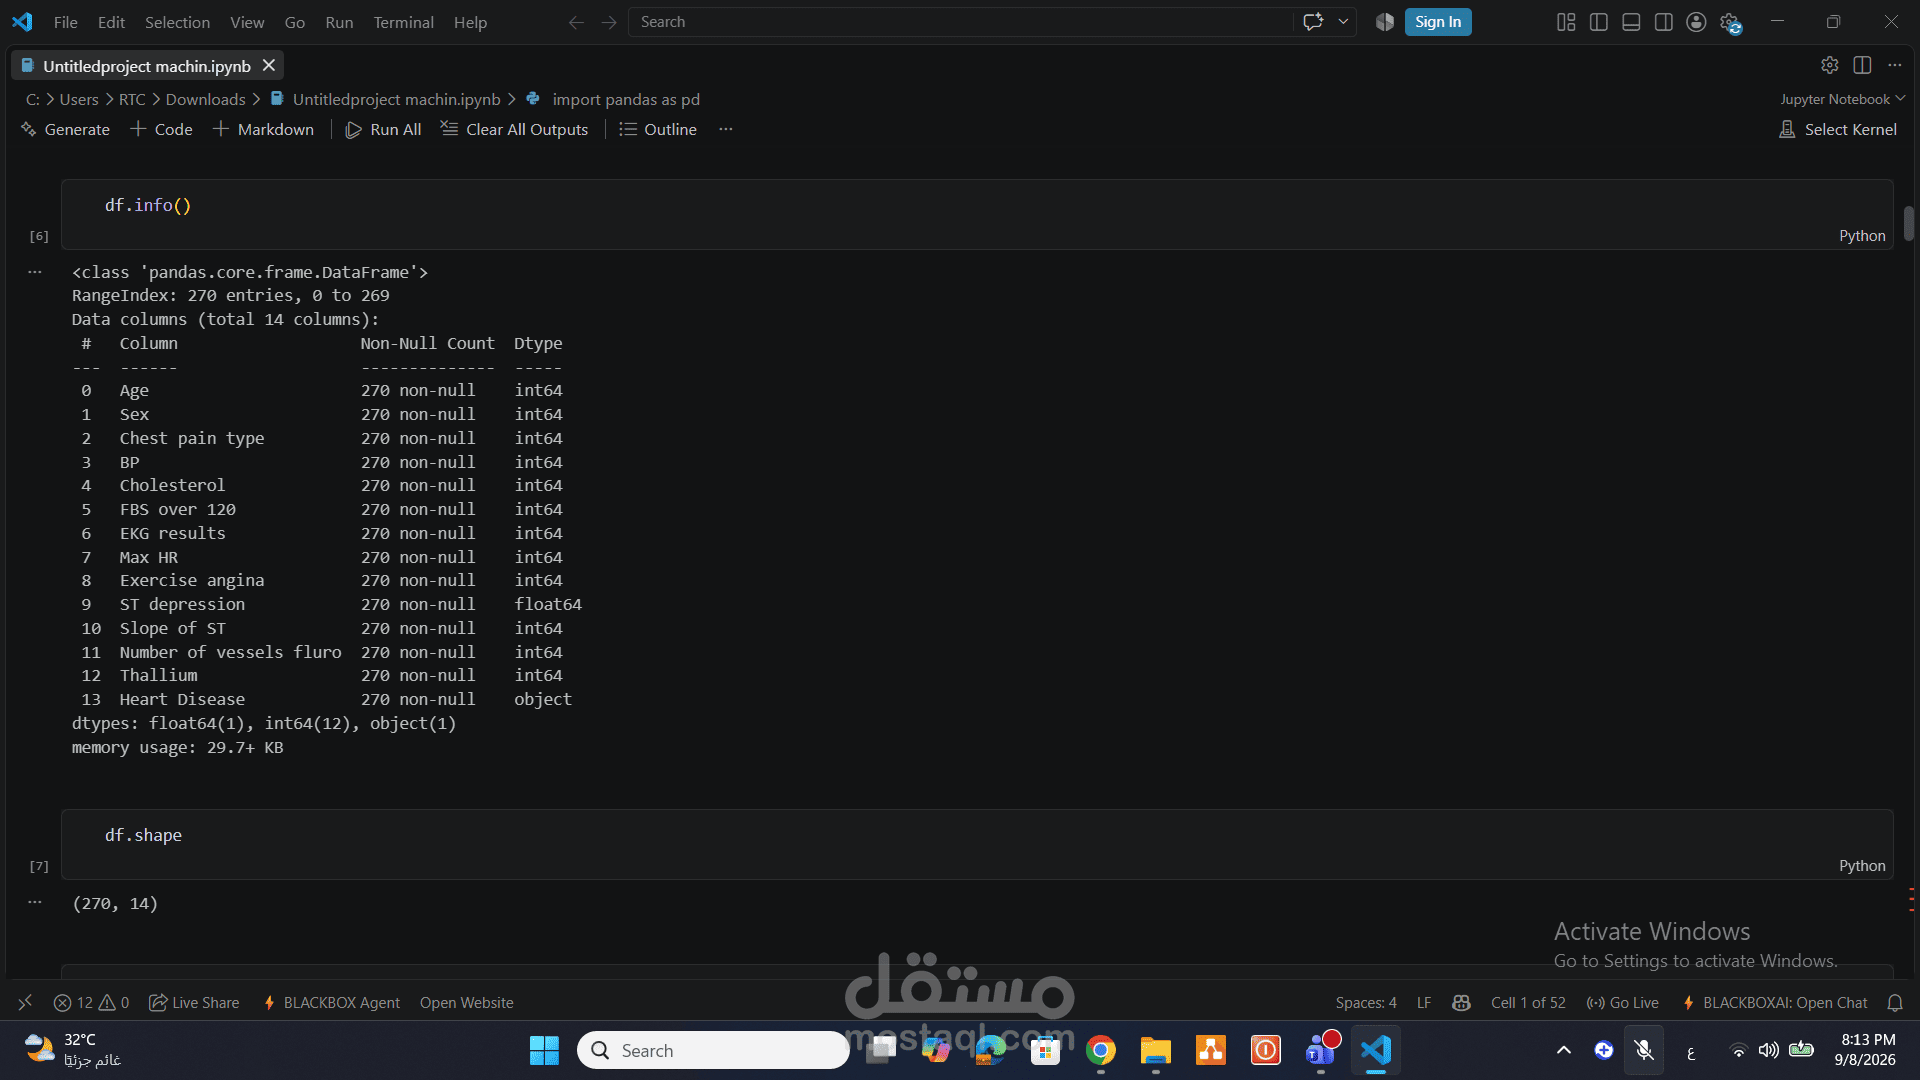
معرفة حجم البيانات وأبعادها (df.shape).
فحص أنواع البيانات والقيم المفقودة:
عرض معلومات الأعمدة وأنواعها باستخدام df.info().
التحقق من وجود أي قيم مفقودة (Null Values) عبر df.isna().sum().
تنظيف وتحويل البيانات (Data Cleaning & Encoding):
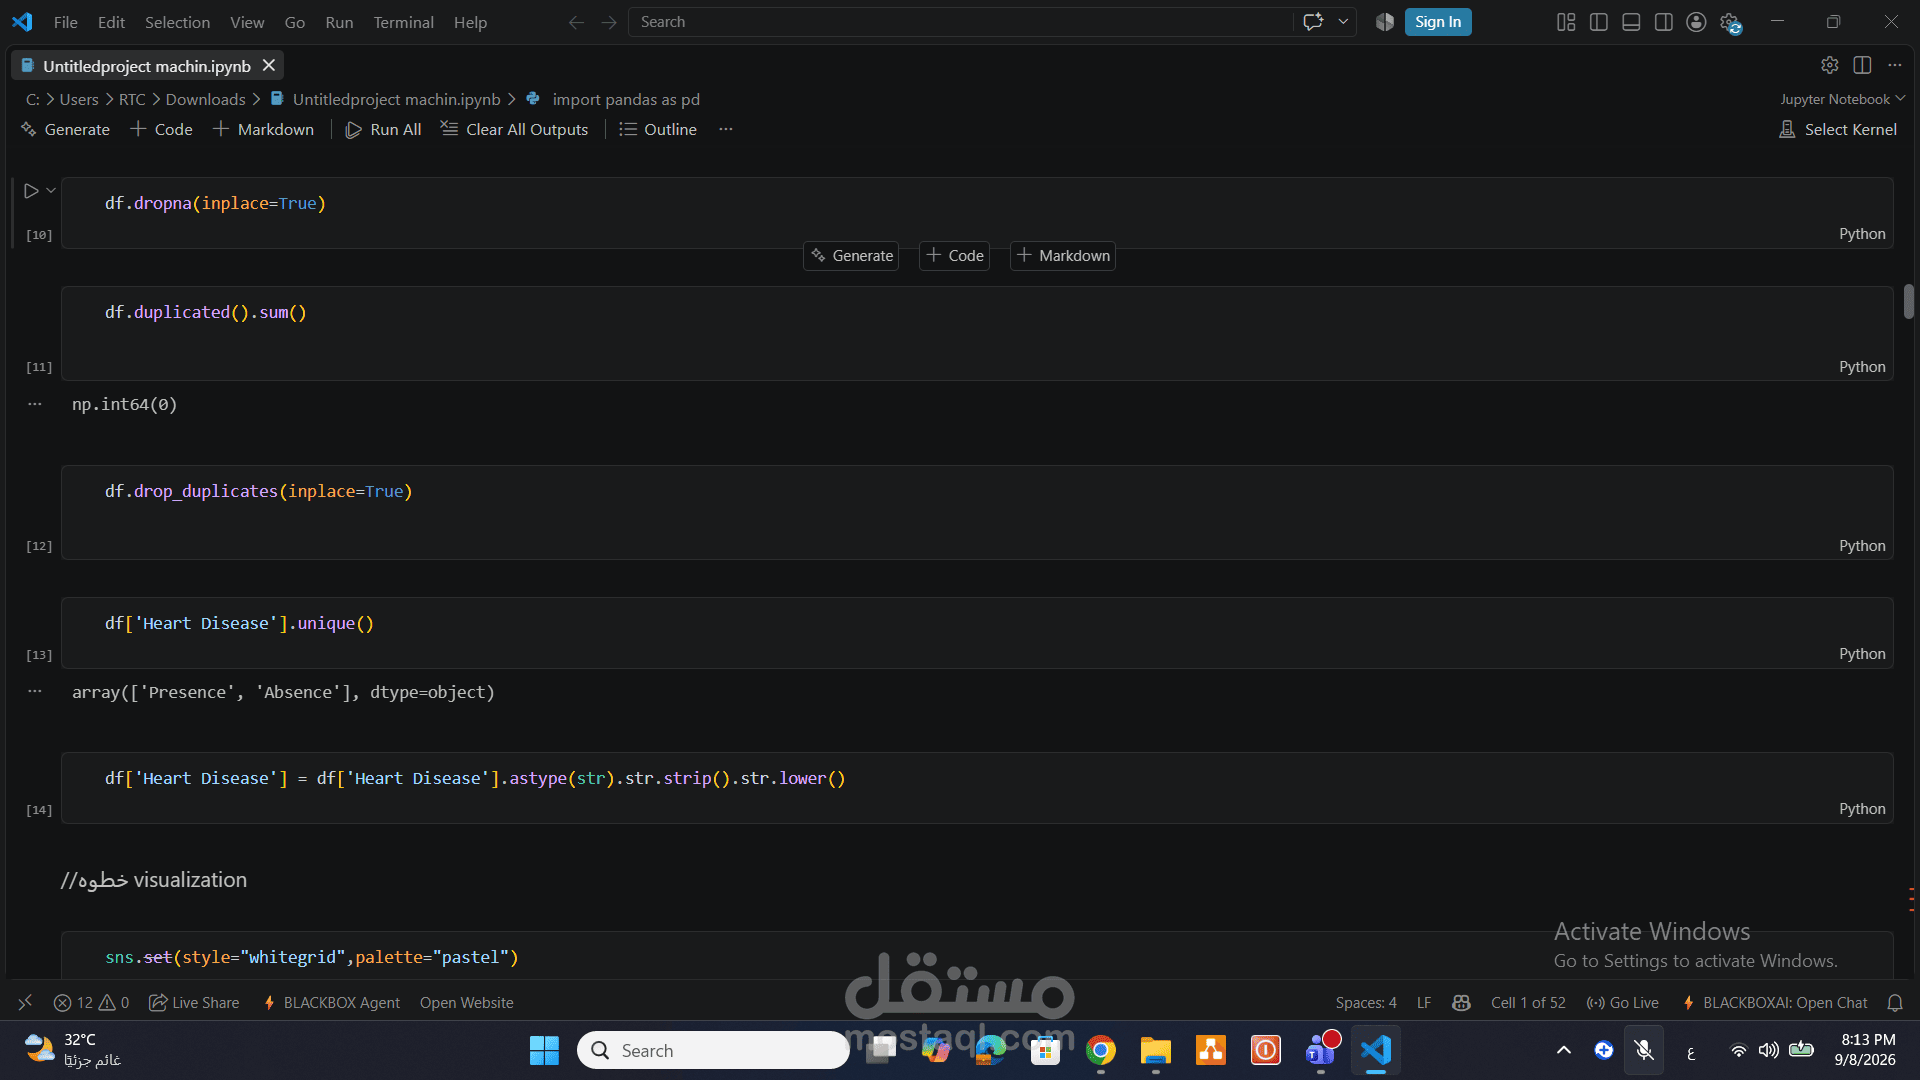
تحويل العمود المستهدف (Heart Disease) من قيم نصية (Presence / Absence) إلى قيم رقمية:
1 يعبر عن وجود المرض (Presence).
0 يعبر عن عدم وجود المرض (Absence).
فصل المتغيرات (Feature Separation):
فصل الميزات/المؤشرات الطبية (
X
) عن العمود المستهدف/النتيجة (
y
).
ثانياً: تقسيم البيانات وتطوير النموذج (Data Splitting & Model Training)
تقسيم البيانات: تقسيم البيانات إلى مجموعتي تدريب واختبار بنسبة 80% للتدريب و20% للاختبار باستخدام train_test_split مع تحديد random_state=42 للحفاظ على ثبات النتائج.
بناء وتدريب النموذج:
تم استخدام خوارزمية الأشجار العشوائية (Random Forest Classifier)، وهي إحدى أداء خوارزميات التعلم الآلي القوية في المهام التصنيفية.
تم تدريب النموذج على مجموعة البيانات المخصصة للتدريب باستخدام rf.fit(X_train, y_train).
ثالثاً: تقييم أداء النموذج (Model Evaluation)
التنبؤ: إجراء التنبؤات على مجموعة الاختبار rf.predict(X_test).
قياس الدقة:
حساب نسبة دقة التنبؤ للنموذج باستخدام accuracy_score على بيانات الاختبار.