AskMyPDF's
تفاصيل العمل
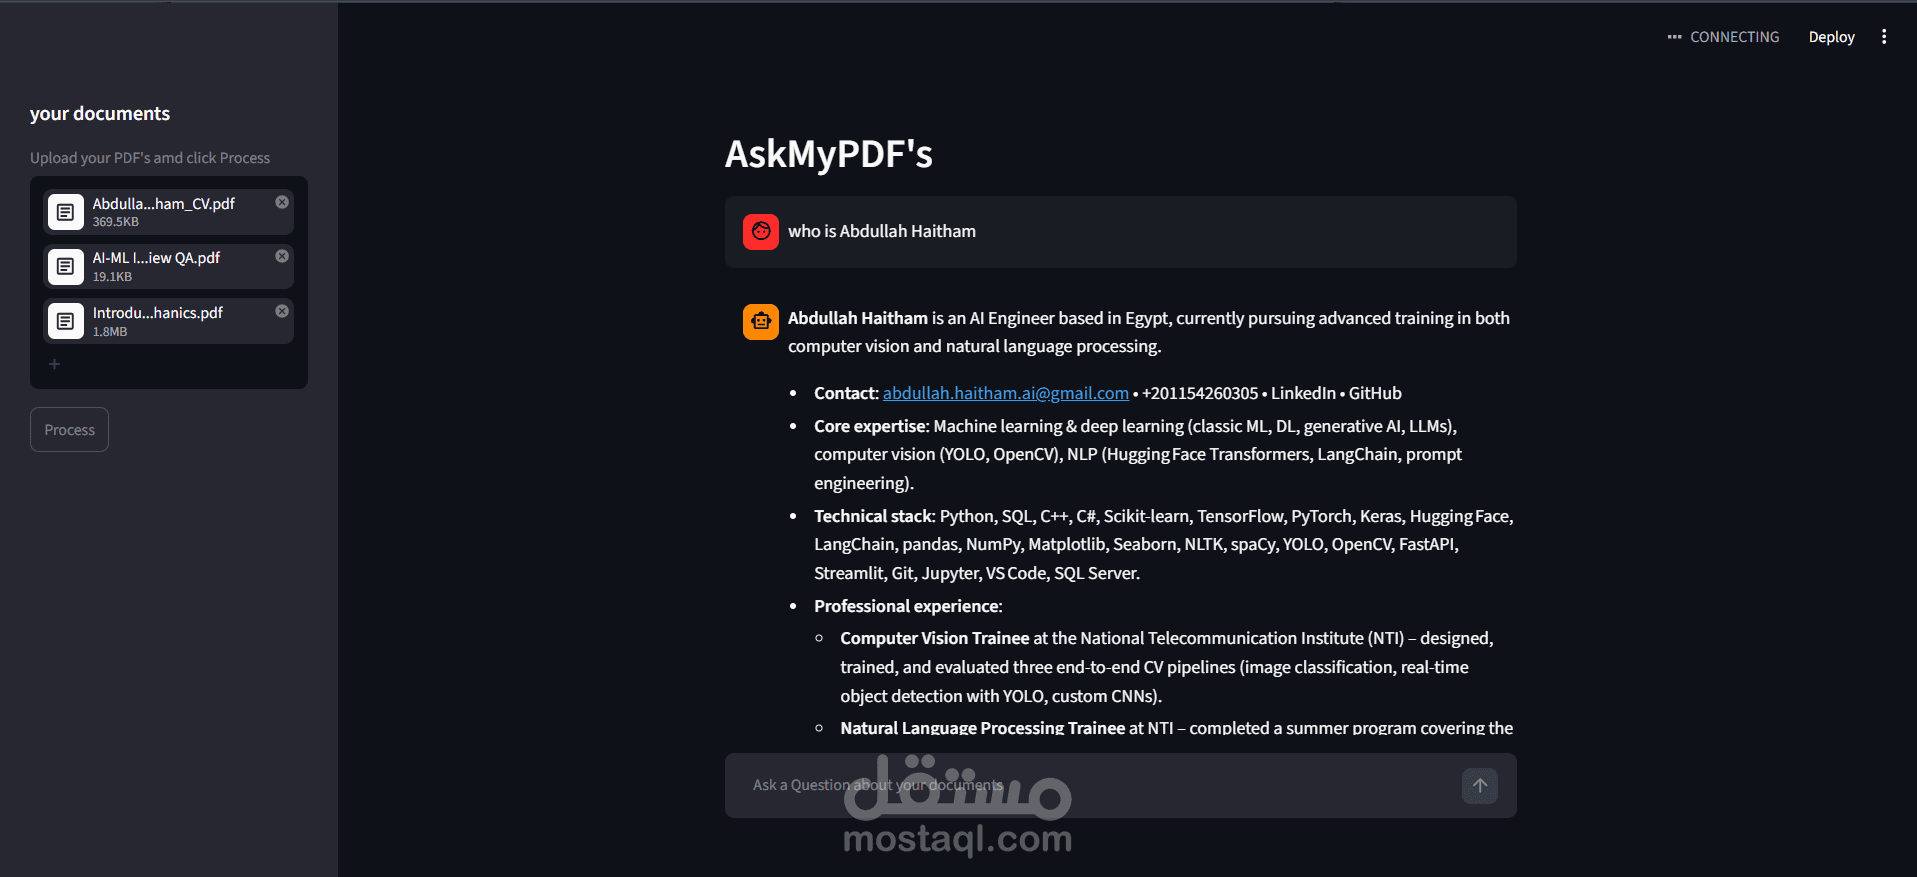
## نبذة عن المشروع
طوّرت تطبيق ويب يتيح للمستخدم رفع ملف أو أكثر من ملفات PDF، ثم طرح أسئلة عليه بلغة طبيعية والحصول على إجابات دقيقة مبنية فعليًا على محتوى الملف — بدل قراءة عشرات الصفحات يدويًا.
التطبيق مبني بتقنية RAG (Retrieval-Augmented Generation)، وهي التقنية المعتمدة حاليًا في أدوات البحث الذكي داخل المستندات، الشات بوتات الخاصة بالشركات، وأنظمة دعم العملاء المعتمدة على قواعد معرفة داخلية.
## ما الذي يقدمه هذا النوع من الحلول لعميلك؟
- تحويل مستندات (تقارير، عقود، أدلة، كتيبات تدريب، سياسات داخلية) إلى مصدر إجابات فوري بدل البحث اليدوي
- واجهة محادثة بسيطة يفهمها أي مستخدم غير تقني
- إمكانية بناء نسخة مخصصة تعمل على مستندات الشركة أو مجالها (قانوني، طبي، تعليمي، خدمة عملاء)
- حل قابل للتوسّع: يمكن ربطه لاحقًا بقاعدة بيانات، نظام تسجيل دخول، أو دمجه داخل موقع/منصة قائمة
## آلية العمل التقنية (باختصار)
1. استخراج النص من ملفات PDF
2. تقسيم النص إلى أجزاء صغيرة مع الحفاظ على السياق
3. تحويل كل جزء إلى تمثيل رقمي (embeddings) وتخزينه في قاعدة بيانات متجهية (FAISS)
4. عند كل سؤال، يتم استرجاع الأجزاء الأكثر صلة بالسؤال
5. يُبنى prompt يجمع السياق المسترجَع + تاريخ المحادثة + السؤال، ويُرسل إلى نموذج لغوي لإنتاج الإجابة
## التقنيات المستخدمة
Python · Streamlit · LangChain · FAISS · Groq (LLM) · HuggingFace Embeddings
## ما يمكنني تقديمه لك
- بناء نسخة مخصصة من هذا النظام تعمل على مستنداتك أو مستندات عملائك
- دمج النظام داخل موقعك أو تطبيقك الحالي
- تخصيص الشخصية والأسلوب الذي يرد به الروبوت (رسمي، ودود، تقني، إلخ)
- إضافة ميزات إضافية حسب الحاجة: الاستشهاد بمصدر الإجابة (رقم الصفحة/الملف)، دعم لغات متعددة، ذاكرة محادثة دائمة، بحث هجين لتحسين دقة النتائج