استخراج بيانات الكتب من فئة Classics باستخدام Web Scraping
تفاصيل العمل
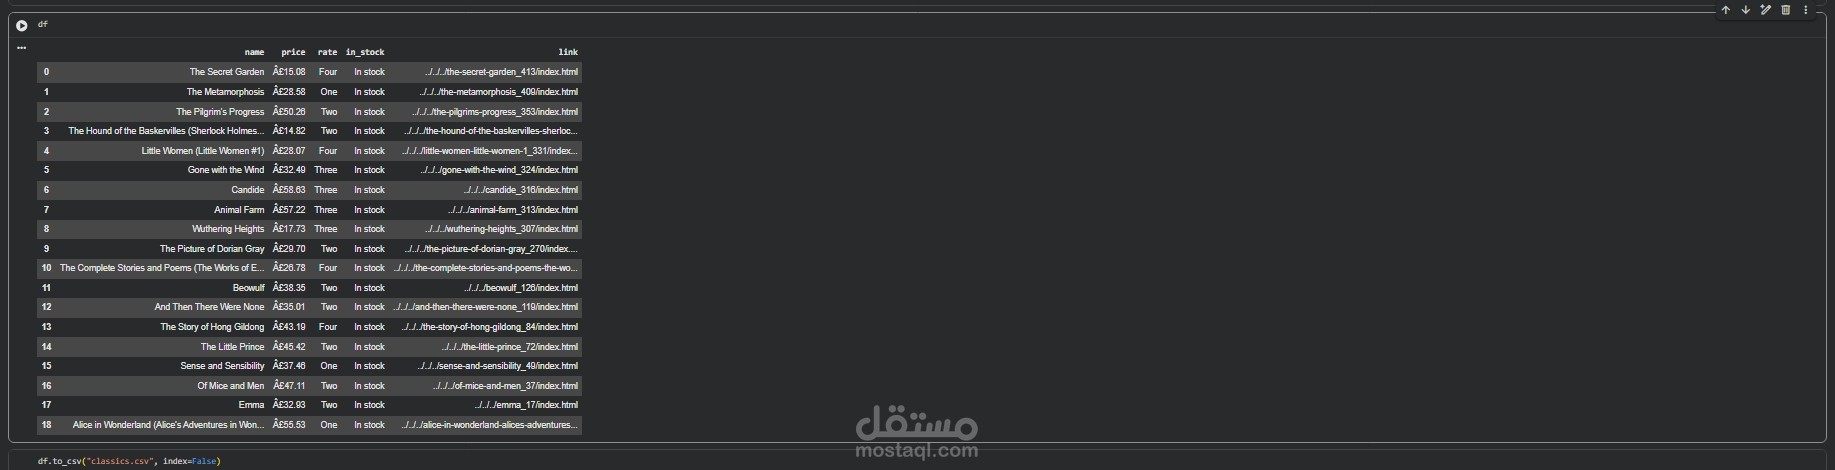
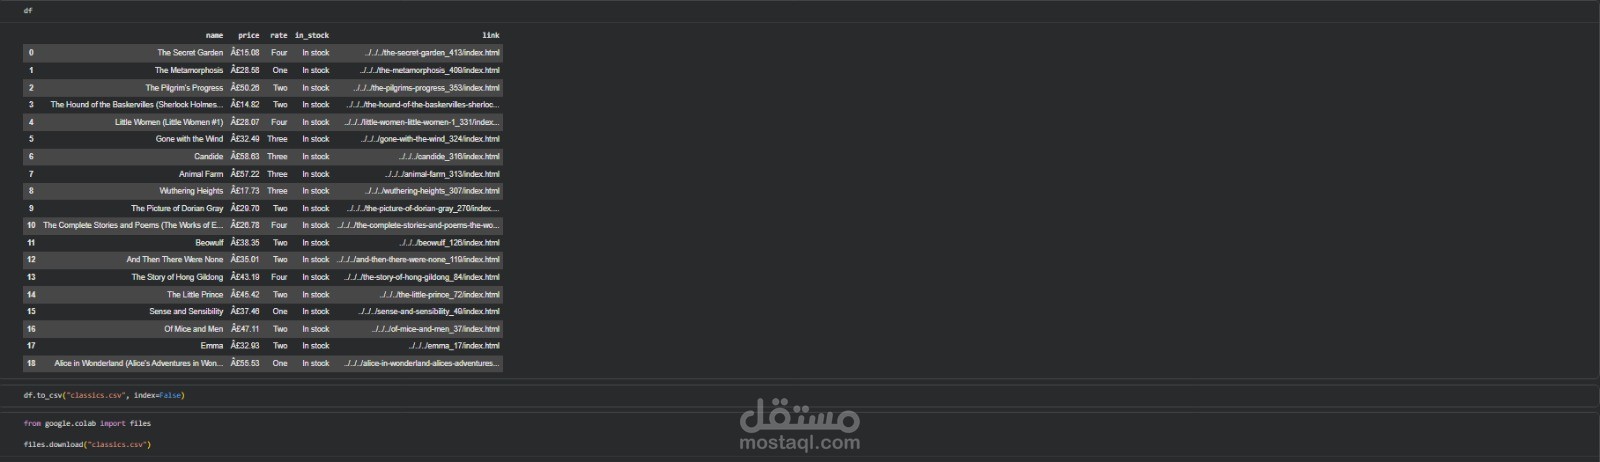
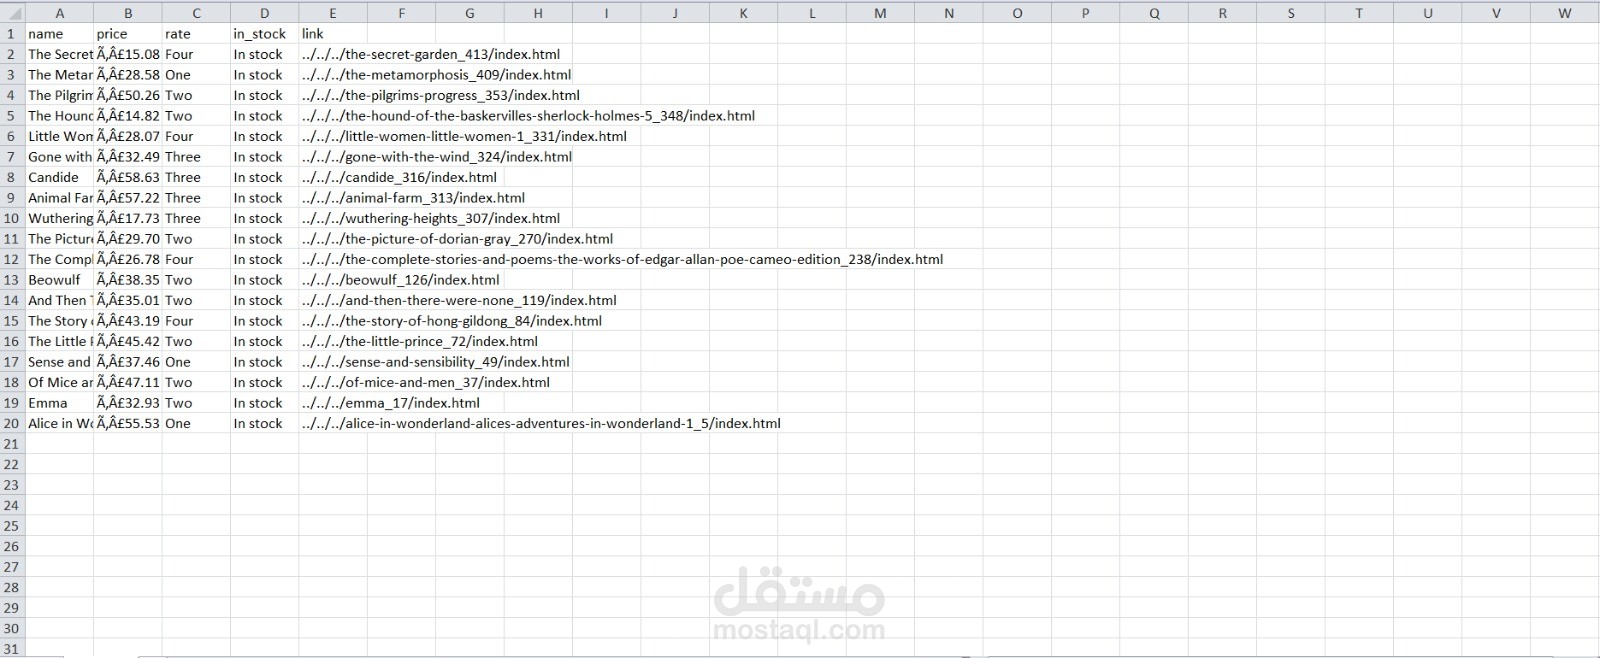
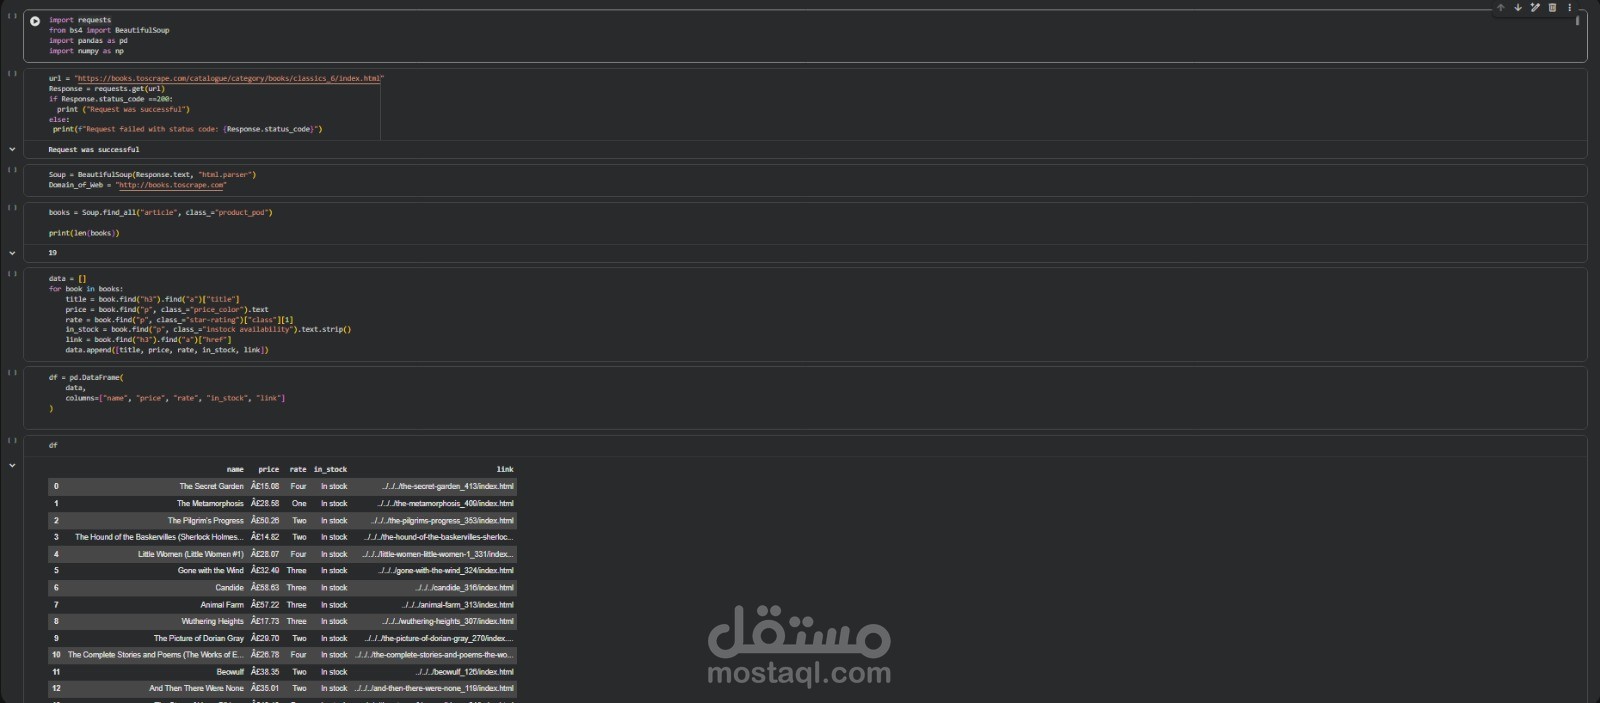
نفذت مشروع Web Scraping لاستخراج بيانات الكتب من فئة Classics في موقع Books to Scrape. قمت بإنشاء HTML Parser للوصول إلى بيانات الكتب واستخراج المعلومات المطلوبة من صفحات الموقع، ثم تنظيم البيانات وتجهيزها في ملف Excel/CSV بشكل واضح وسهل الاستخدام. شملت البيانات المستخرجة اسم الكتاب، السعر، التقييم، حالة التوفر، ورابط الكتاب. استخدمت Python وأدوات تحليل ومعالجة صفحات HTML لتنفيذ عملية الاستخراج وتنظيم النتائج. يوضح المشروع قدرتي على التعامل مع صفحات الويب واستخراج البيانات منها وتحويلها إلى بيانات منظمة يمكن استخدامها لاحقًا في التحليل أو المعالجة.