RecoveryPath AI | مساعد ذكي متعدد اللغات باستخدام RAG
تفاصيل العمل
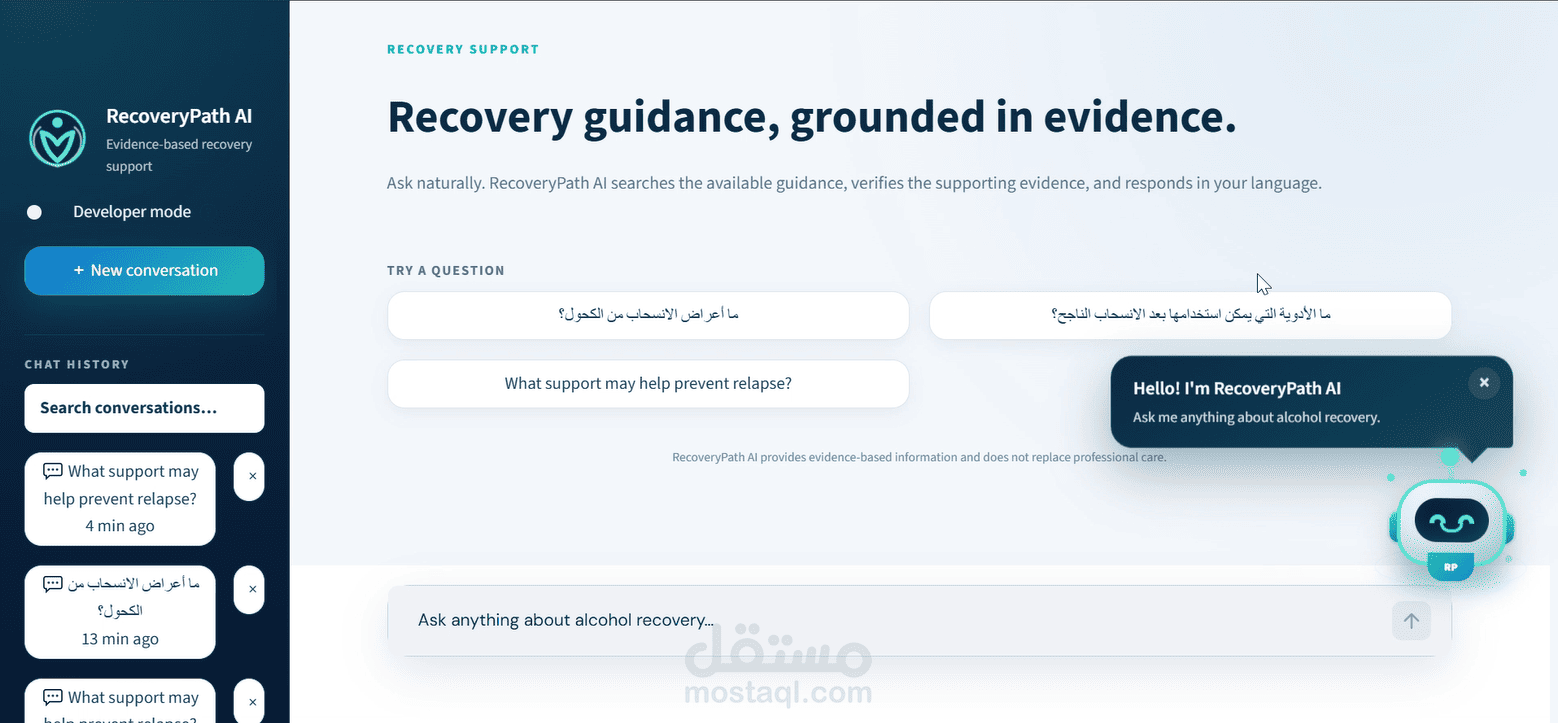
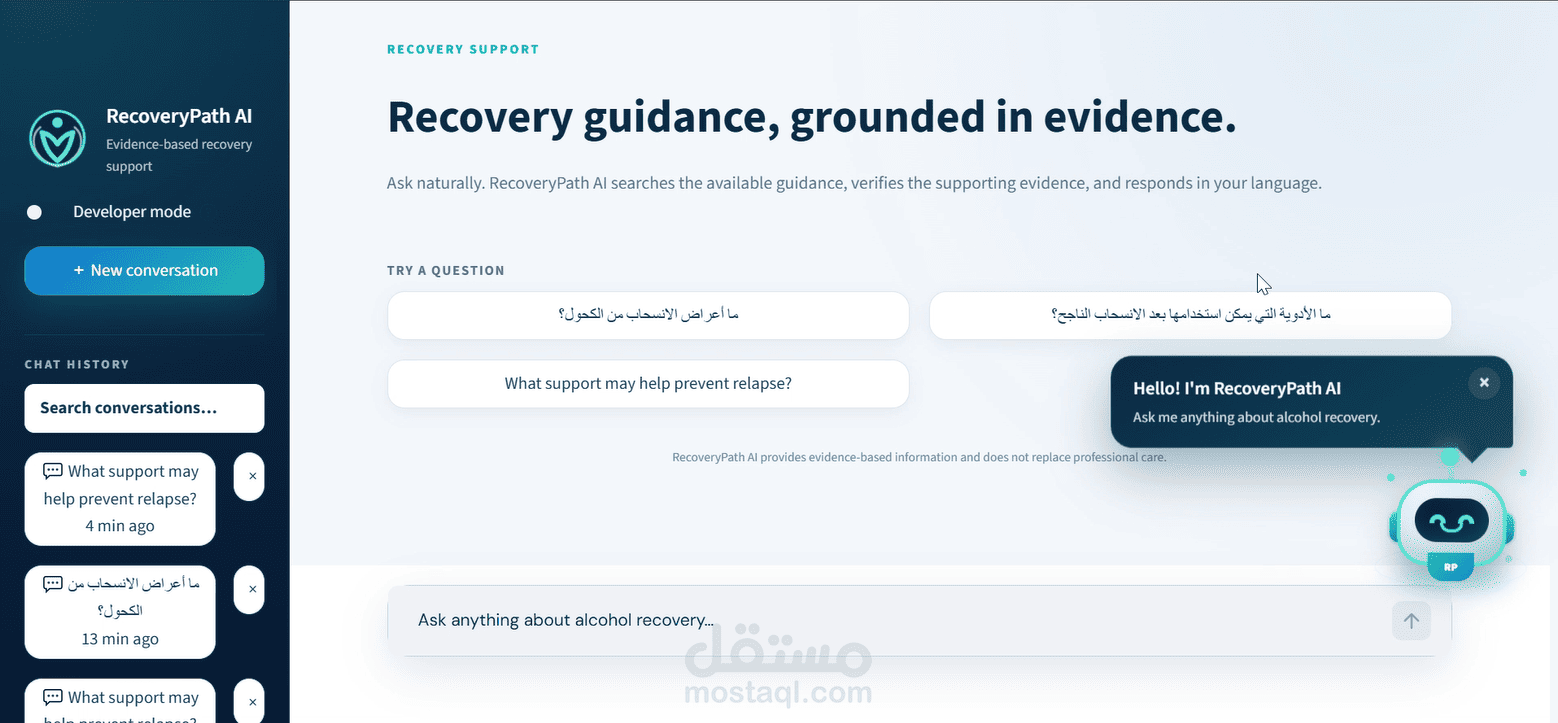
RecoveryPath AI هو مساعد ذكي متعدد اللغات، تم تطويره باستخدام تقنية RAG بهدف استرجاع المعلومات من مستندات ومصادر موثوقة، ثم تقديم إجابات مرتبطة بالأدلة والمراجع المتاحة داخل قاعدة المعرفة.
قمت بتطوير Backend المشروع باستخدام Python وFastAPI، مع استخدام PostgreSQL وpgvector لتخزين البيانات والتمثيلات المتجهية، واستخدام PyMuPDF لاستخراج النصوص من ملفات PDF وتجهيزها لمرحلة المعالجة والاسترجاع.
يبدأ سير العمل برفع ملفات PDF، ثم استخراج النصوص وتنظيفها وتقسيمها باستخدام Semantic Chunking، وبعد ذلك يتم إنشاء Embeddings وتخزينها داخل قاعدة البيانات المتجهية. وعند استقبال سؤال من المستخدم، يبحث النظام عن أكثر أجزاء المستندات ارتباطًا بالسؤال ويستخدمها لتوليد إجابة واضحة ومدعومة بالمصادر.
يتضمن المشروع نظام Hybrid Retrieval يجمع بين أكثر من طريقة للبحث، مع دمج النتائج باستخدام Reciprocal Rank Fusion، ثم إعادة ترتيب الأجزاء المسترجعة باستخدام Cohere Reranking للوصول إلى السياق الأكثر ارتباطًا بسؤال المستخدم قبل إرساله إلى نموذج اللغة.
أهم الخصائص التي تم تنفيذها:
• دعم الأسئلة والمحتوى باللغتين العربية والإنجليزية.
• استخراج النصوص من ملفات PDF باستخدام PyMuPDF.
• تنظيف النصوص وتجهيزها للمعالجة والاسترجاع.
• تقسيم المحتوى دلاليًا باستخدام Semantic Chunking.
• إنشاء Embeddings للمحتوى وتخزينها في قاعدة بيانات متجهية.
• استخدام PostgreSQL وpgvector لإدارة البيانات والبحث المتجهي.
• تنفيذ Hybrid Retrieval لتحسين دقة نتائج البحث.
• دمج نتائج الاسترجاع باستخدام Reciprocal Rank Fusion.
• إعادة ترتيب النتائج باستخدام Cohere Reranking.
• توليد الإجابات باستخدام نماذج اللغة عبر Groq.
• التحقق من ارتباط الادعاءات بالمصادر المسترجعة.
• التحقق من صحة الاستشهادات والبيانات الوصفية.
• تقييم قوة الأدلة قبل تقديم الإجابة للمستخدم.
• إظهار المصادر والمراجع المستخدمة في تكوين الإجابة.
• تقديم رفض آمن وسياقي عندما لا تتوفر أدلة كافية.
• تطوير REST APIs باستخدام FastAPI.
• استخدام Streamlit لتطوير واجهة استخدام تفاعلية.
• تنظيم مكونات المشروع بطريقة قابلة للصيانة والتطوير.
• دعم إضافة مستندات ومصادر جديدة إلى قاعدة المعرفة.
ركزت أثناء تطوير المشروع على تحسين دقة الاسترجاع، وتقليل الإجابات غير المدعومة، وربط كل إجابة بالمصادر المتاحة، وتقديم تجربة استخدام واضحة تدعم المحتوى العربي والإنجليزي.
تم تصميم النظام على شكل مكونات منفصلة تشمل معالجة الملفات، وتقسيم المحتوى، وإنشاء Embeddings، وتخزين البيانات، واسترجاع المعلومات، وإعادة ترتيب النتائج، والتحقق من الأدلة، وتوليد الإجابة النهائية.