Web Scraping & Data Collection
تفاصيل العمل
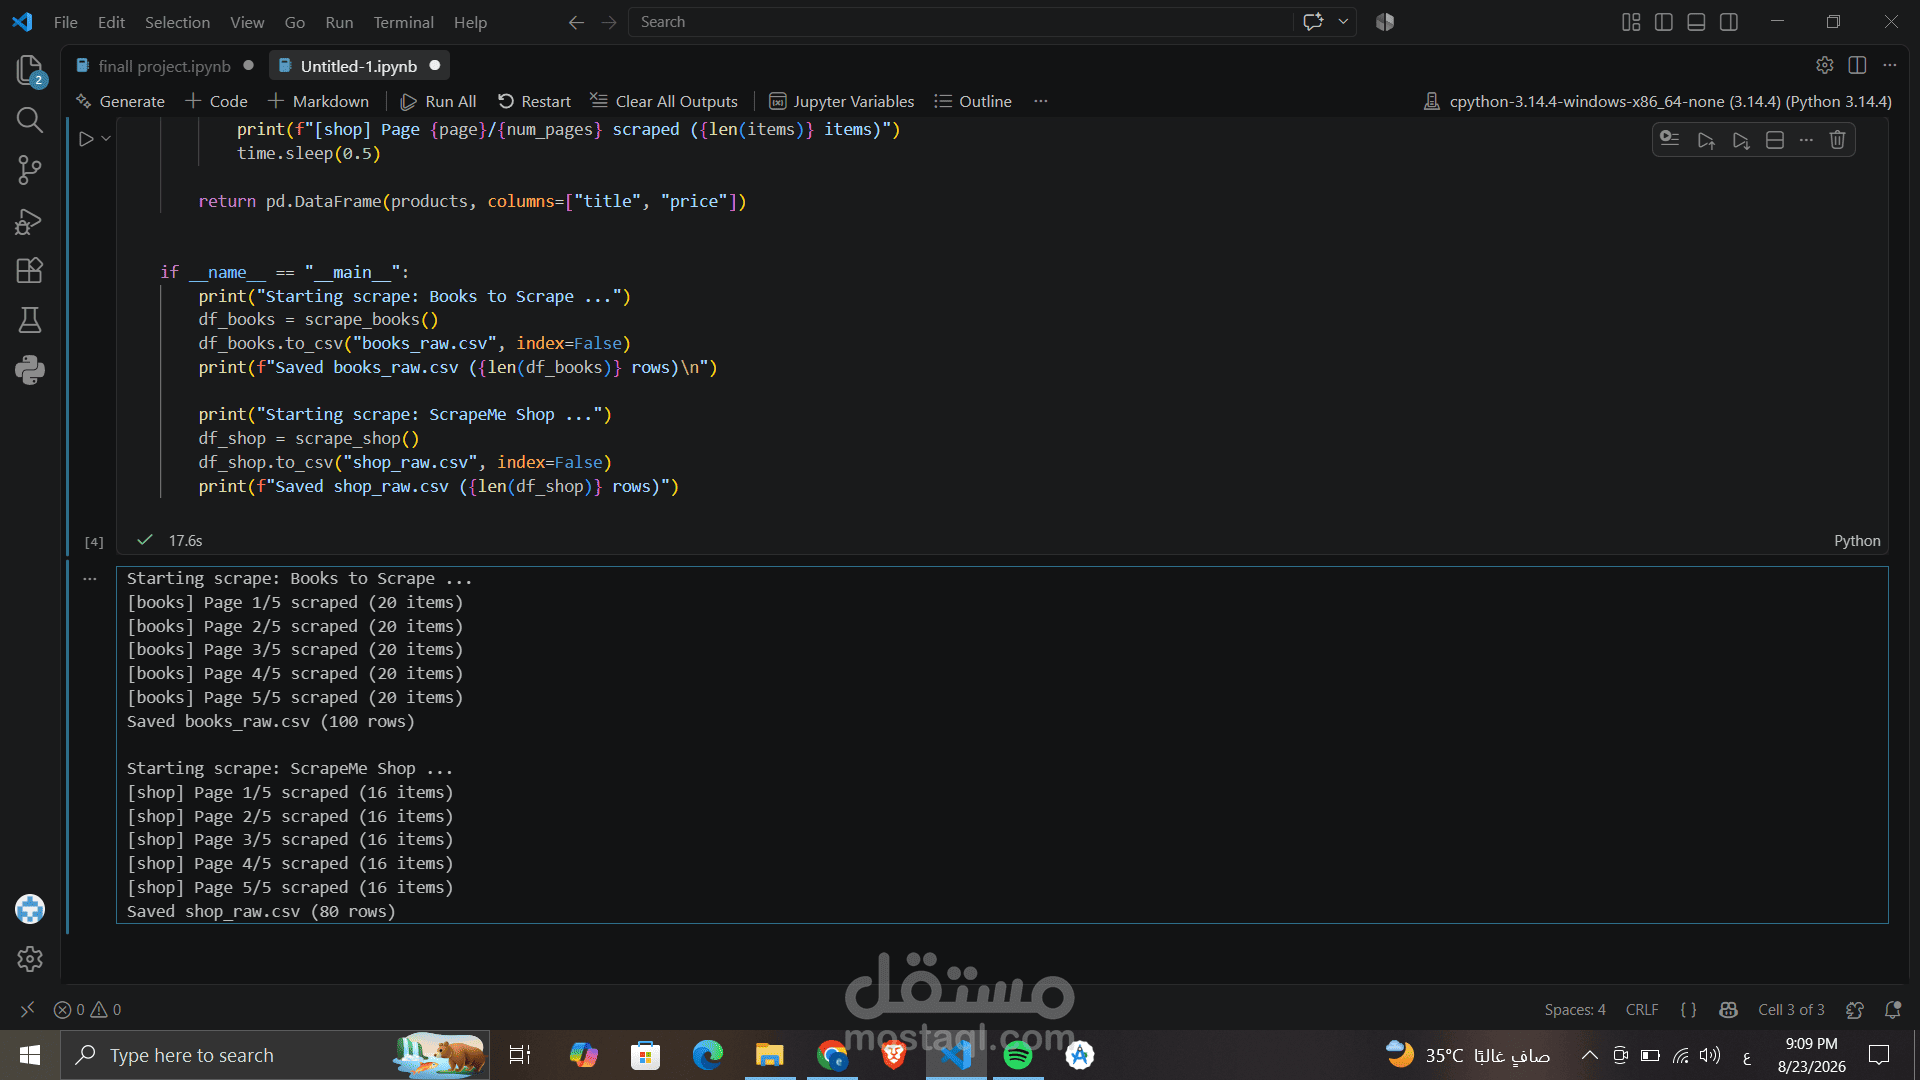
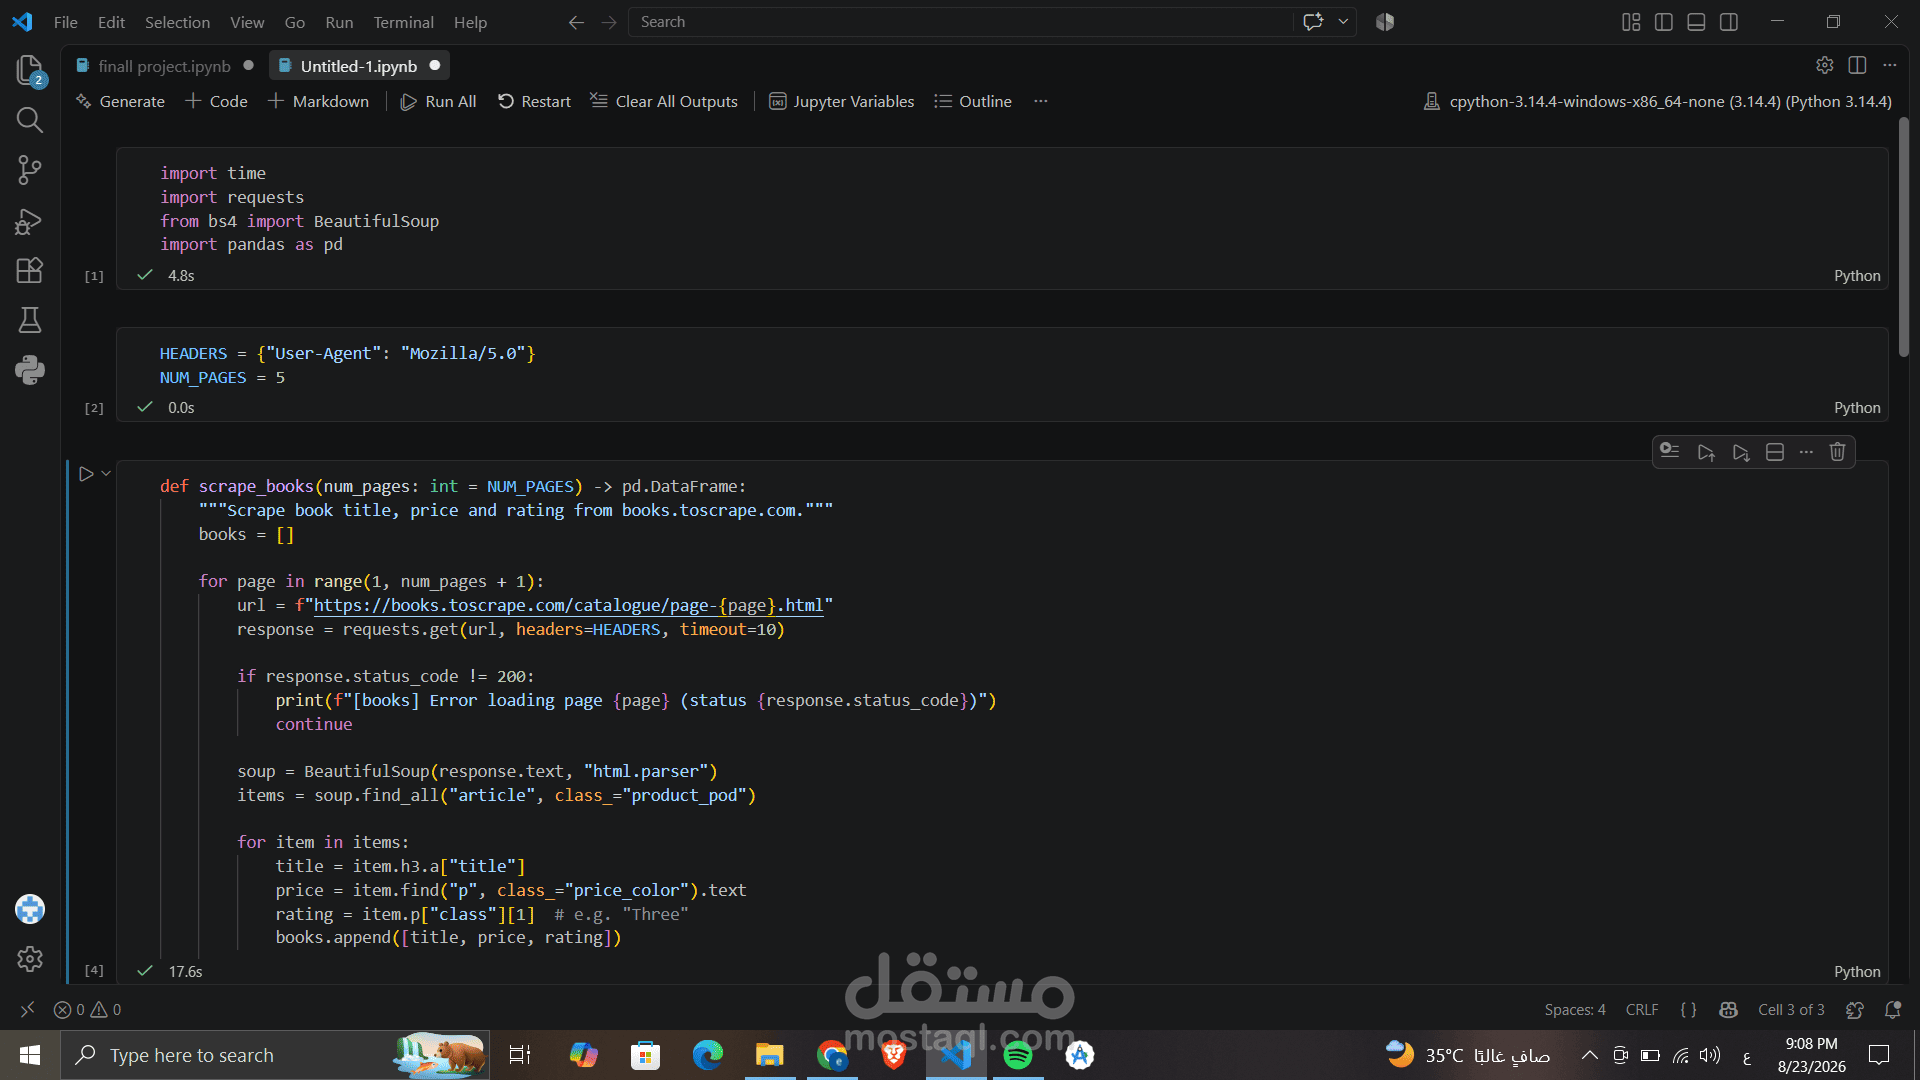
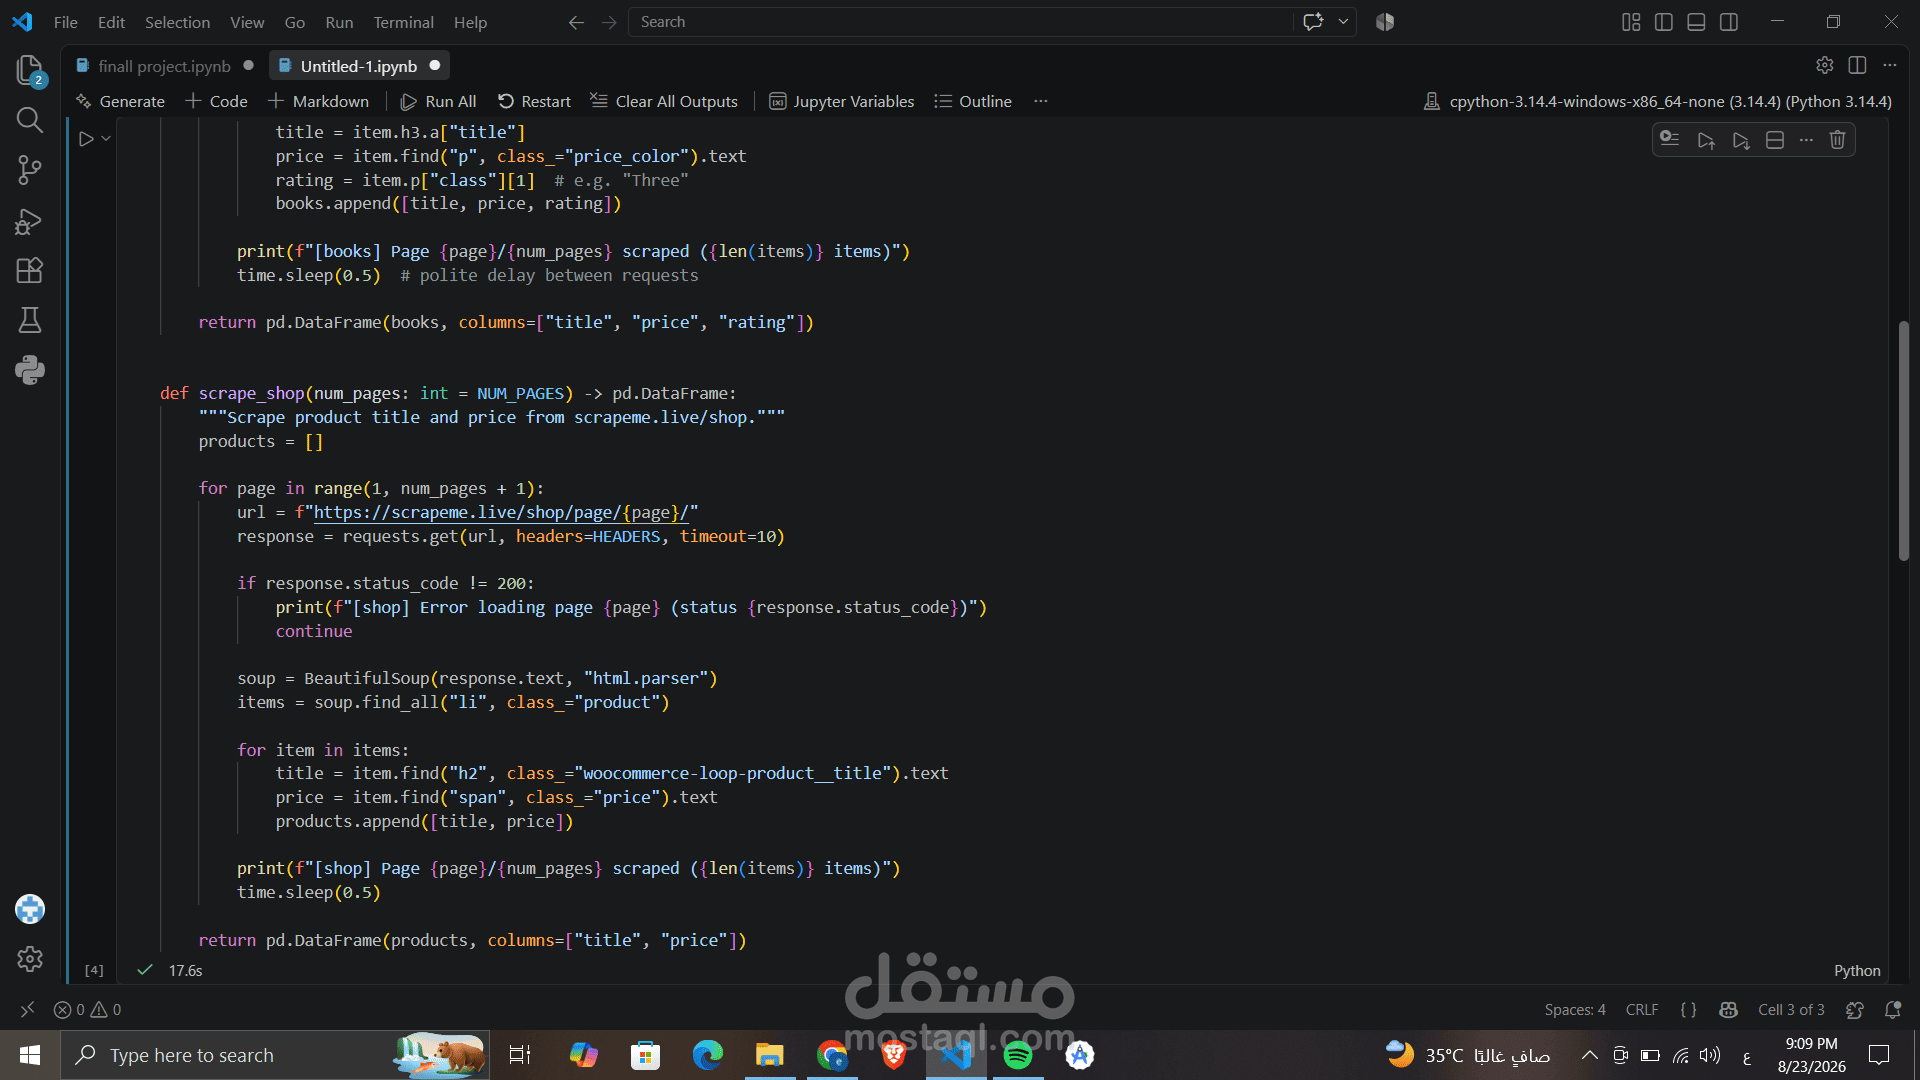
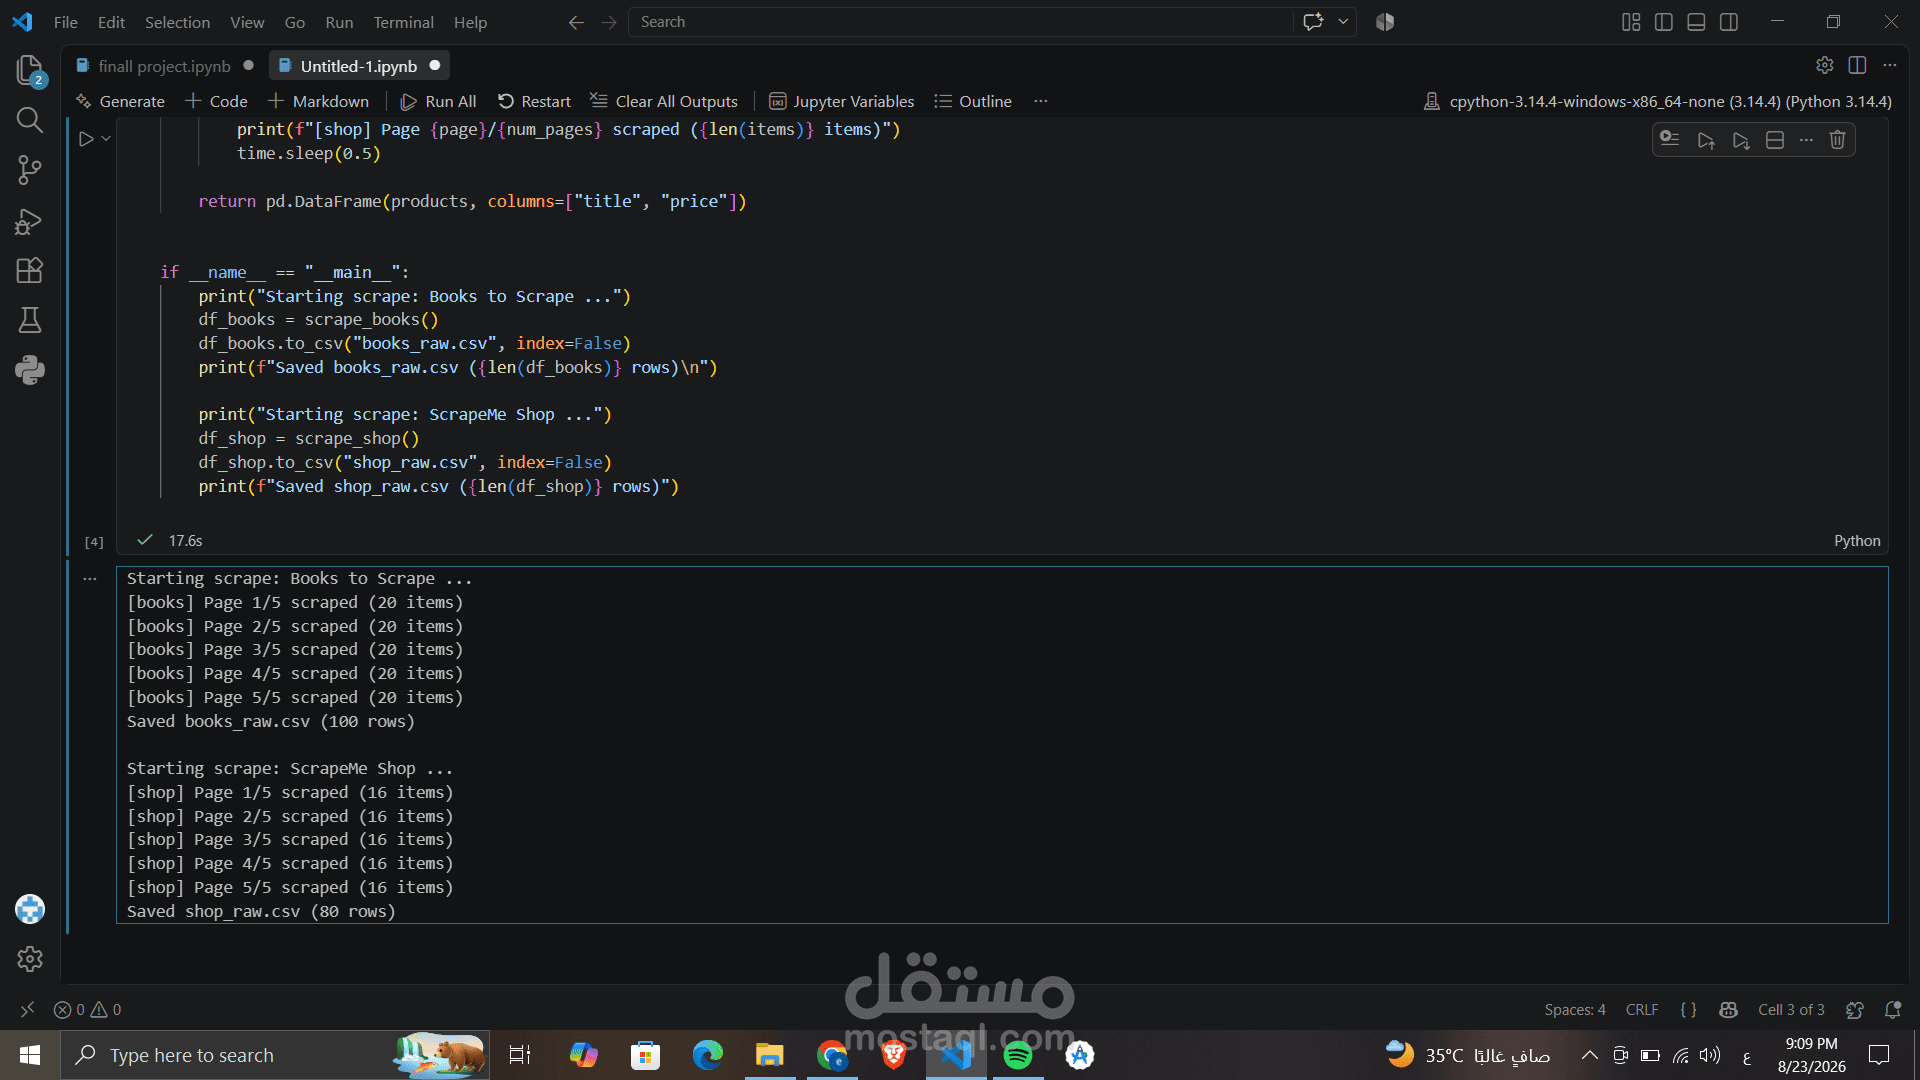
مشروع لاستخراج البيانات من مواقع الويب باستخدام Python، حيث تم تطوير برنامج Web Scraping باستخدام مكتبات Requests وBeautifulSoup لجمع البيانات من صفحات متعددة بشكل آلي.
يقوم المشروع باستخراج بيانات الكتب مثل العنوان والسعر والتقييم من موقع Books to Scrape، بالإضافة إلى استخراج اسم المنتج والسعر من موقع ScrapeMe Shop. يدعم البرنامج التعامل مع عدة صفحات والتحقق من حالة استجابة الموقع قبل معالجة البيانات.
بعد استخراج البيانات، يتم استخدام مكتبة Pandas لتنظيم البيانات وتحويلها إلى DataFrame، ثم حفظ النتائج في ملفات CSV لاستخدامها لاحقًا في التحليل أو المعالجة.
تم تنفيذ عملية الاستخراج على 5 صفحات من كل موقع، ونتج عنها 100 سجل للكتب و80 سجلًا للمنتجات.