Multi-PDF RAG Chatbot
تفاصيل العمل
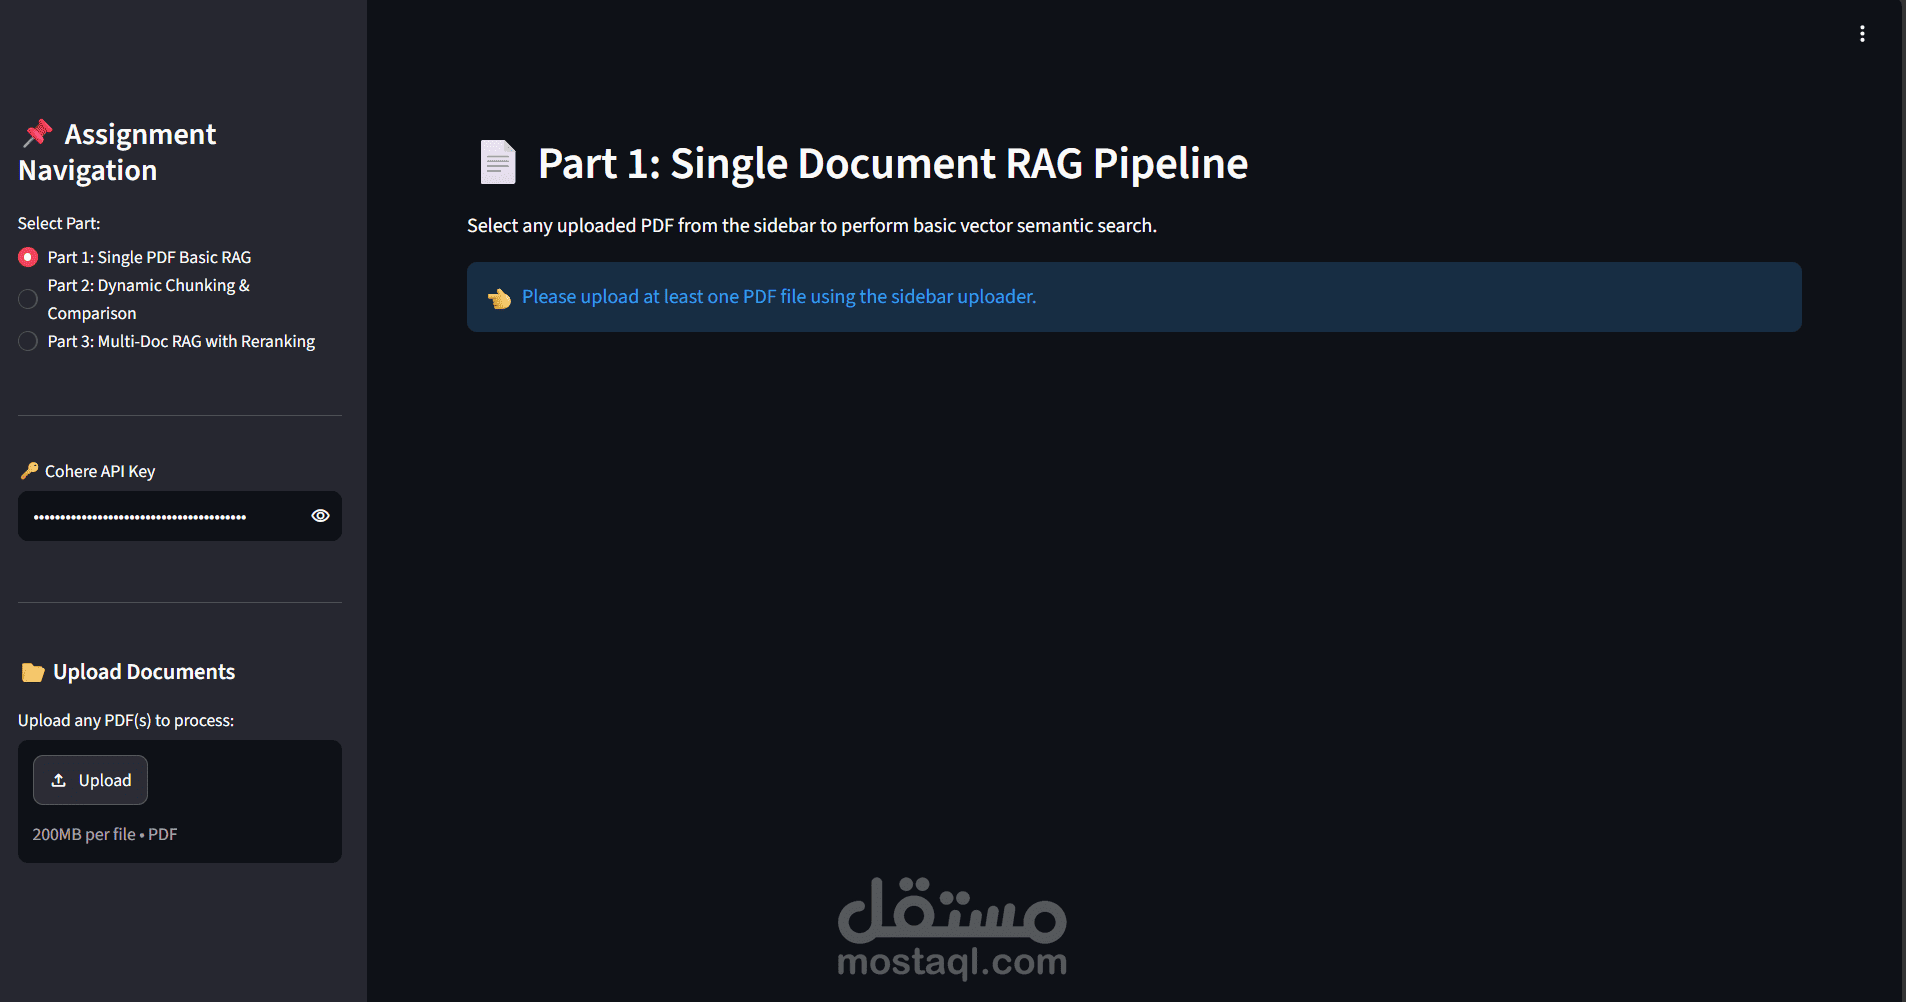
تطوير نظام شات بوت معالج للبيانات ومتقدم يعتمد على معماريّة Retrieval-Augmented Generation (RAG) لتمكين المستخدمين والشركات من استخراج المعرفة، والتحليل الدلالي، والإجابة الدقيقة على الأسئلة المعقدة من خلال رفع مجموعة متعددة من ملفات الـ PDF في وقت واحد.
حلّ هذا النظام مشكلة القيود على عدد الكلمات (Context Window Constraints) والهلوسة اللغوية (Hallucinations) التي تعاني منها النماذج اللغوية التقليدية، من خلال ربط النموذج بمصدر بيانات خارجي موثوق ومخصص.
المميزات والحلول التقنية المطبقة:
معالجة وتقطيع النصوص (Document Parsing & Chunking):
استخراج النصوص من الملفات المرفوعة وتطبيق استراتيجيات تقطيع متقدمة (Recursive Character Text Splitting) للحفاظ على السياق والمعنى الدلالي للجمل قبل عملية التجميع.
البحث الدلالي وتخزين المتجهات (Vector Embeddings & Storage):
تحويل أجزاء النصوص إلى متجهات رياضية (Embeddings) عبر نماذج متطورة من Hugging Face، وتخزينها في قاعدة بيانات متجهة مثل (ChromaDB / FAISS) لضمان استرجاع المعلومات واستعلامها بسرعة فائقة (High-Performance Similarity Search).
دقة الاسترجاع وإعادة الترتيب (Advanced Retrieval & Re-ranking):
تحسين جودة الإجابات ودقتها عبر دمج تقنيات Cohere Re-ranking للتقليل من الضوضاء النصية، وضمان اختيار أكثر الأجزاء صلةً بالاستفسار قبل إرسالها إلى النموذج اللغوي (LLM).
تتبع سياق الحوار (Conversational Context & History):
دعم الذاكرة الممتدة (Conversation Buffer Window) للدردشة، مما يتيح للشات بوت متابعة الأسئلة المترابطة وفهم الضمائر والسياق المترابط عبر الحوار.
واجهة مستخدم تفاعلية (Interactive UI):
بناء واجهة مستخدم سلسة وعصرية باستخدام Streamlit توفر خيارات رفع الملفات، متابعة حالة المعالجة لحظياً، وعرض الإجابات مع توثيق المصدر الداخلي (Source Citation) من داخل الملفات المرفوعة.
التقنيات والأدوات المستخدمة (Tech Stack):
اللغة: Python
إطار الـ RAG والـ LLMs: LangChain, Hugging Face Transformers
نماذج اللغات والمتجهات: Cohere, Sentence-Transformers
قواعد البيانات المتجهة: ChromaDB / FAISS
واجهة المستخدم: Streamlit