Named Entity Recognition (NER) with Transformers and BiLSTM Attention
تفاصيل العمل
وصف المشروع:
مشروع متقدم في مجال معالجة اللغات الطبيعية (NLP) يهدف إلى بناء وتدريب نماذج تصنيف الكيانات المسماة (Named Entity Recognition - Many-to-Many Token Classification) للتعرف على أسماء الأشخاص والمؤسسات بدقة على مستوى كل كلمة (Token Level). يتضمن المشروع بناء وتخصيص معماريتين متقدمتين برمجياً باستخدام PyTorch: الأولى تعتمد على مشفرات المحولات (Transformer Encoders)، والثانية تعتمد على شبكات الذاكرة ثنائية الاتجاه مع آليات الانتباه المتعددة (BiLSTM + Multi-Head Self-Attention)، مع استخدام متجهات التضمين اللغوي المدربة مسبقاً (GloVeEmbeddings).
الميزات والمهام المنجزة في المشروع:
هندسة البيانات والمعاجم اللغوية: بناء معجم تدريبي مخصص، ومعالجة التبطين الديناميكي للنصوص (Dynamic Padding & Attention Masking) لضمان كفاءة معالجة الجمل متغيرة الأطوال.
دمج التضمين الدلالي (Pretrained GloVe Embeddings): دمج مصفوفات التضمين اللغوي (GloVe 100d) لتمثيل الكلمات دلالياً قبل تمريرها للشبكات العصبية.
بناء نموذج BiLSTM + Multihead Attention: تصميم طبقات LSTM ثنائية الاتجاه مدمجة مع طبقة انتباه ذاتي متعددة الرؤوس والـ Residual Connections لالتقاط العلاقات السياقية الطويلة بين الكلمات.
تنفيذ معمارية Transformer Encoder مخصصة: بناء نظام تشفير يعتمد على تضمين المواضع (Positional Encoding) وطبقات الـ Self-Attention مع تخصيص طبقة التصنيف لتوليد التوقعات المباشرة لكل رمز (Token Logits) دون الحاجة لتقليص الأبعاد (Pooling).
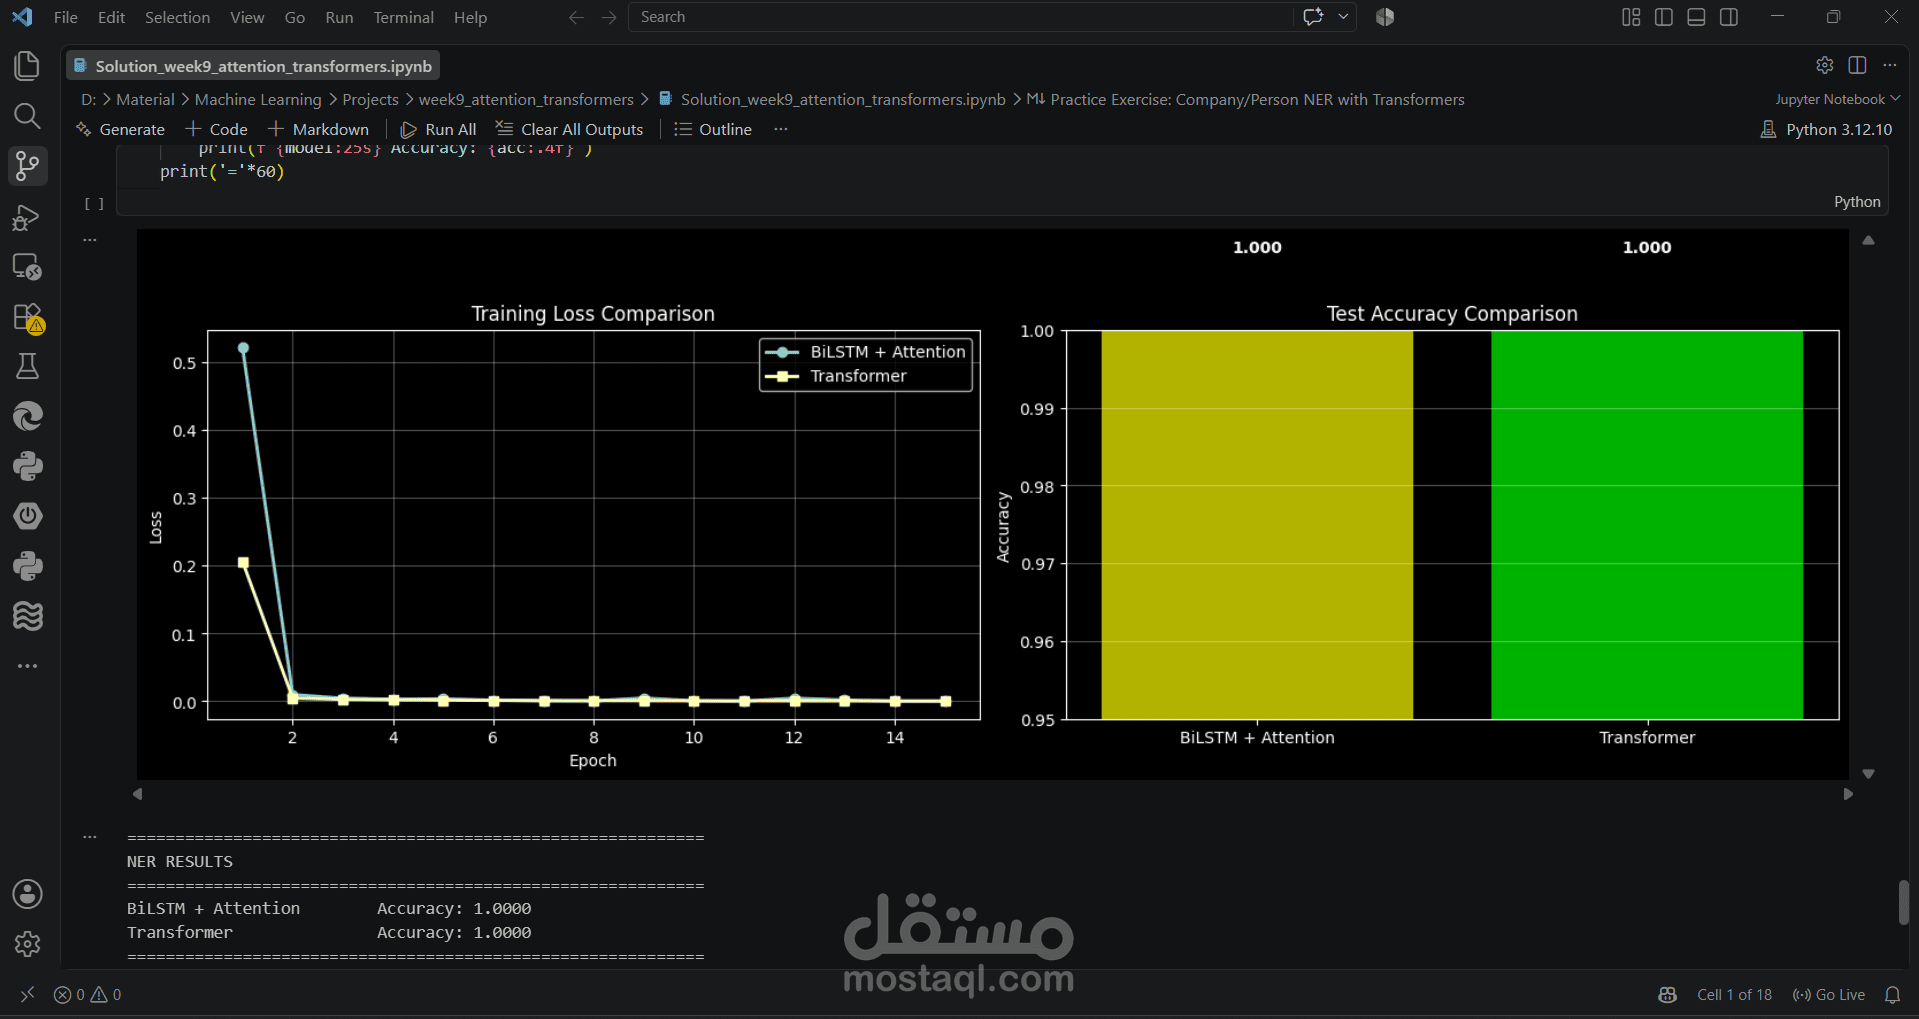
التدريب والتقييم المقارن: تدريب النماذج باستخدام دالة الخسارة CrossEntropyLoss مع استثناء رموز التبطين (ignore_index=-1)، وقياس دقة التنبؤ، وتوليد رسومات بيانية للمقارنة بين سرعة تقارب النماذج (Loss Curves) ودقة الاختبار النهائية.