استخراج بيانات 1000 منتج من موقع إلكتروني باستخدام Python
تفاصيل العمل
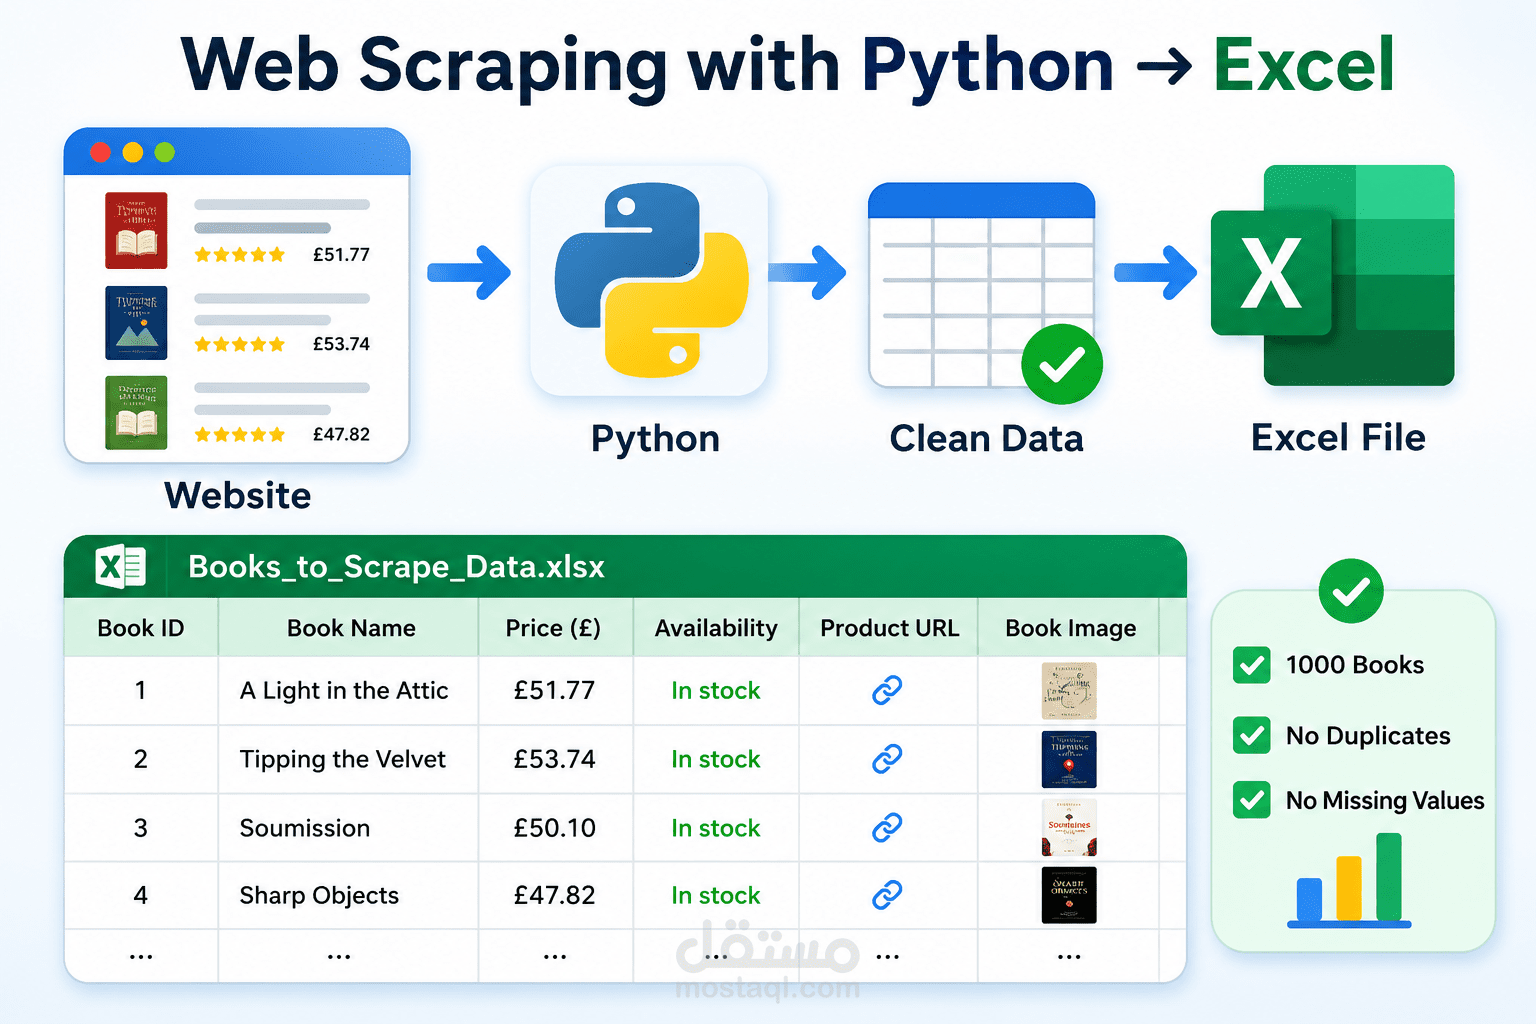
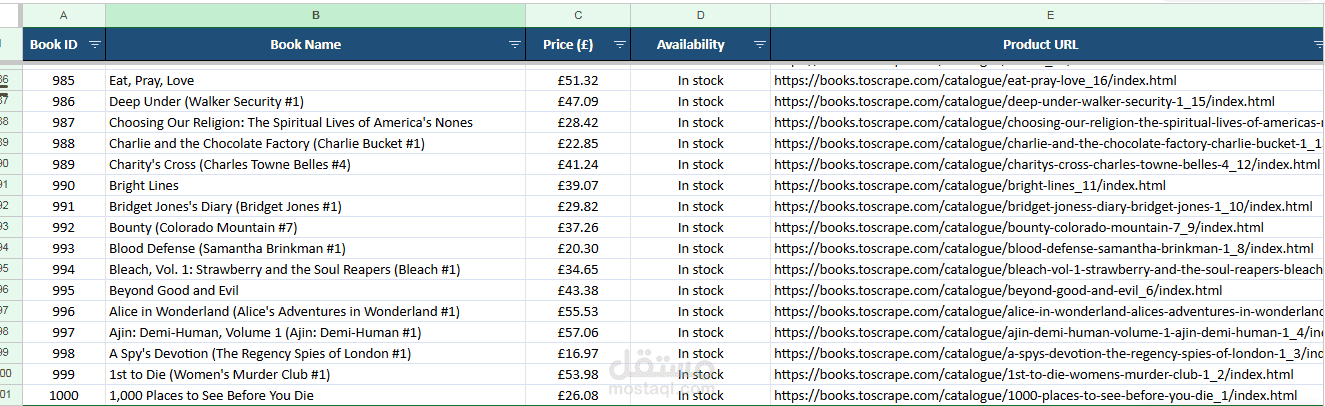
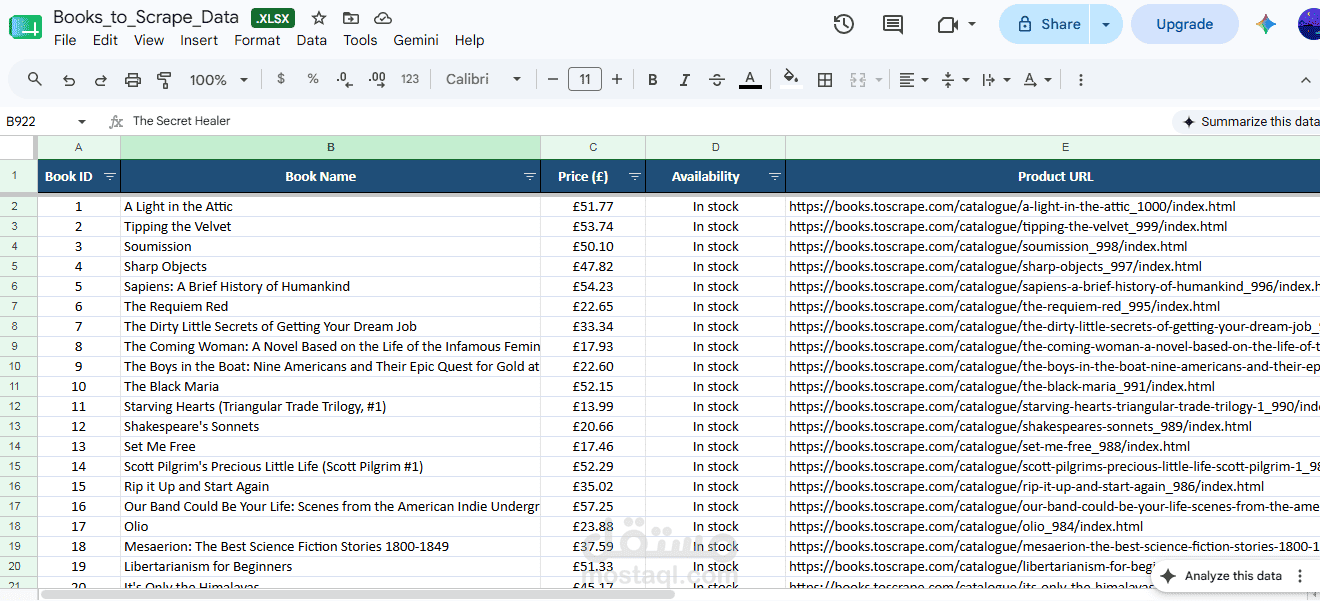
مشروع Web Scraping متكامل لاستخراج بيانات 1000 كتاب من موقع إلكتروني باستخدام Python، وتنظيف البيانات وتجهيزها في ملف Excel منظم.
تم استخراج البيانات التالية لكل كتاب:
• اسم الكتاب
• السعر
• حالة التوفر
• رابط صفحة المنتج
• رابط صورة الكتاب والصورة المصغرة
تم تنفيذ المشروع باستخدام Python ومكتبات BeautifulSoup وRequests وPandas، مع إجراء عمليات تنظيف وفحص شاملة للبيانات للتأكد من:
• عدم وجود بيانات مكررة
• عدم وجود قيم مفقودة
• تنظيم وتنسيق البيانات داخل ملف Excel
• إضافة روابط قابلة للنقر للوصول مباشرة إلى صفحات الكتب
• إمكانية إضافة صور مصغرة للكتب داخل ملف Excel
النتيجة النهائية: ملف Excel منظم يحتوي على بيانات 1000 كتاب، بدون تكرار وبدون قيم مفقودة، وجاهز للاستخدام.