نظام معالجة وتحليل البيانات والتنبؤ الإحصائي (Python)
تفاصيل العمل
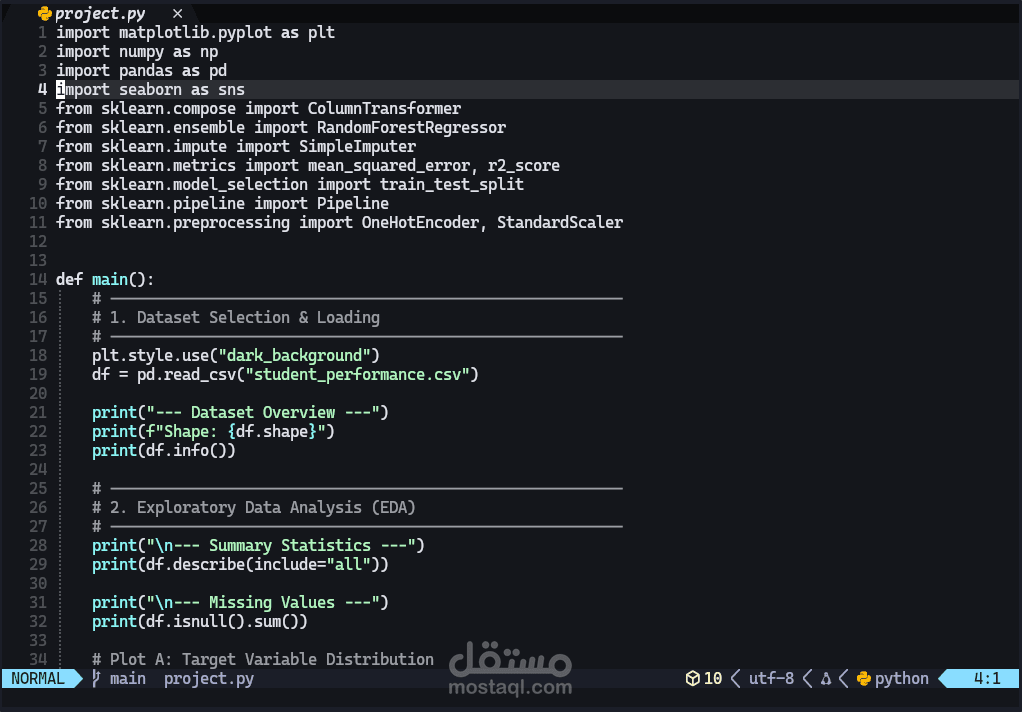
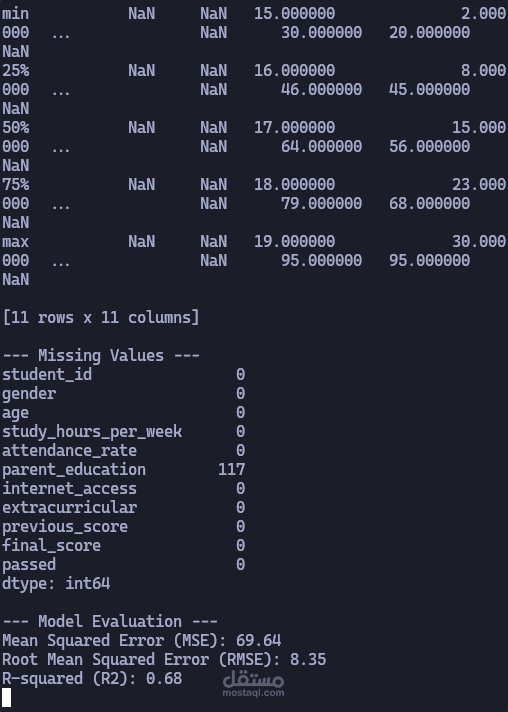
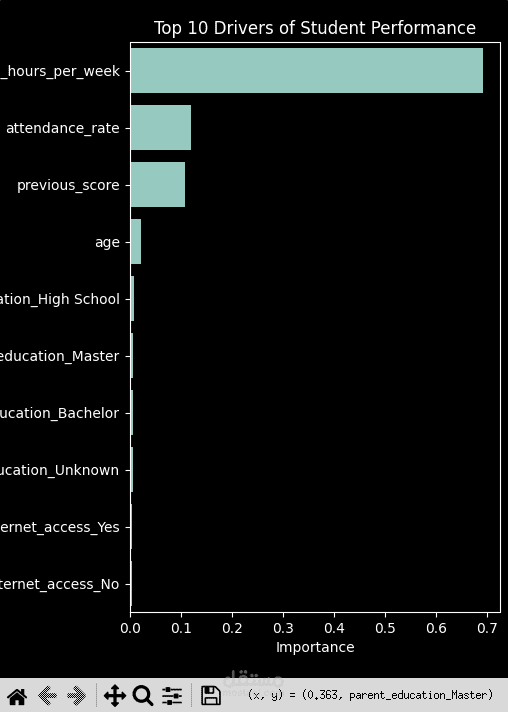
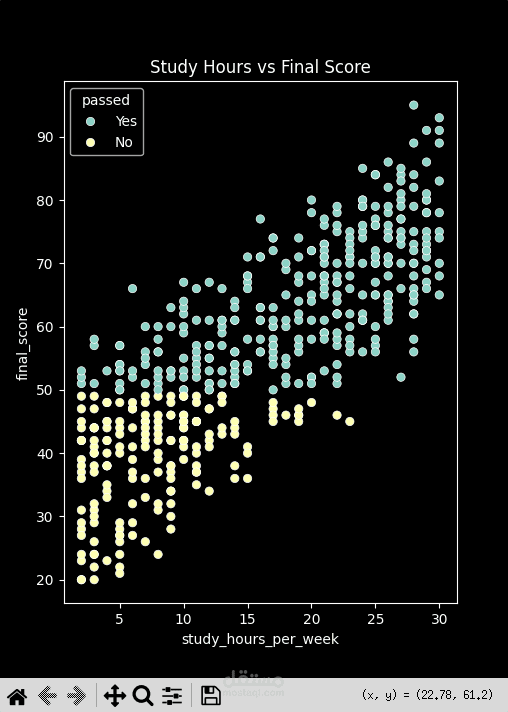
خط معالجة متكامل (Pipeline) مبني بلغة بايثون لتنظيف وتحليل البيانات وتطبيق خوارزميات تعلم الآلة (Machine Learning) للتنبؤ الإحصائي واستخراج المؤشرات الموجهة للأعمال.
أبرز مميزات العمل وطريقة التنفيذ:
- هيكلة وتنظيف البيانات: استخدام مكتبات pandas و numpy لمعالجة القيم المفقودة (Data Imputation) والتعامل مع البيانات النصية والفئات عبر ترميز (One-Hot Encoding) وتنسيقها برمجياً.
- بناء خطوط المعالجة المؤتمتة: تطبيق تقنيات Pipeline و ColumnTransformer من مكتبة scikit-learn لضمان أتمتة تنظيف وتحجيم الميزات (Feature Scaling) دون تداخل أو تسريب للبيانات.
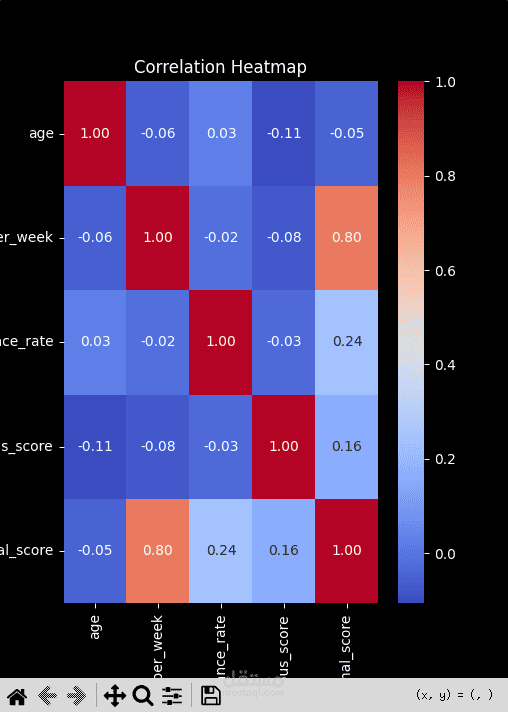
- التحليل البصري واستخراج الأنماط: الاعتماد على أدوات seaborn و matplotlib لتوليد مخططات بيانية تفاعلية (EDA) مثل مصفوفات الارتباط (Correlation Heatmaps) لتقديم رؤى دقيقة وسهلة الفهم.