مشروع تكامل وتحليل البيانات (Data Integration & Analytics Project)
تفاصيل العمل

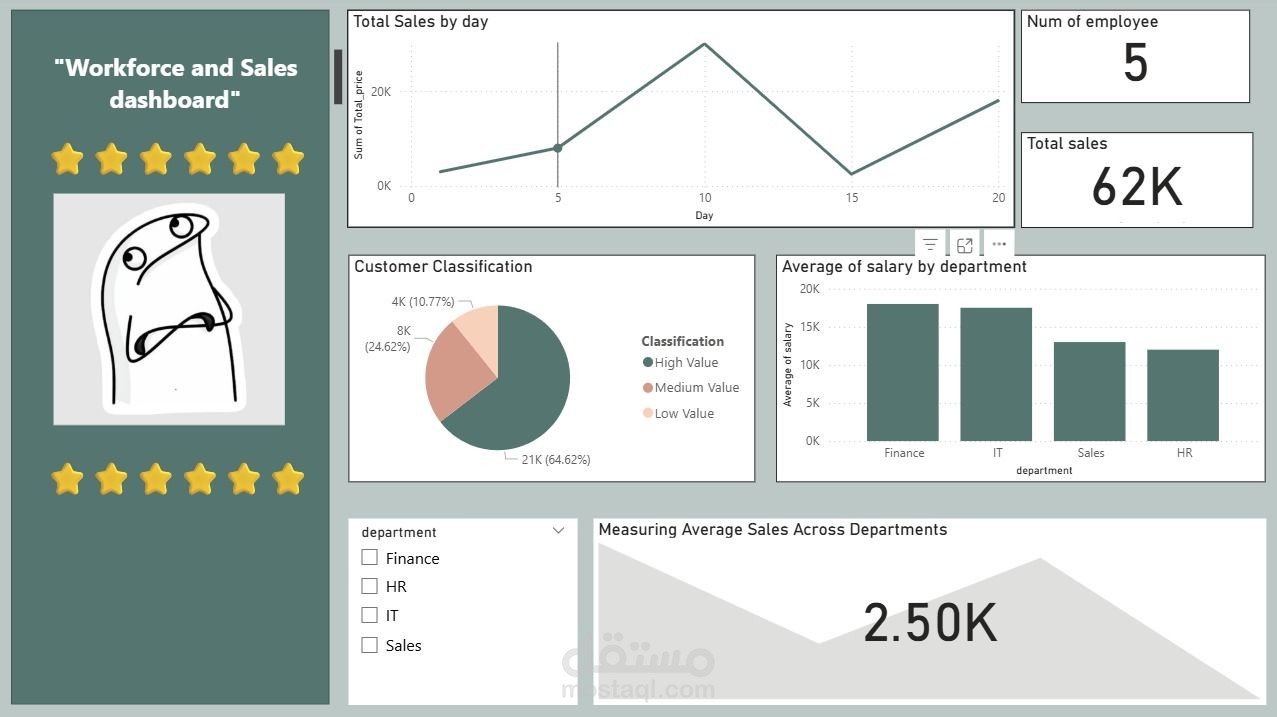
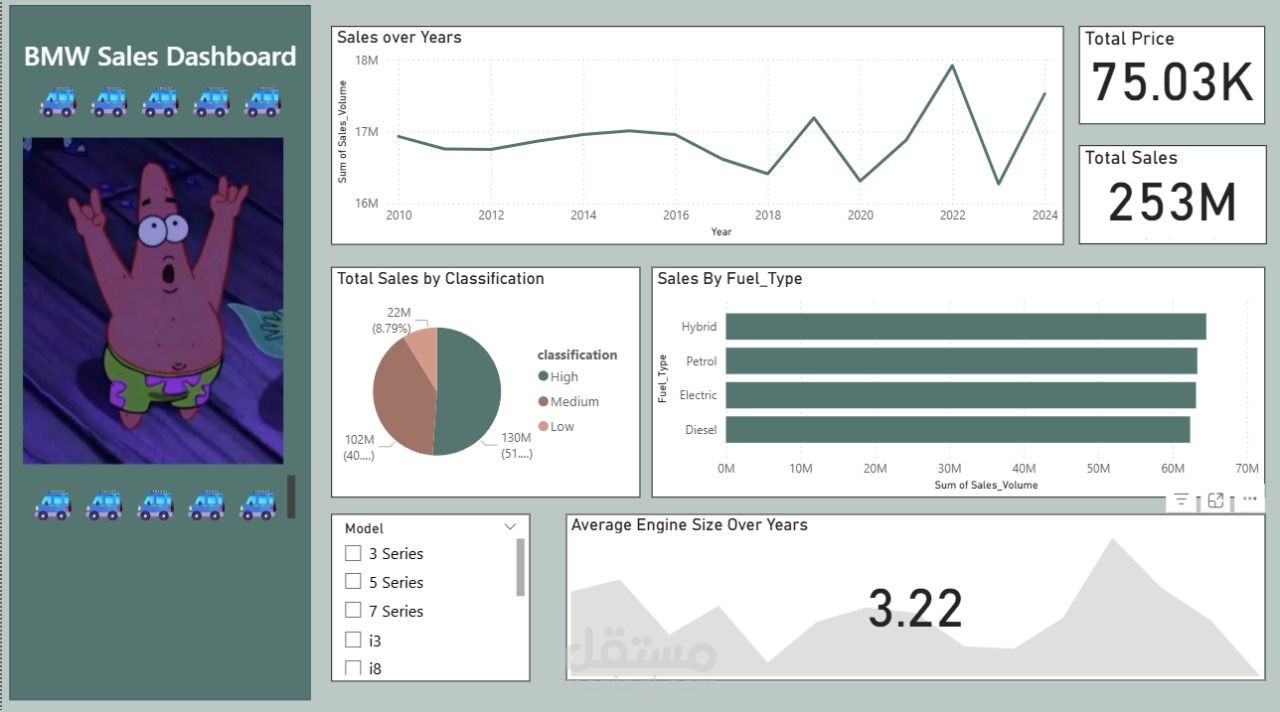
• بناء خط معالجة بيانات متكامل (End-to-End Data Pipeline) لجمع البيانات من مصادر متعددة تشمل ملفات CSV وعمليات Web Scraping وقواعد بيانات MongoDB وSQL Server.
• استخدام Python ومكتبات Pandas وBeautifulSoup لاستخراج البيانات وتنظيفها ومعالجتها.
• تنفيذ عمليات تنظيف وتحويل البيانات، بما في ذلك إزالة البيانات المكررة، ومعالجة القيم المفقودة، وإعادة هيكلة البيانات لتصبح جاهزة للتحليل.
• تخزين البيانات بعد معالجتها داخل قواعد بيانات منظمة باستخدام MongoDB وSQL Server.
• تصميم هيكل قواعد بيانات يحتوي على جداول مترابطة تضمن سهولة الوصول إلى البيانات وإدارتها بكفاءة