تجهيز وهندسة البيانات (Data Preprocessing & Feature Engineering) لبناء نموذج ذكاء اصطناعي.
تفاصيل العمل
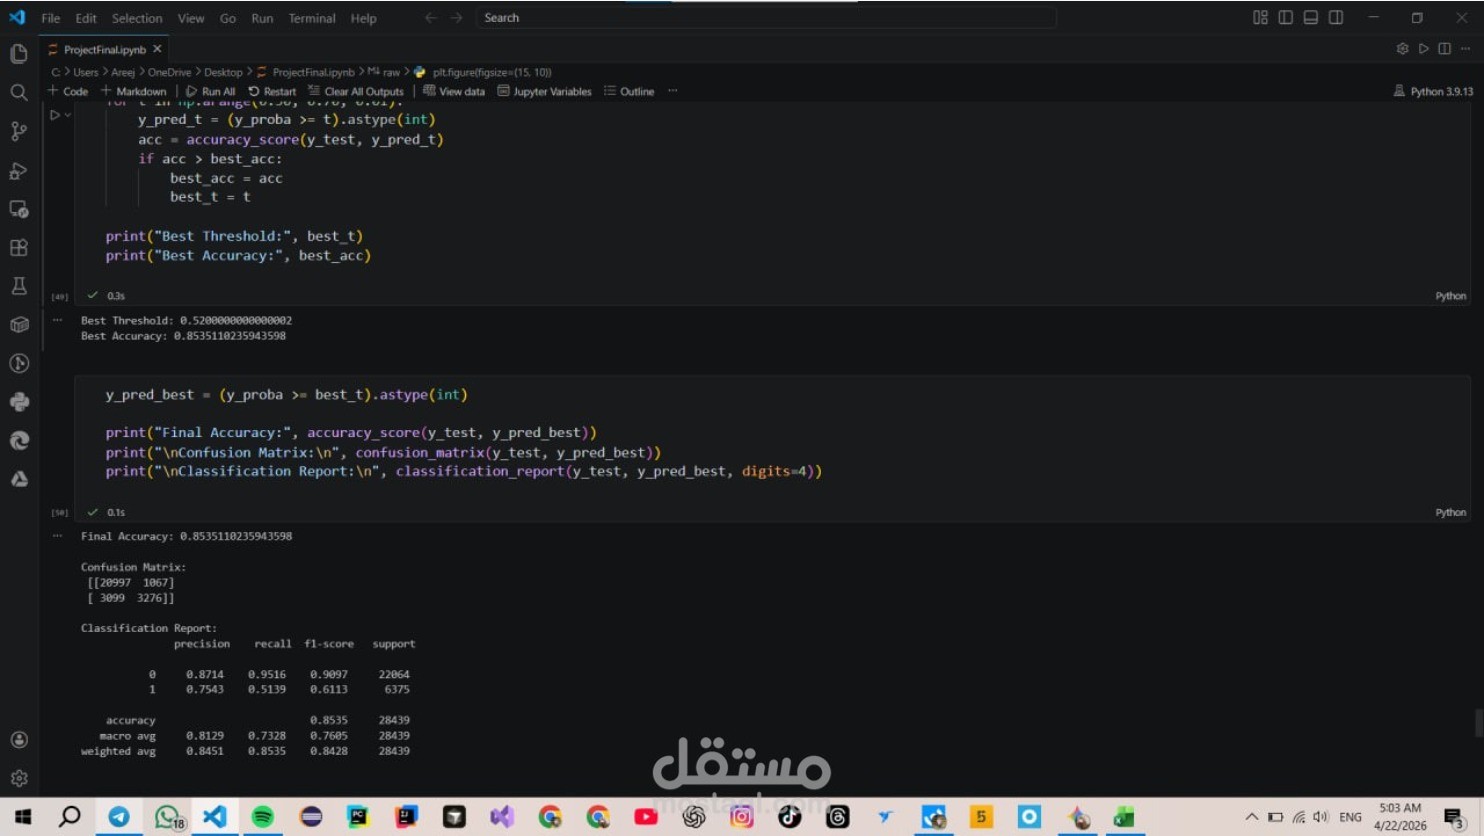
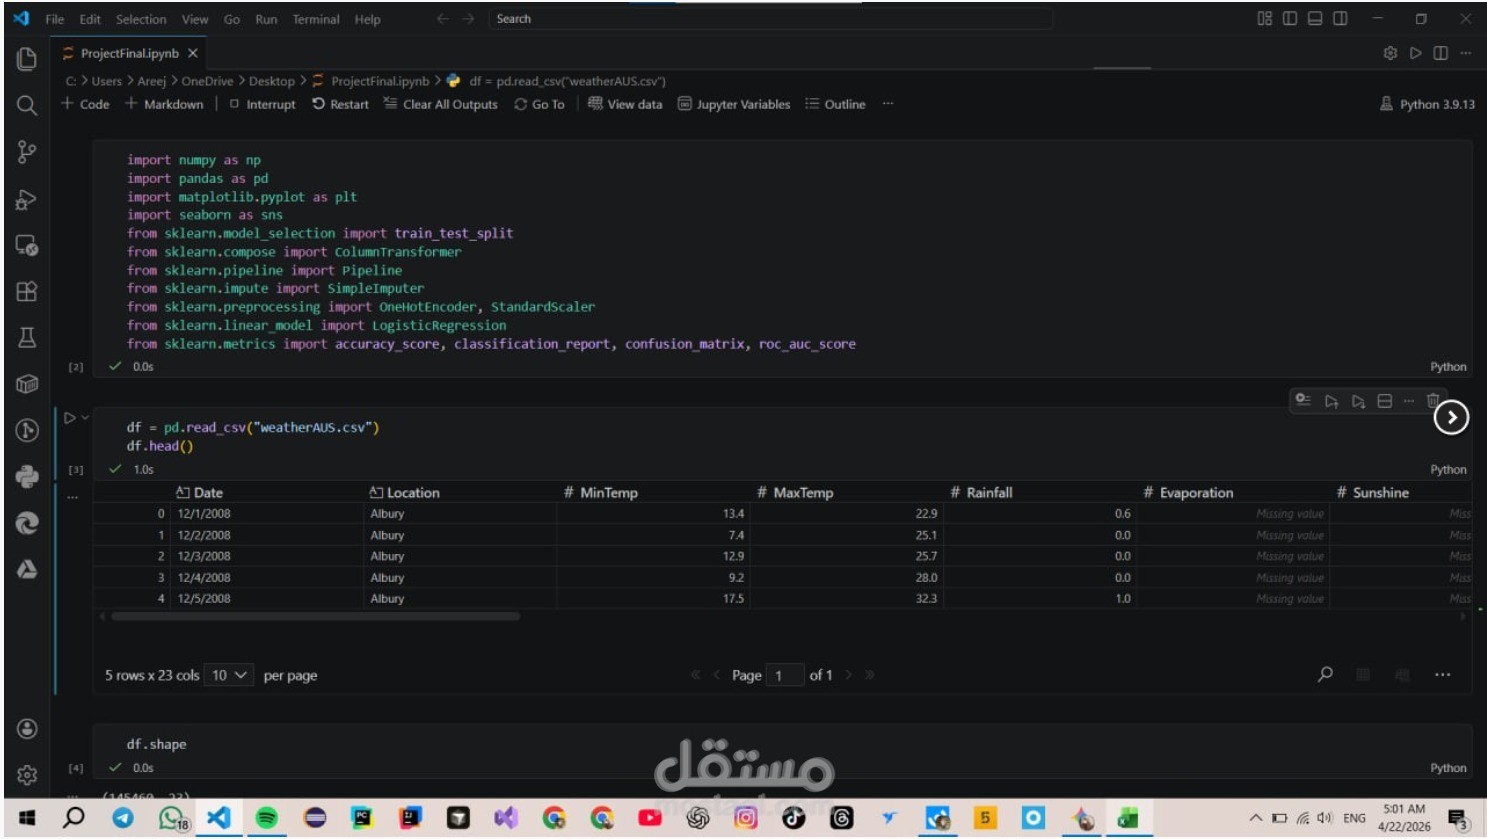
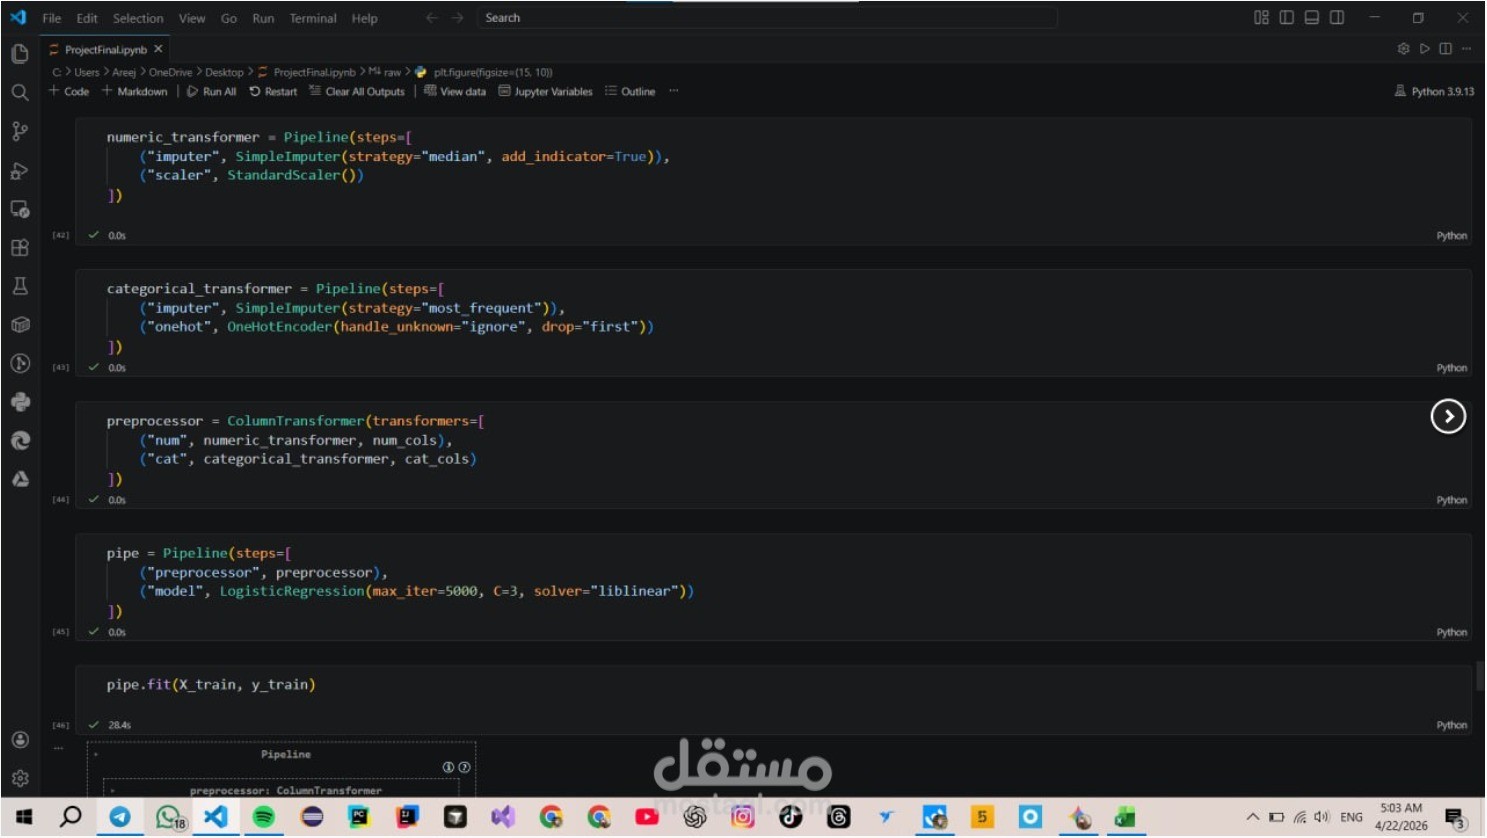
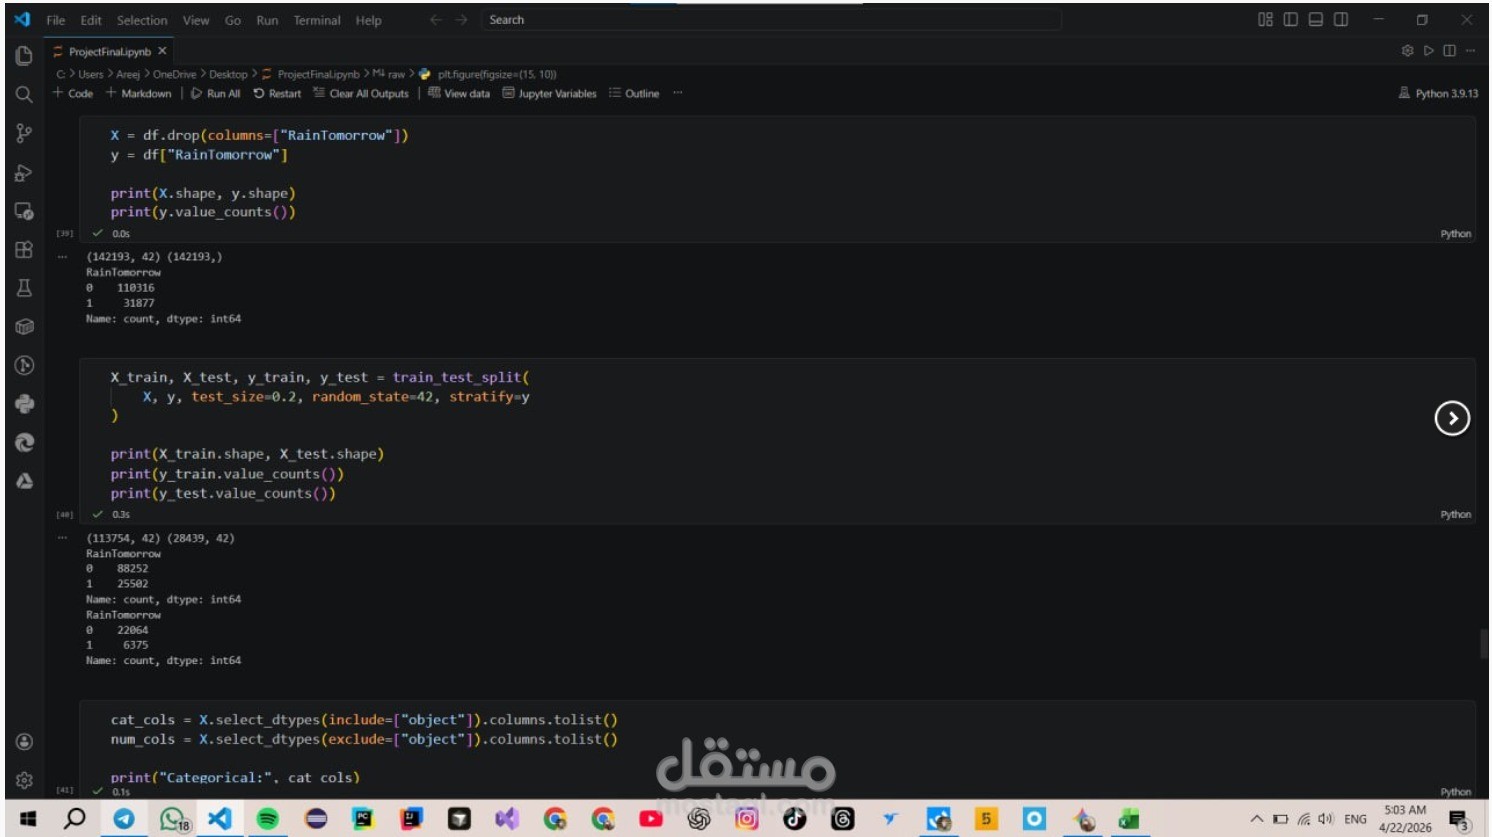
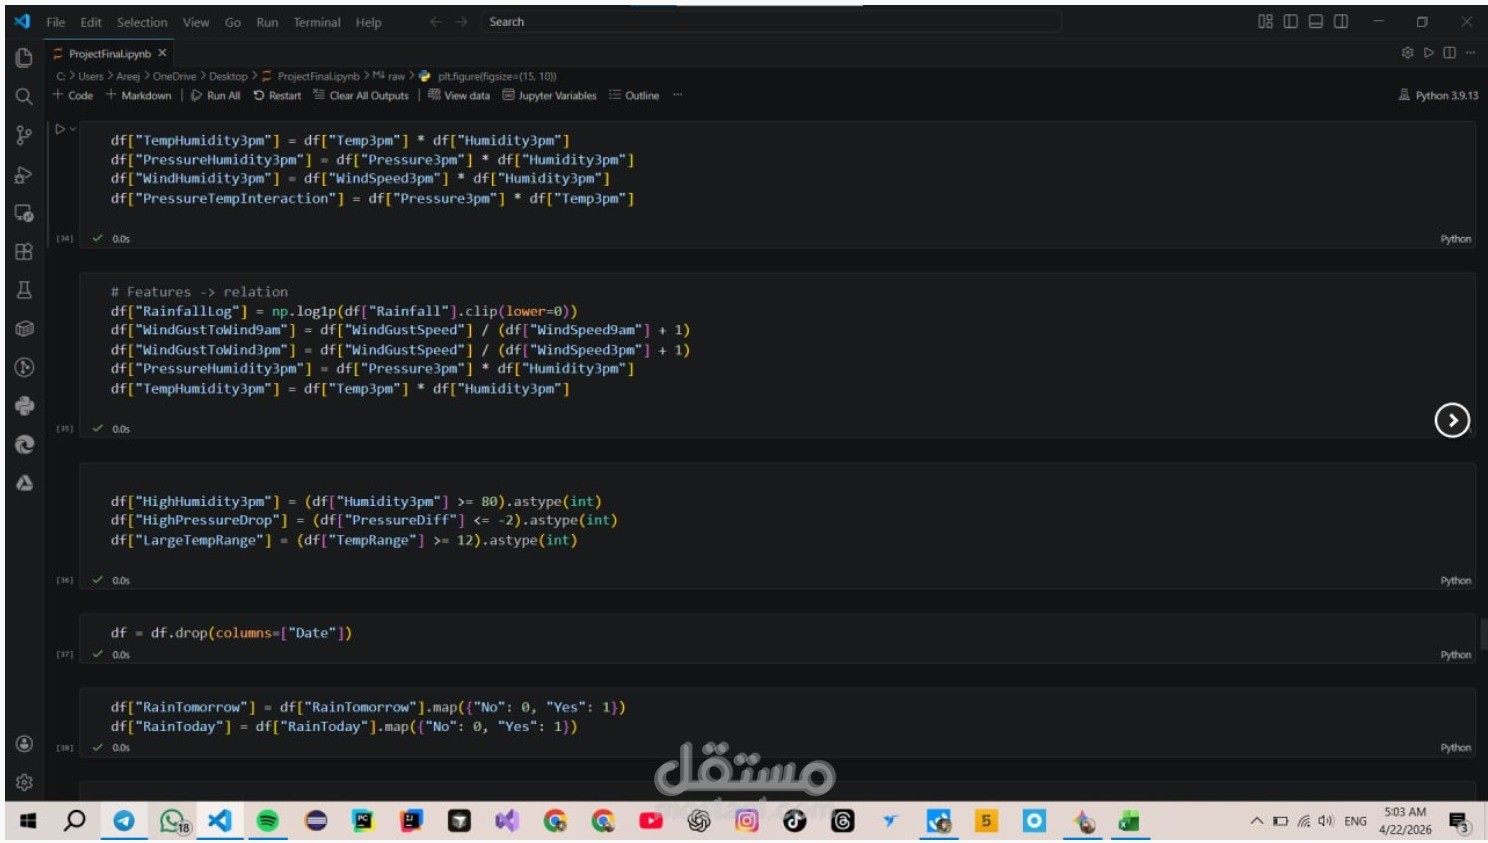
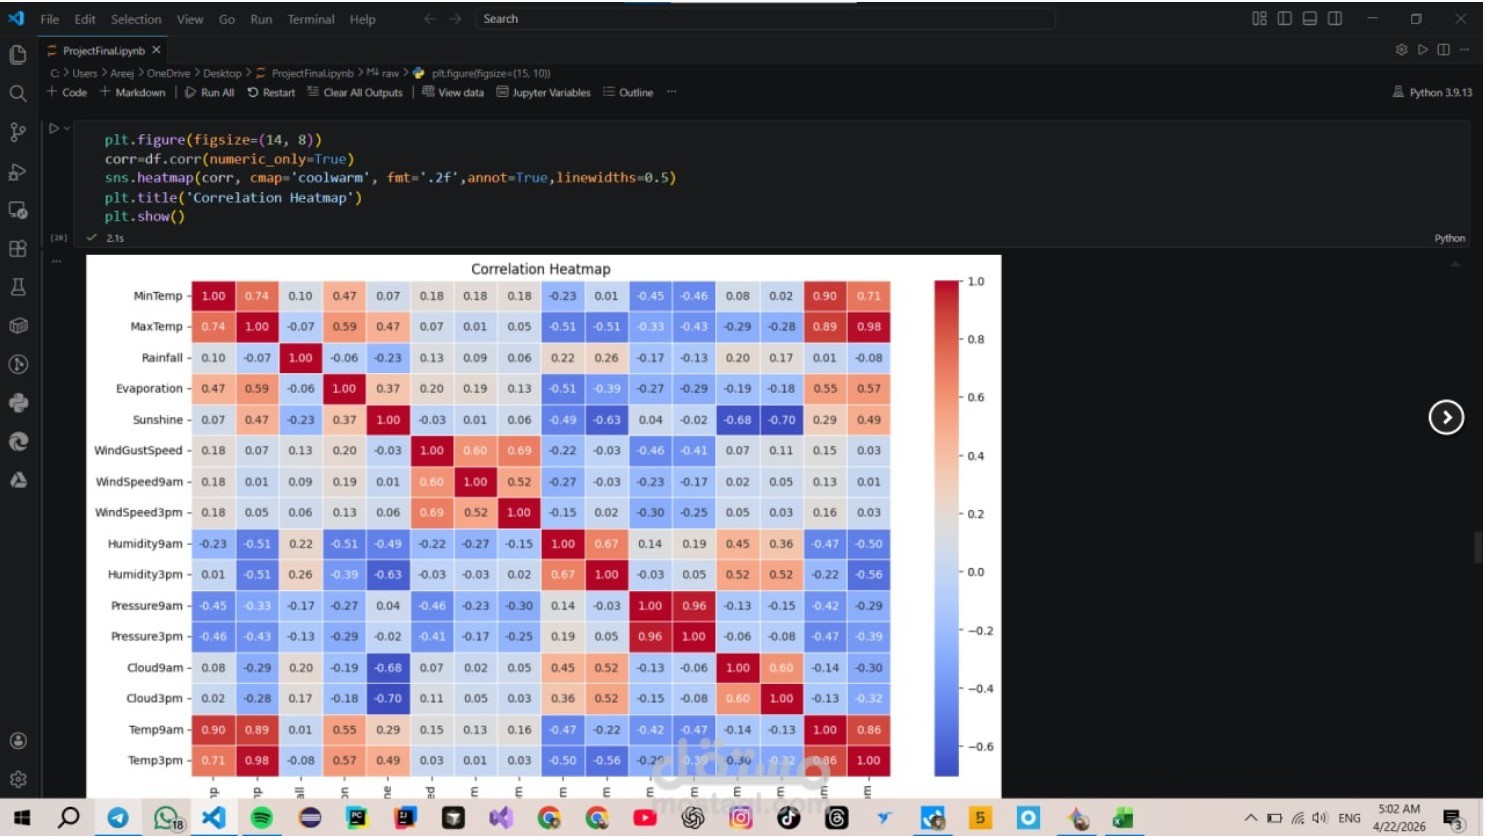
قمت بالعمل على مجموعة بيانات (Dataset) تحتوي على بيانات للطقس بها الكثير من العشوائية، القيم المفقودة، والقيم الشاذة، والتي كانت تمنع بناء نموذج ذكاء اصطناعي دقيق أو استخراج تحليلات صحيحة. قمت بإجراء عملية معالجة كاملة (End-to-End Data Preprocessing) لجعل البيانات جاهزة تماماً للتحليل وبناء الموديل.
الخطوات والمهام التي قمت بتنفيذها:
استكشاف البيانات (EDA): فهم أبعاد البيانات، أنواع المتغيرات، ونسب توزيعها.
التعامل مع القيم المفقودة (Handling Missing Data): استخدام طرق متقدمة للتعويض مثل المتوسط أو الوسيط (Imputation) أو حذف الصفوف غير المؤثرة بناءً على طبيعة البيانات.
معالجة البيانات النصية والفئوية (Categorical Encoding): تحويل البيانات النصية إلى أرقام باستخدام تقنيات مثل One-Hot Encoding أو Label Encoding لتصبح جاهزة للموديل.
تطهير البيانات من القيم الشاذة (Outliers Detection & Handling): اكتشاف القيم الشاذة باستخدام (IQR أو Z-Score) والتعامل معها بحذر لضمان عدم تشويه النتائج.
هندسة الميزات (Feature Engineering & Scaling): إنشاء ميزات جديدة تساعد في تحسين أداء النموذج، وتطبيق الـ Normalization أو Standardization لتوحيد مقاييس البيانات.
الأدوات والمكتبات المستخدمة:
اللغة: Python
المكتبات: Pandas, NumPy, Scikit-learn
المحاكاة البصرية: Matplotlib, Seaborn