AI-Powered Support Ticket Triage System
تفاصيل العمل
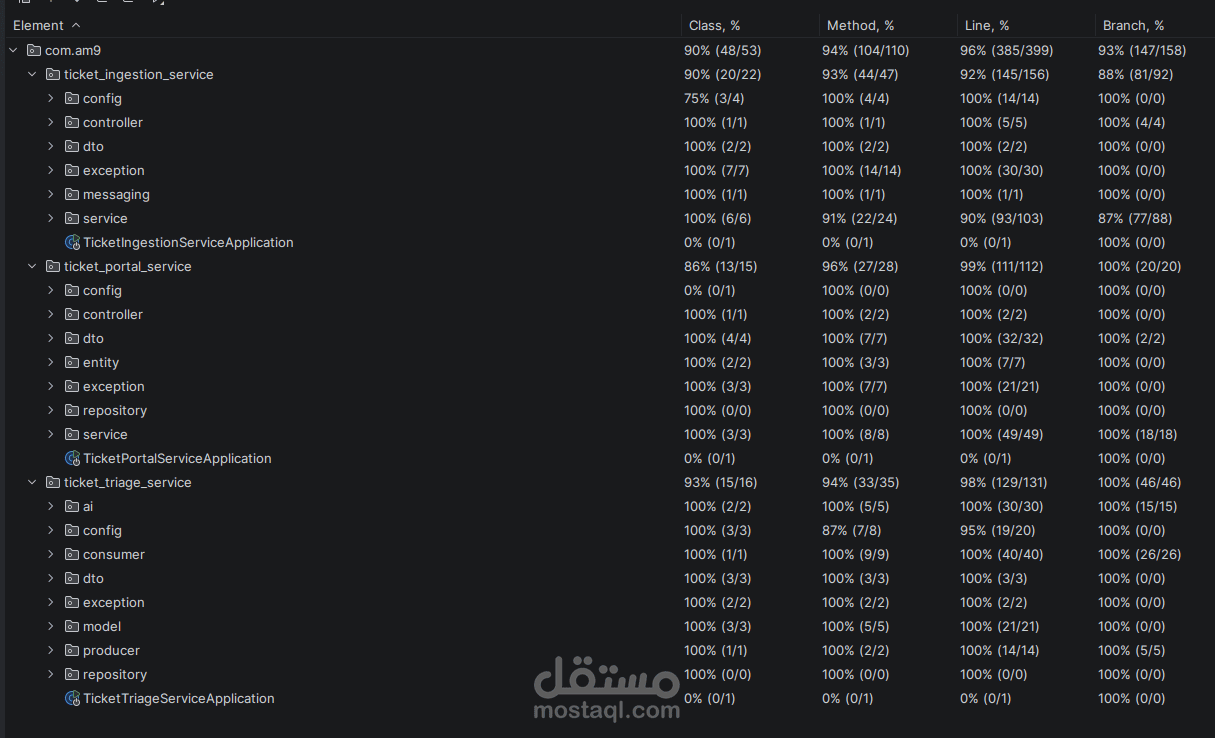
نظام تصنيف تذاكر الدعم الفني بالذكاء الاصطناعي — بنية Microservices غير متزامنة (Java/Spring Boot)
نظام خلفي (Backend) بمستوى إنتاجي يقوم بتصنيف تذاكر الدعم الفني تلقائيًا حسب درجة الأهمية باستخدام الذكاء الاصطناعي، مصمم لإظهار أسلوب موثوق في بناء الخدمات المصغرة (Microservices) ضمن بنية غير متزامنة قائمة على الأحداث (Event-Driven).
آلية العمل
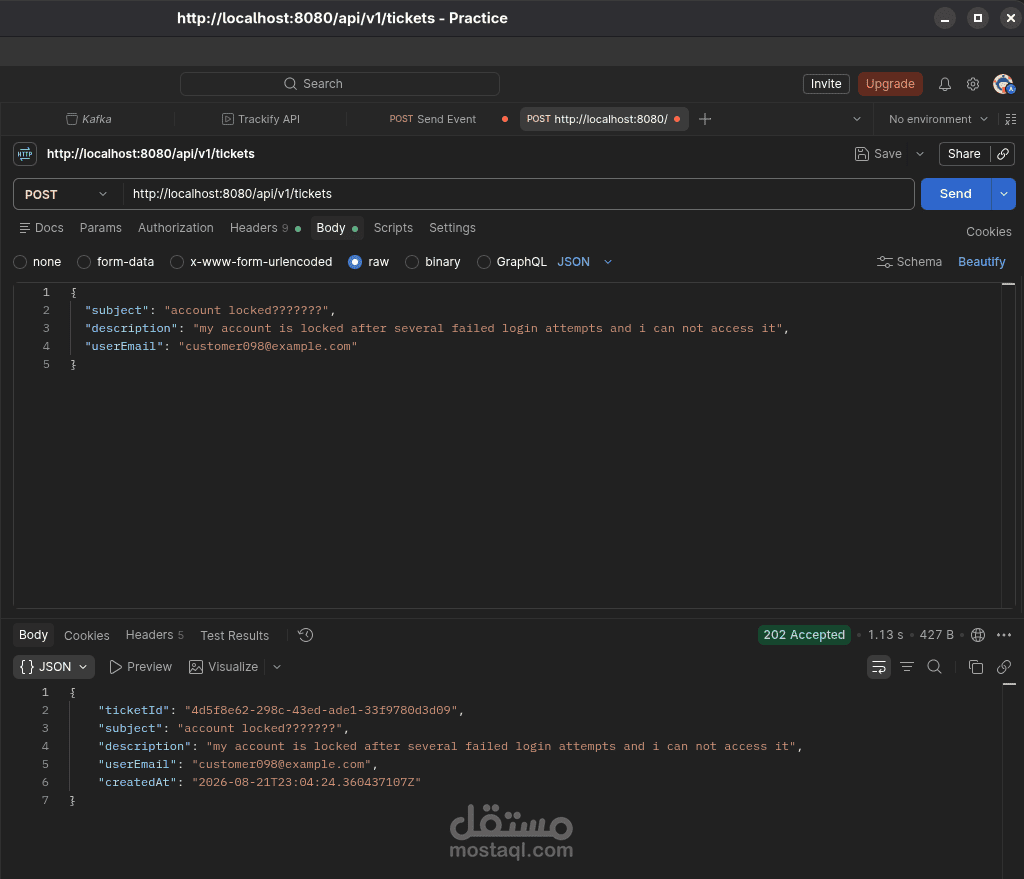
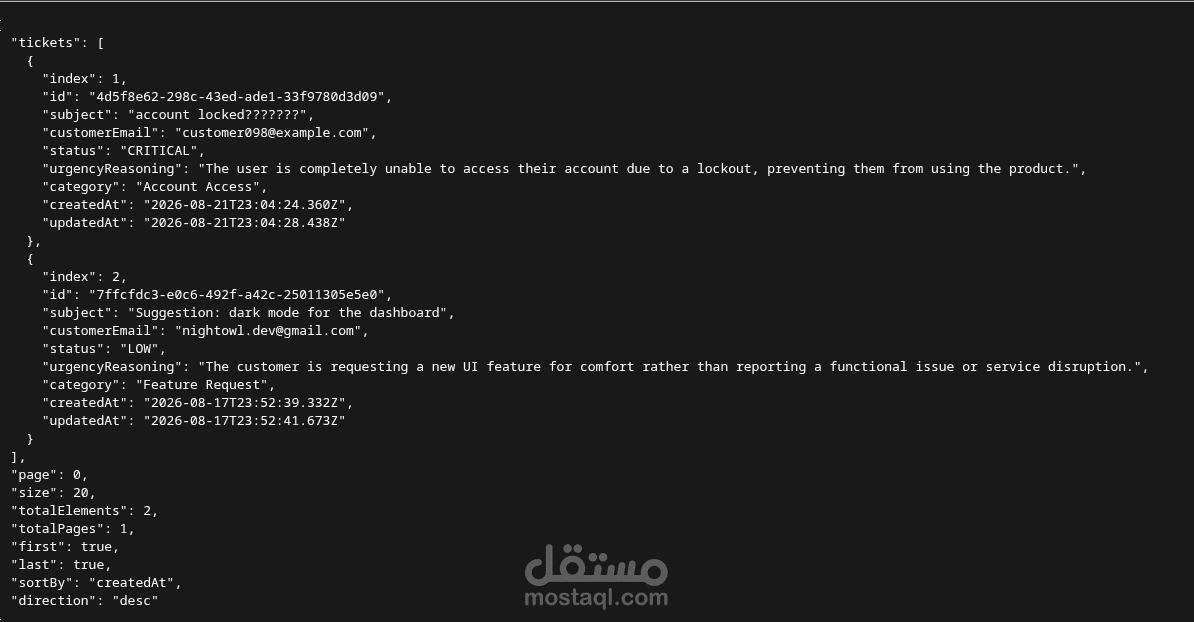
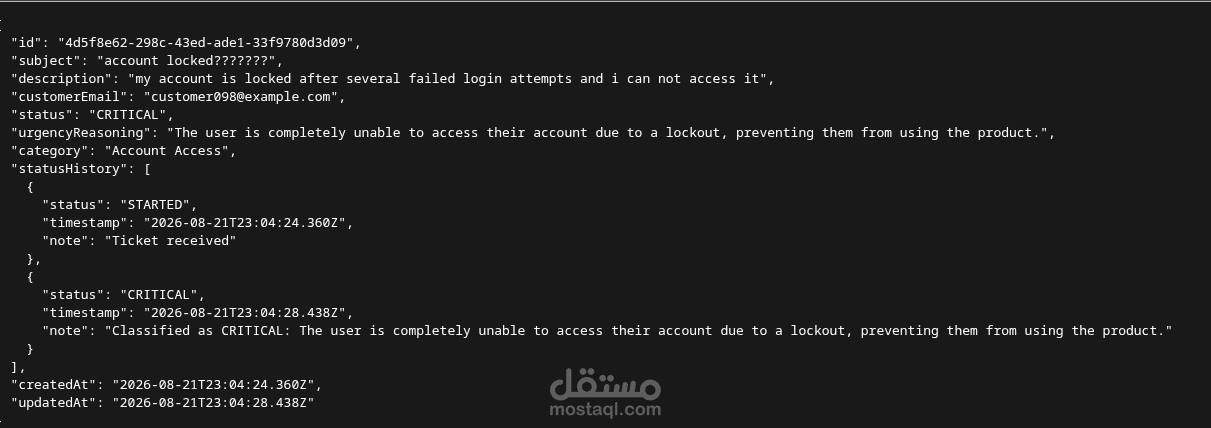
يستقبل النظام تذاكر الدعم عبر REST API، ثم يعالجها بشكل غير متزامن باستخدام Apache Kafka، ويقوم بتصنيف كل تذكرة من حيث الأهمية والفئة باستخدام Google Gemini، وأخيرًا يعرض النتائج عبر واجهة قراءة منفصلة تمامًا — مع سجل كامل لتاريخ حالة كل تذكرة.
البنية المعمارية
ثلاث خدمات مصغرة مستقلة مبنية بـ Spring Boot، كل منها مسؤول عن مهمة واحدة فقط:
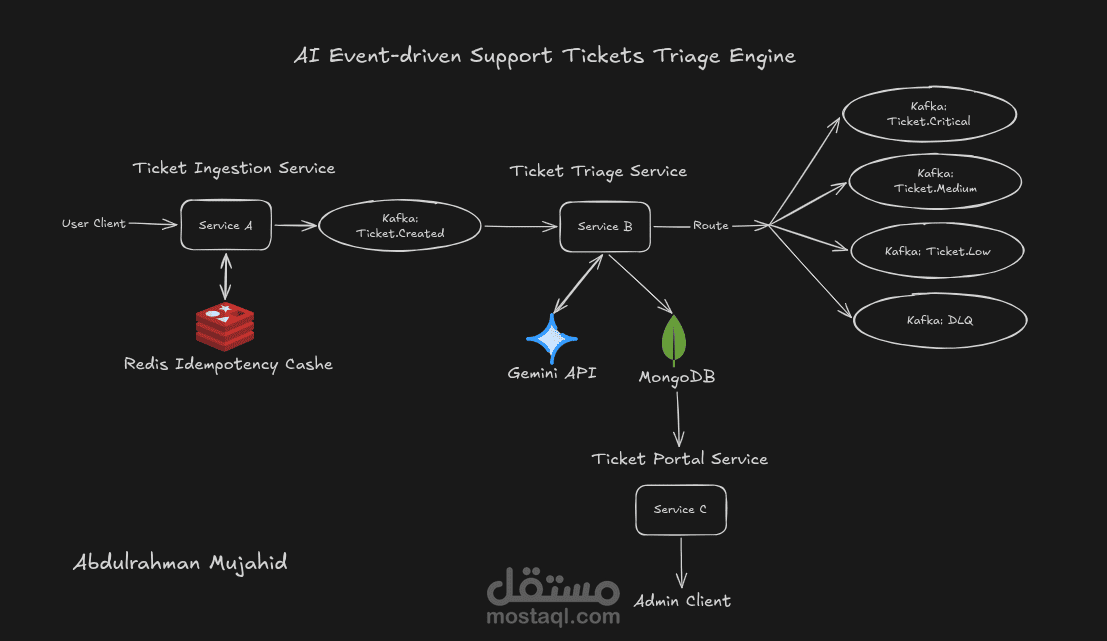
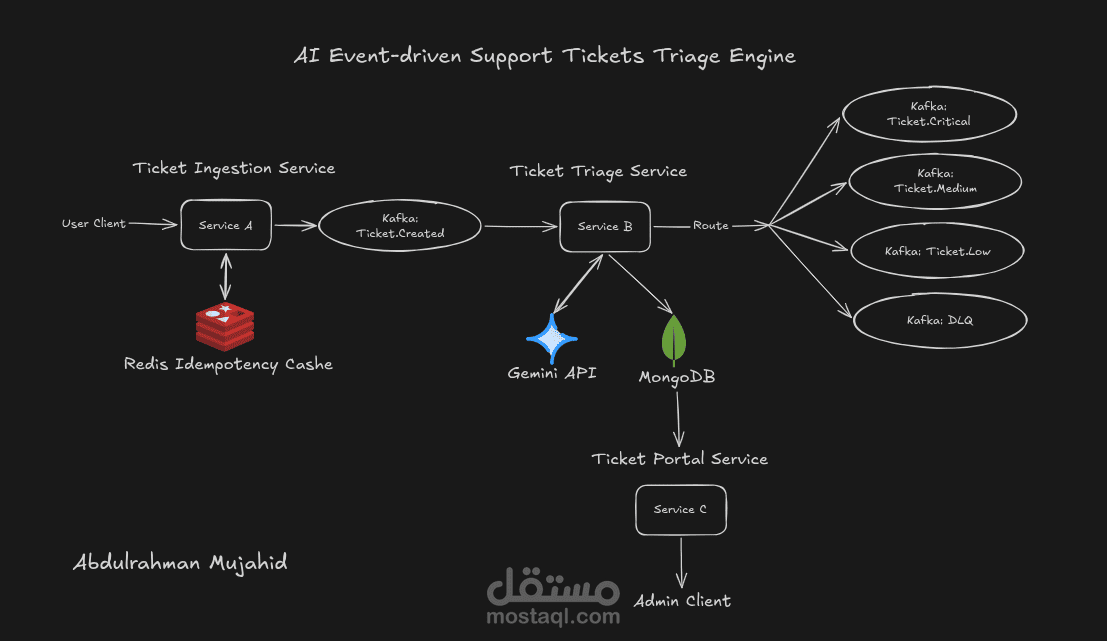
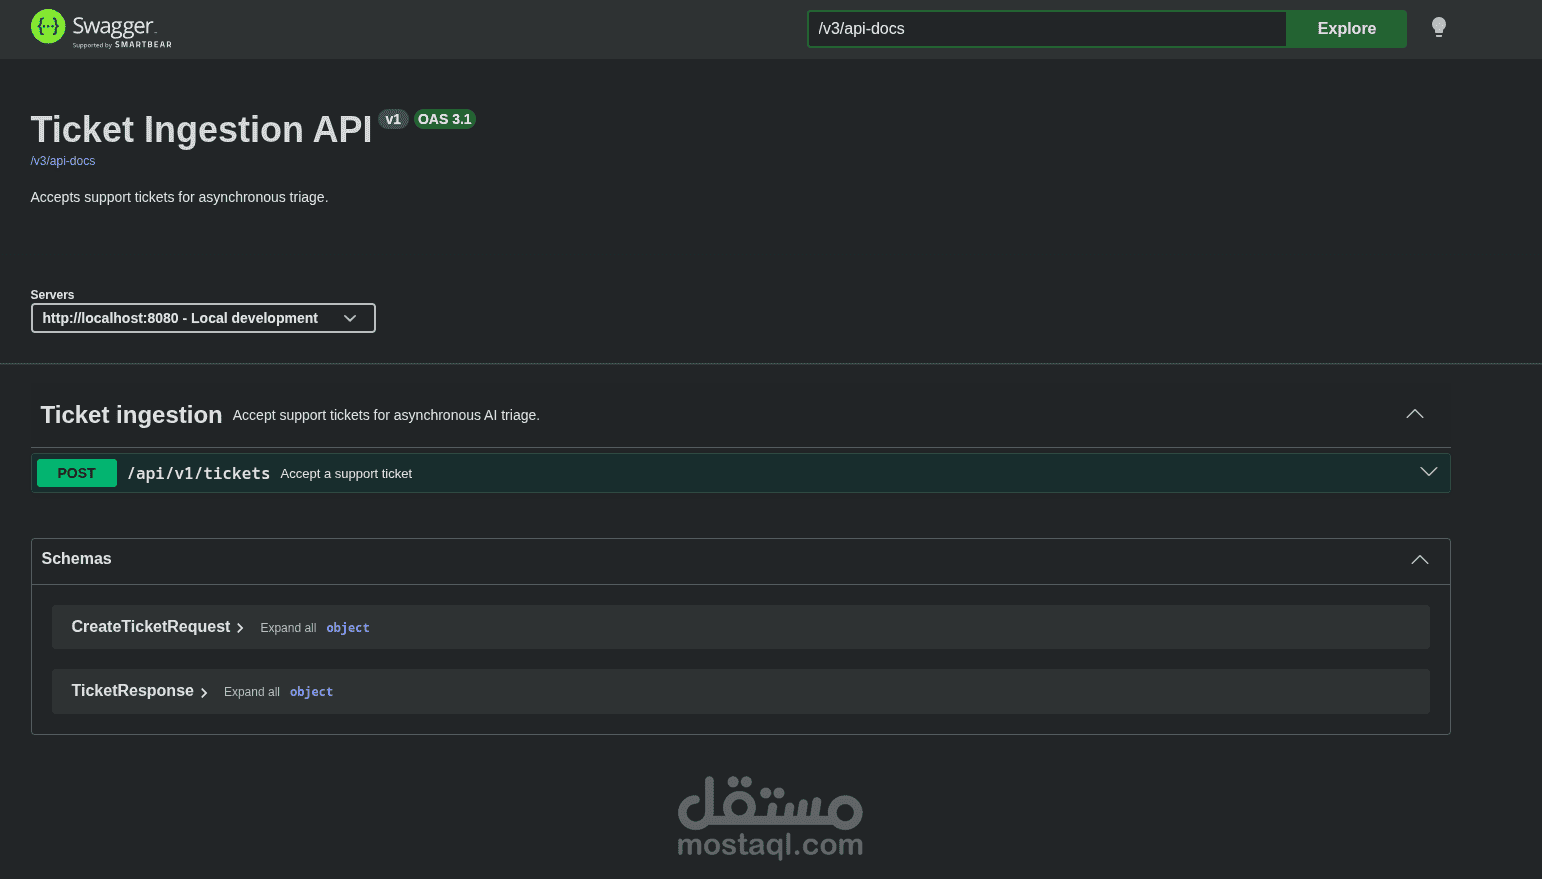
خدمة الاستقبال (Ingestion) — تستقبل التذاكر عبر REST، وتضمن عدم تكرار الطلبات أو تعارضها من خلال آلية Idempotency، ثم تنشر الأحداث إلى Kafka.
خدمة التصنيف (Triage) — تستهلك أحداث التذاكر، وتستدعي Gemini لتصنيفها بشكل منظم، وتتحقق من صحة نتائج الذكاء الاصطناعي قبل الوثوق بها، ثم توجّه التذاكر إلى مواضيع Kafka حسب درجة الأهمية (مع قائمة انتظار للأخطاء غير المعالجة - DLQ).
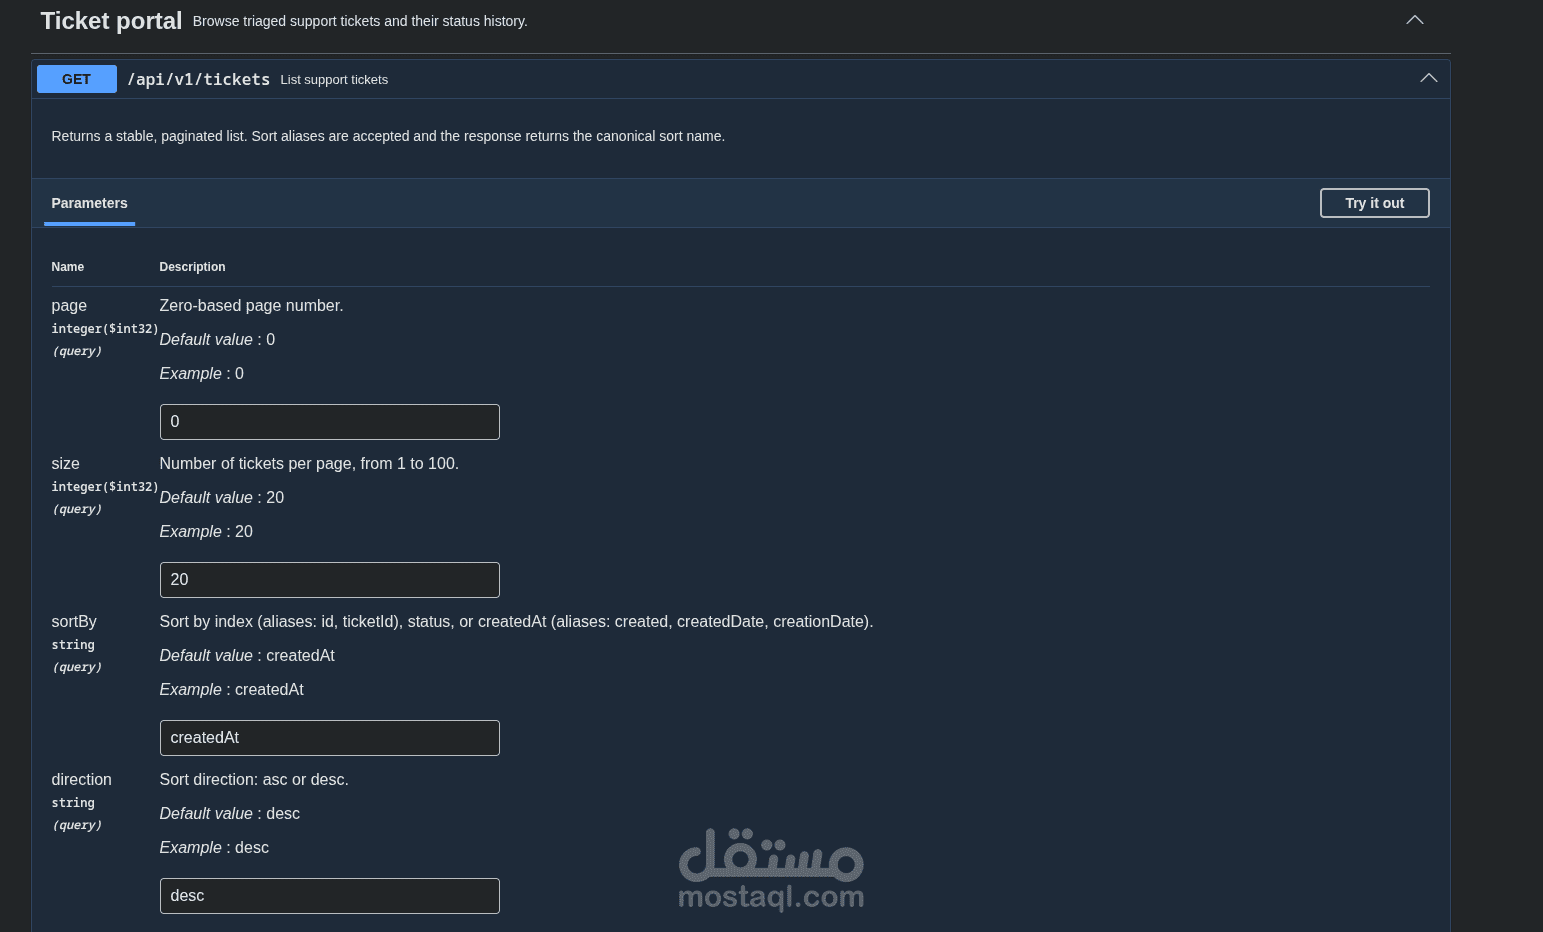
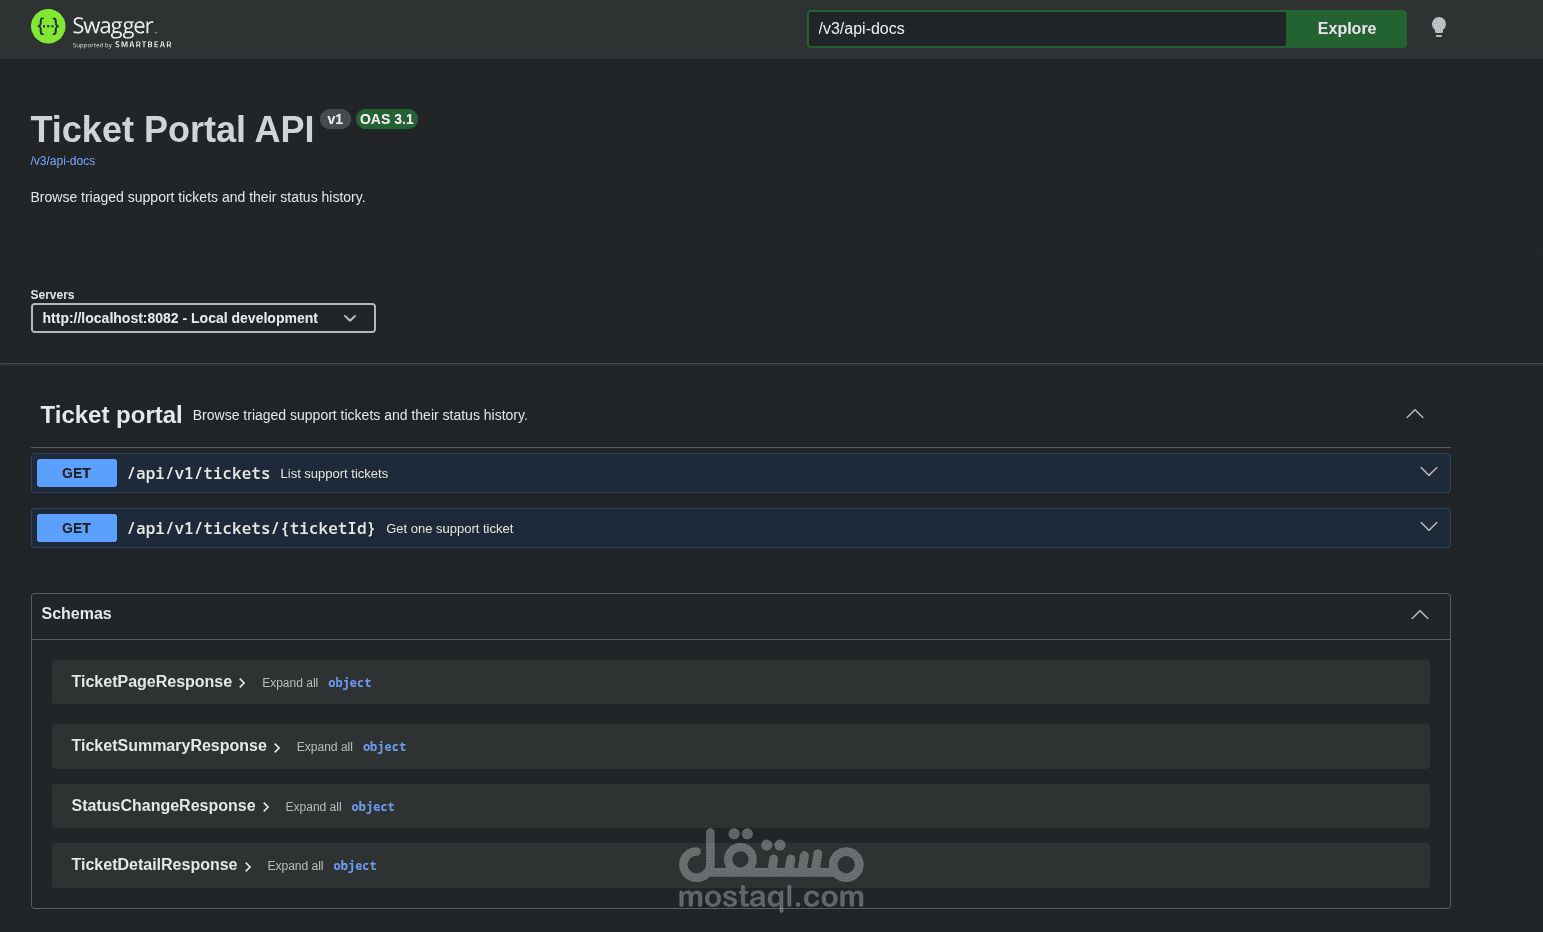
خدمة البوابة (Portal) — واجهة قراءة معزولة بالكامل تعرض تفاصيل التذاكر وسجل حالتها من MongoDB، دون أي اعتماد على مسار التصنيف.
قرارات هندسية رئيسية
آلية Idempotency معتمدة على Redis باستخدام مفاتيح مشفّرة (Hashed) وبصمة للطلب (Request Fingerprinting)، بحيث تُعاد النتائج المخزّنة مسبقًا عند تكرار الطلب بدلًا من إنشاء تذكرة مكررة.
لا يتم الوثوق بمخرجات الذكاء الاصطناعي دون تحقق — يتم التحقق من كل استجابة من Gemini وتنسيقها قبل أن تؤثر على حالة التذكرة.
فصل كامل بين مسارَي القراءة والكتابة: خدمة البوابة لا تتعامل مطلقًا مع Kafka أو Gemini، بل تعتمد فقط على البيانات المخزنة في MongoDB.
إعداد كامل عبر Docker Compose مع فحوصات صحة (Health Checks) لضمان تشغيل Kafka وRedis وMongoDB بالترتيب الصحيح.
AI-Powered Support Ticket Triage System — Event-Driven Microservices (Java/Spring Boot)
A production-style backend system that automatically classifies incoming support tickets by urgency using AI, built to demonstrate reliable microservice design under asynchronous, event-driven architecture.
What it does
The system accepts support tickets through a REST API, processes them asynchronously through Apache Kafka, classifies each ticket's urgency and category using Google Gemini, and exposes the results through a separate read-only API — with full status history for every ticket.
Architecture
Three independent Spring Boot microservices, each with a single responsibility:
Ingestion service — accepts tickets via REST, enforces idempotency so duplicate or conflicting submissions are safely rejected, and publishes events to Kafka.
Triage service — consumes ticket events, calls Gemini for structured classification, validates the AI's output before trusting it, and routes tickets to urgency-specific Kafka topics (with a dead-letter queue for failures).
Portal service — a fully isolated read API that serves ticket details and status history from MongoDB, independent of the classification pipeline.
Key engineering decisions
Redis-backed idempotency using hashed keys and request fingerprinting, so retried requests return cached results instead of creating duplicates.
AI output is never trusted blindly — every Gemini response is validated and normalized before it affects ticket state.
Read and write paths are fully decoupled: the portal never touches Kafka or Gemini, only the persisted MongoDB state.
Full Docker Compose setup with health-checked service startup for Kafka, Redis, and MongoDB.