تحليل بيانات الأدوية – Medical Data Analysis Project
تفاصيل العمل
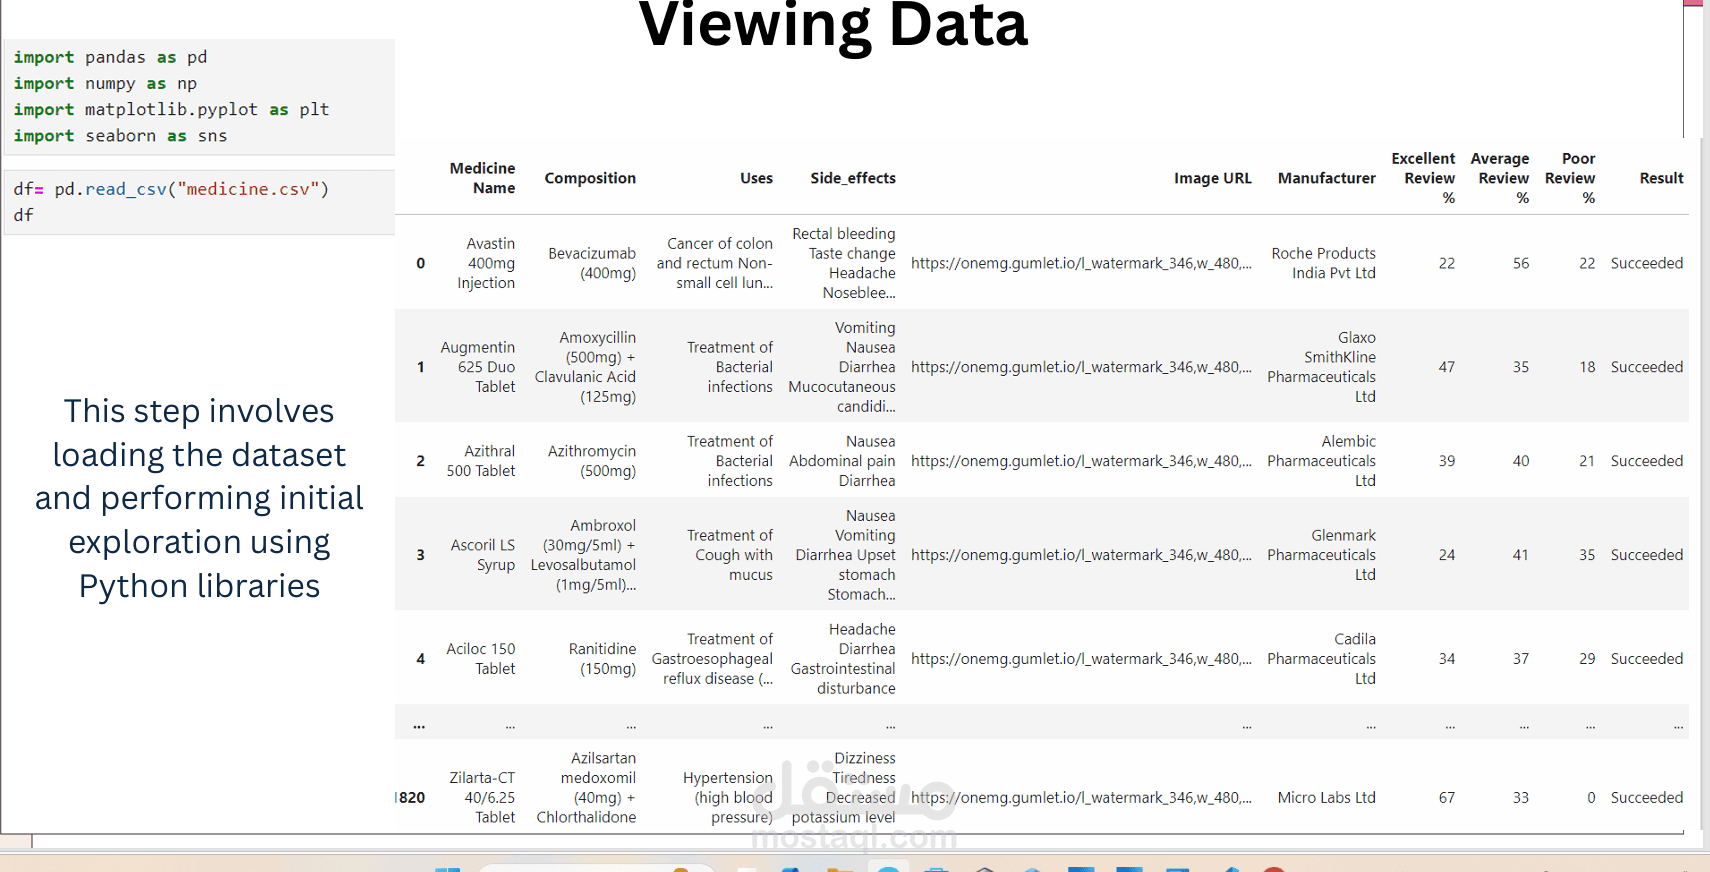
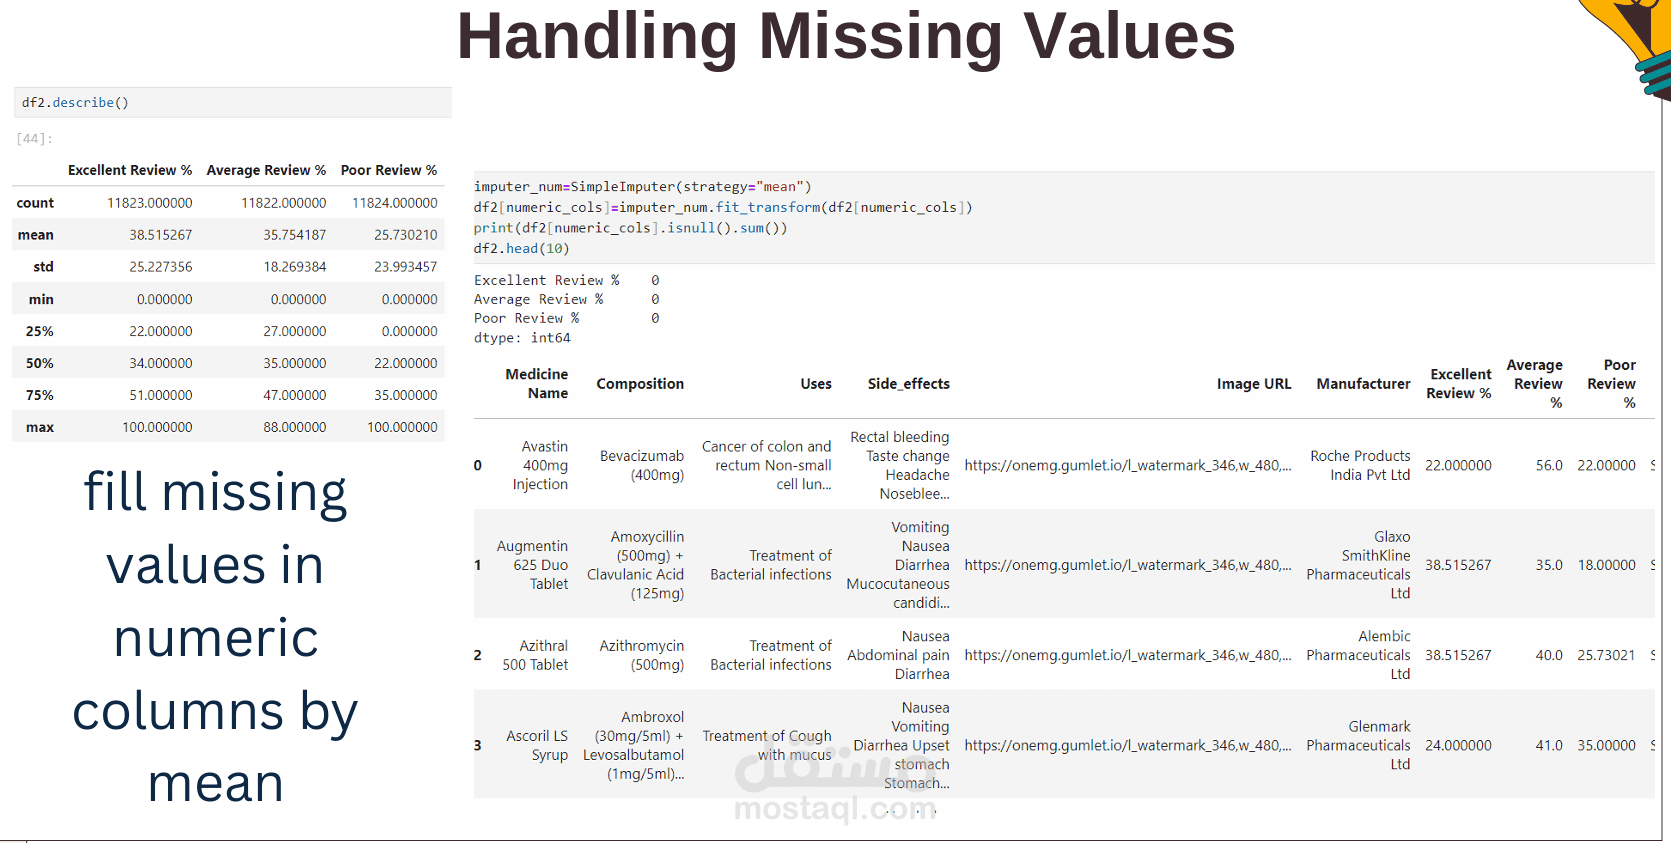
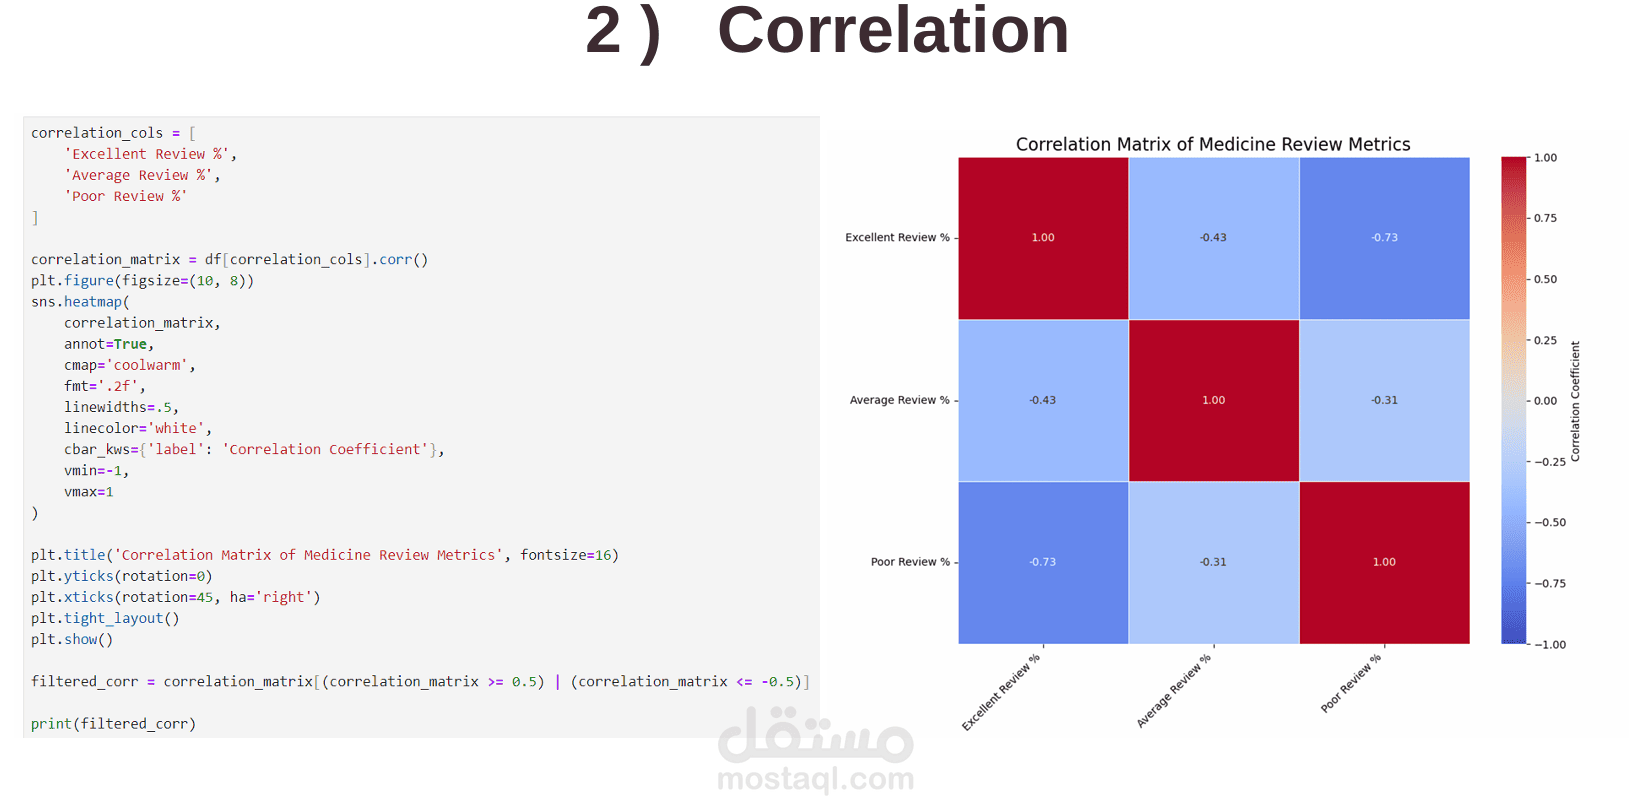
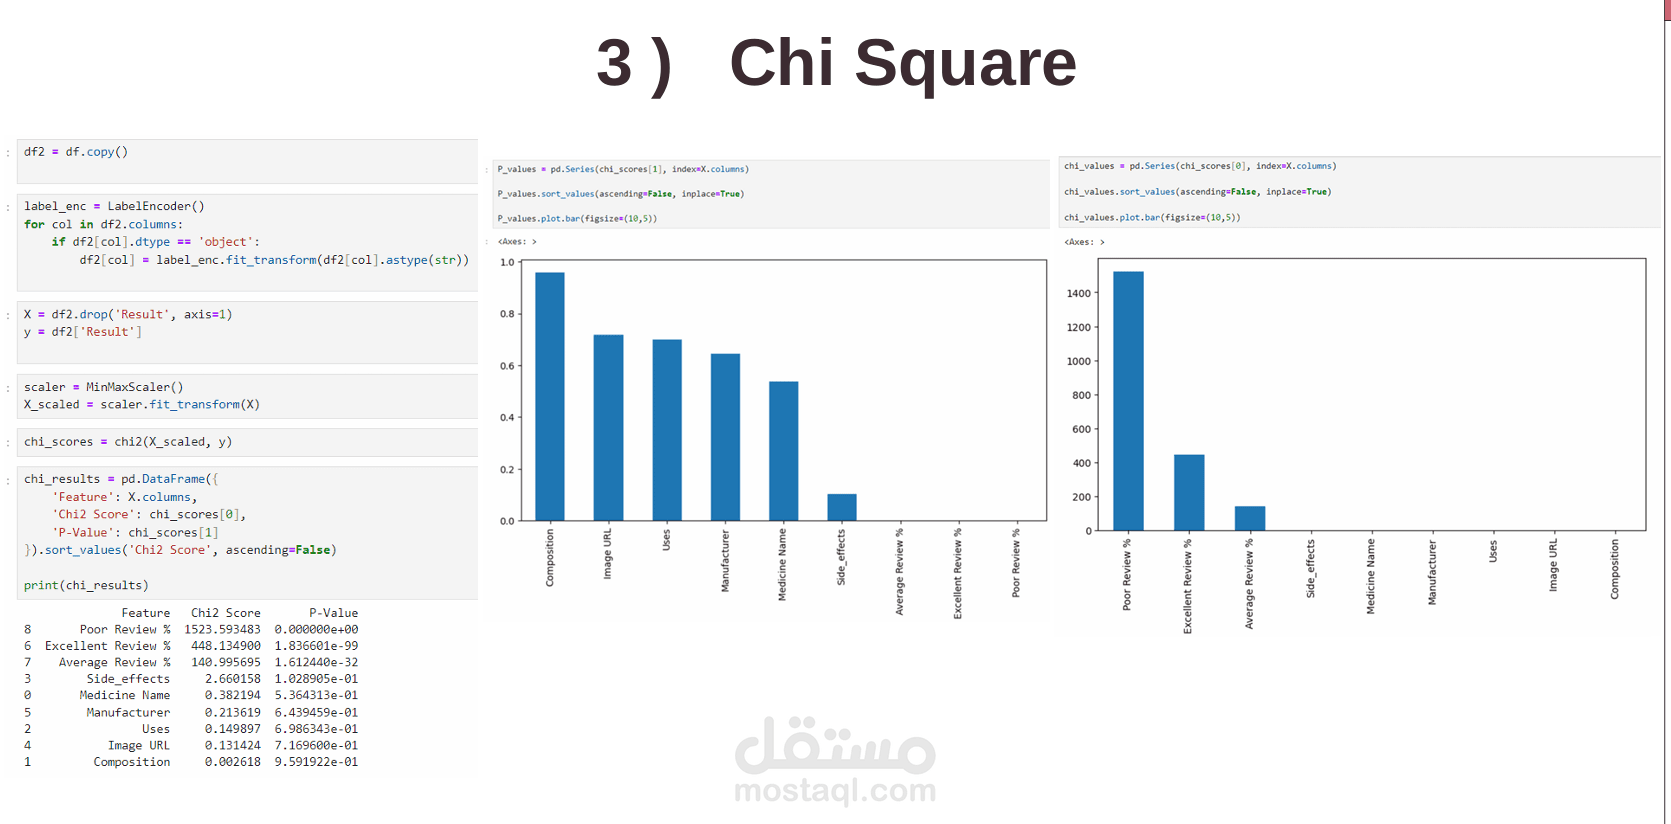
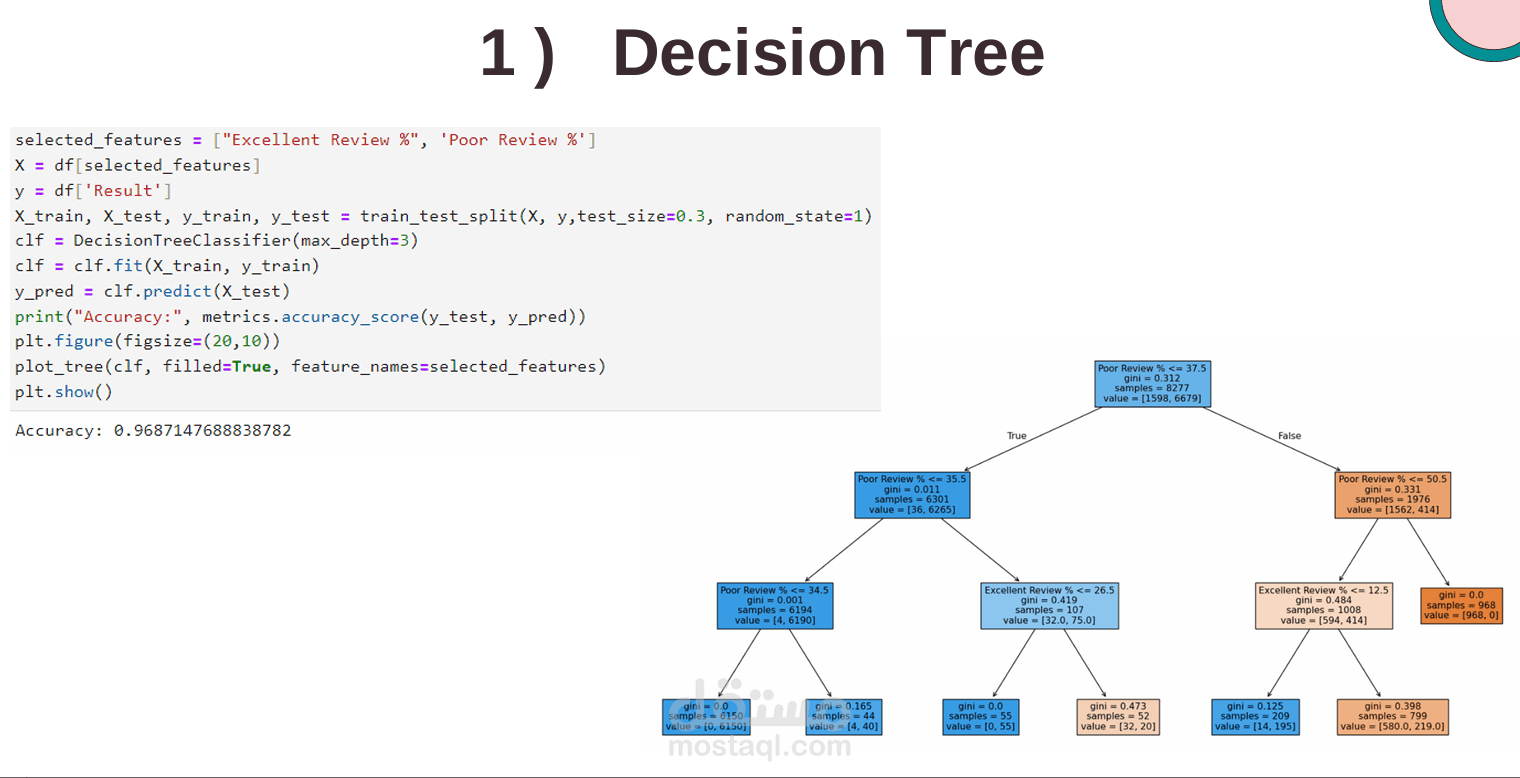
قمت بتحليل مجموعة بيانات ضخمة تحتوي على أكثر من 11,000 دواء، تشمل معلومات التركيب، الاستخدامات، الآثار الجانبية، الشركات المصنعة، وتقييمات المستخدمين.
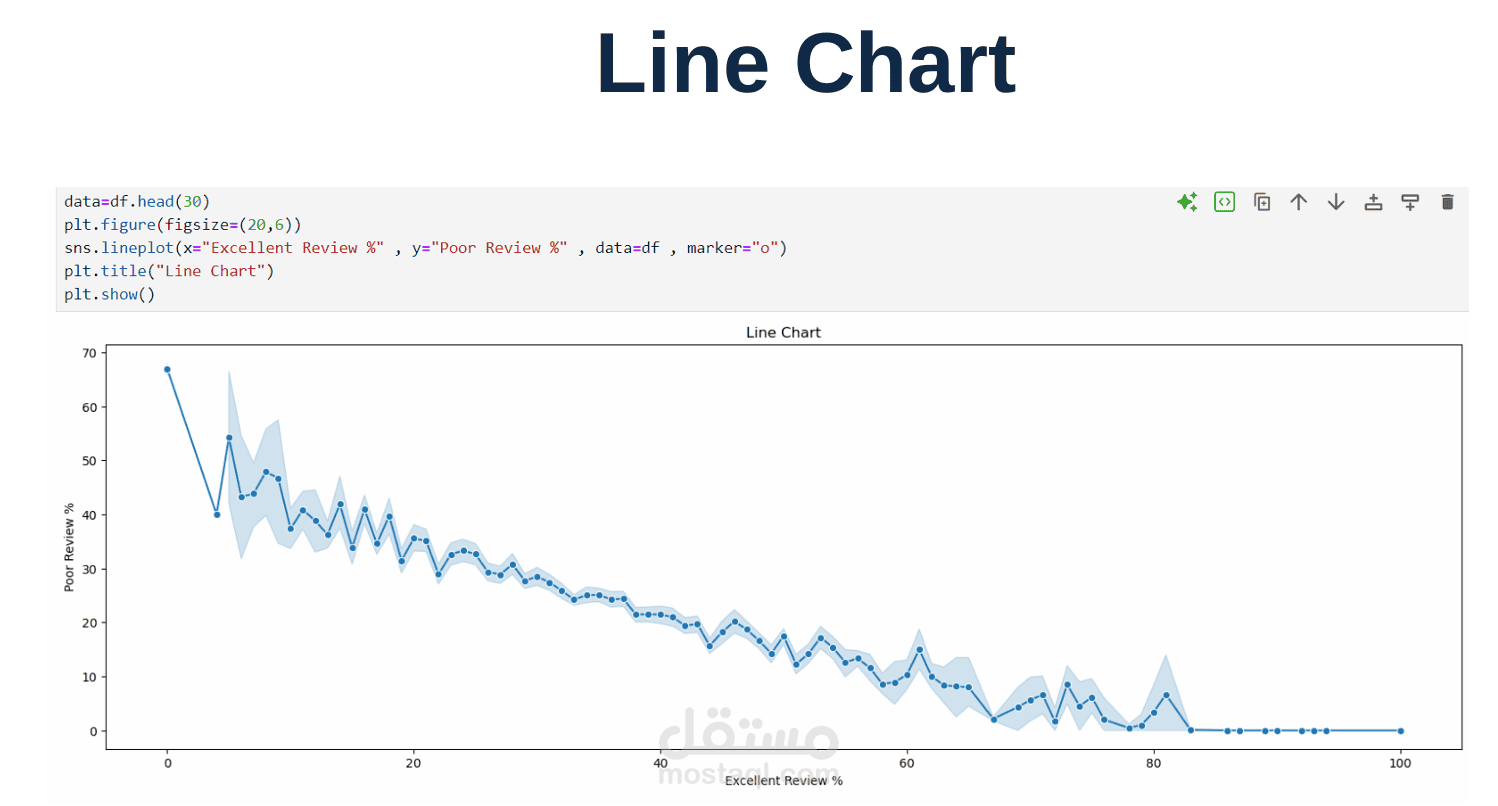
تم تنظيف البيانات ومعالجة القيم المفقودة، ثم إجراء تحليل استكشافي شامل (EDA) مع إنشاء تصورات بيانية احترافية توضح أنماط أداء الأدوية واتجاهات التقييمات ومقارنة الشركات المصنعة.
بالإضافة إلى ذلك، تم تطبيق عدة نماذج من تعلم الآلة (Machine Learning) على البيانات وهي:
Decision Tree — لتصنيف الأدوية بناءً على خصائصها وتقييماتها
K-Nearest Neighbors (KNN) — للتنبؤ بتصنيف الدواء بناءً على الأدوية المشابهة له
K-Means Clustering — لتجميع الأدوية في مجموعات متشابهة واكتشاف الأنماط الخفية
Naive Bayes — لتصنيف الأدوية والتنبؤ بمستوى رضا المستخدمين