تصنيف الفطر باستخدام التعلم الآلي
تفاصيل العمل
تفضل الترجمة الكاملة:
تصنيف الفطر باستخدام التعلم الآلي
نظرة عامة على المشروع
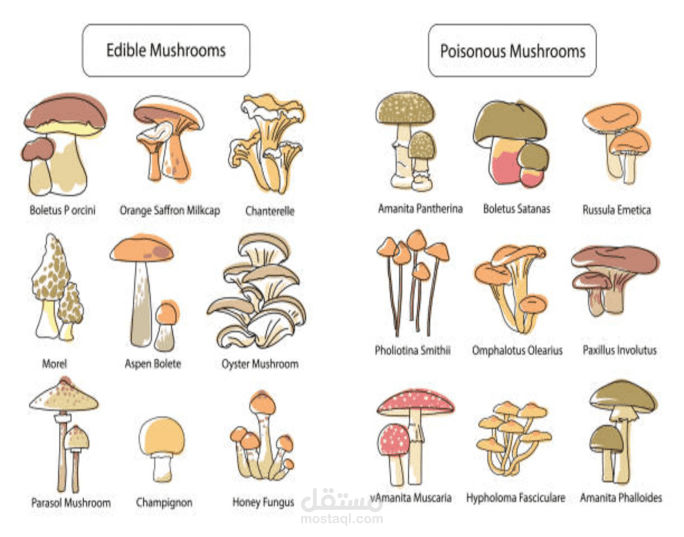
يعالج هذا المشروع مشكلة تصنيف ثنائي كلاسيكية في التعلم الآلي. الهدف الأساسي هو تطوير نموذج تنبؤي يمكنه التمييز بدقة بين الفطر الصالح للأكل والسام بناءً على خصائصه الفيزيائية. يمتلك هذا العمل تطبيقات مباشرة في العالم الواقعي تتعلق بسلامة جمع الطعام والأمن الغذائي، ويهدف إلى منع التسمم العرضي بالفطر.
الأهداف الرئيسية
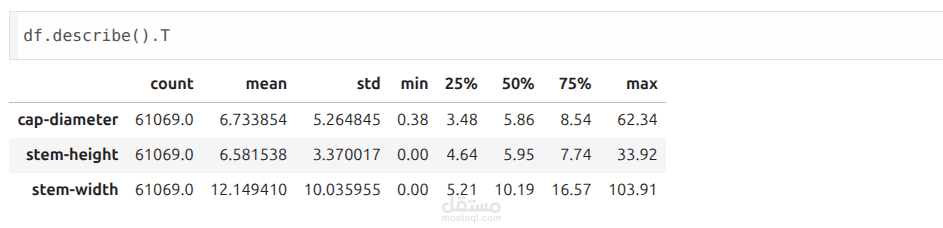
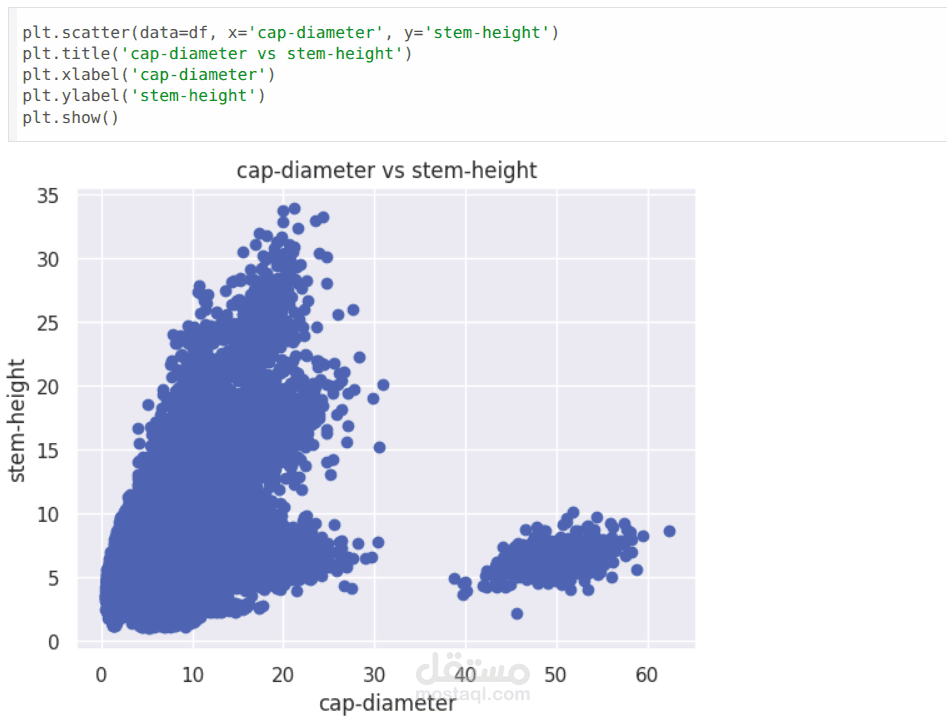
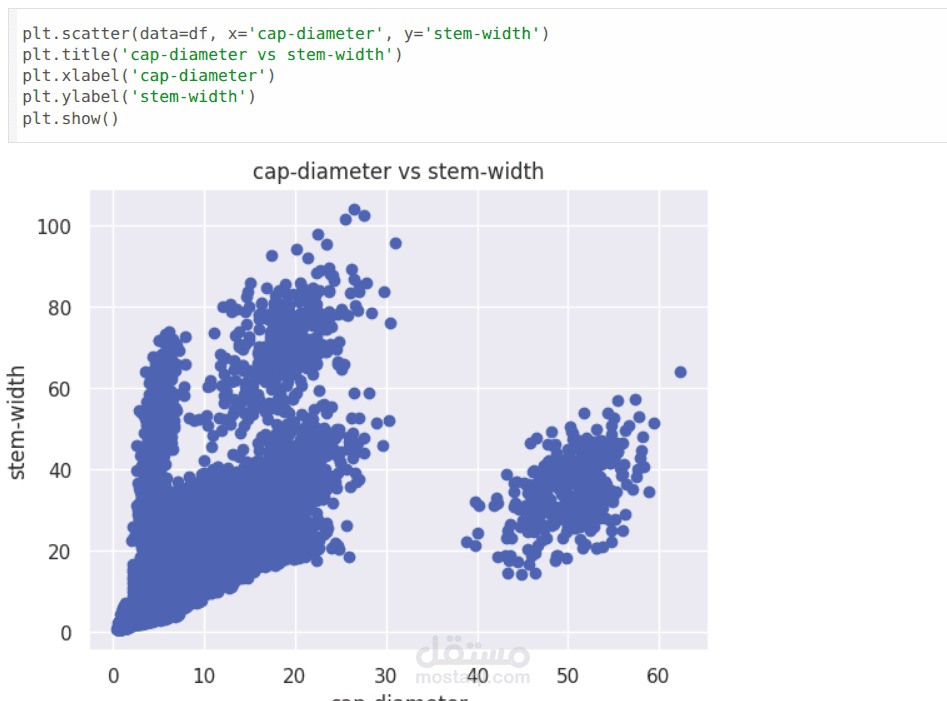
استكشاف وتحليل البيانات: استقصاء هيكل مجموعة البيانات، وتحليل توزيع المتغير الهدف، وكشف العلاقات بين خصائص الفطر (مثل شكل القبعة، الرائحة، الموطن) وقابليته للأكل.
المعالجة المسبقة للبيانات: إعداد البيانات الفئوية الخام لخوارزميات التعلم الآلي من خلال تقنيات الترميز والتحجيم المناسبة.
بناء ومقارنة النماذج: تدريب وتقييم ومقارنة أداء العديد من خوارزميات التعلم الموجه لتحديد النموذج الأكثر فعالية لهذه المهمة.
اختيار نموذج قوي: وضع اللمسات الأخيرة على نموذج عالي الدقة وقابل للتعميم يمكن أن يشكل جوهر تطبيق عملي.
مجموعة البيانات
يستخدم المشروع مجموعة البيانات الشهيرة "Mushroom" أو "Agaricus-Lepiota" من مستودع UCI للتعلم الآلي.
العينات (Samples): 61069 حالة.
الخصائص (Features): 21 خاصية فئوية تصف الخصائص الفيزيائية للفطر (مثل شكل القبعة، لون القبعة، الرائحة، حجم الخياشيم، الموطن).
المتغير الهدف (Target Variable): class
e = صالح للأكل (edible)
p = سام (poisonous)
المنهجية الفنية
1. تحميل البيانات والفحص الأولي
تم تحميل البيانات في Pandas DataFrame، تليها فحوصات أولية للقيم المفقودة ونظرة عامة على هيكل البيانات.
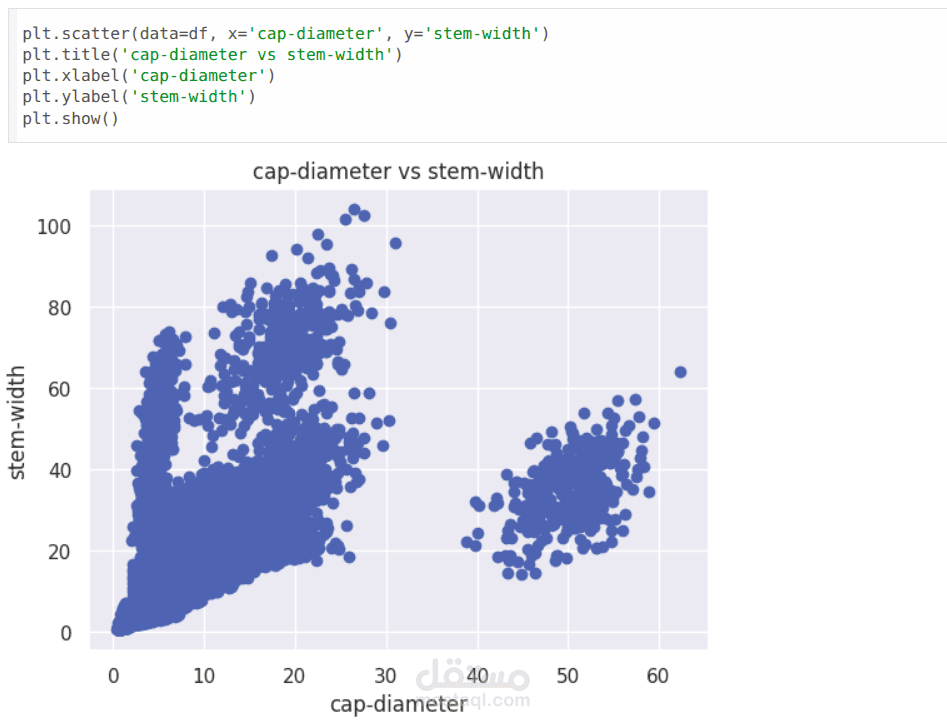
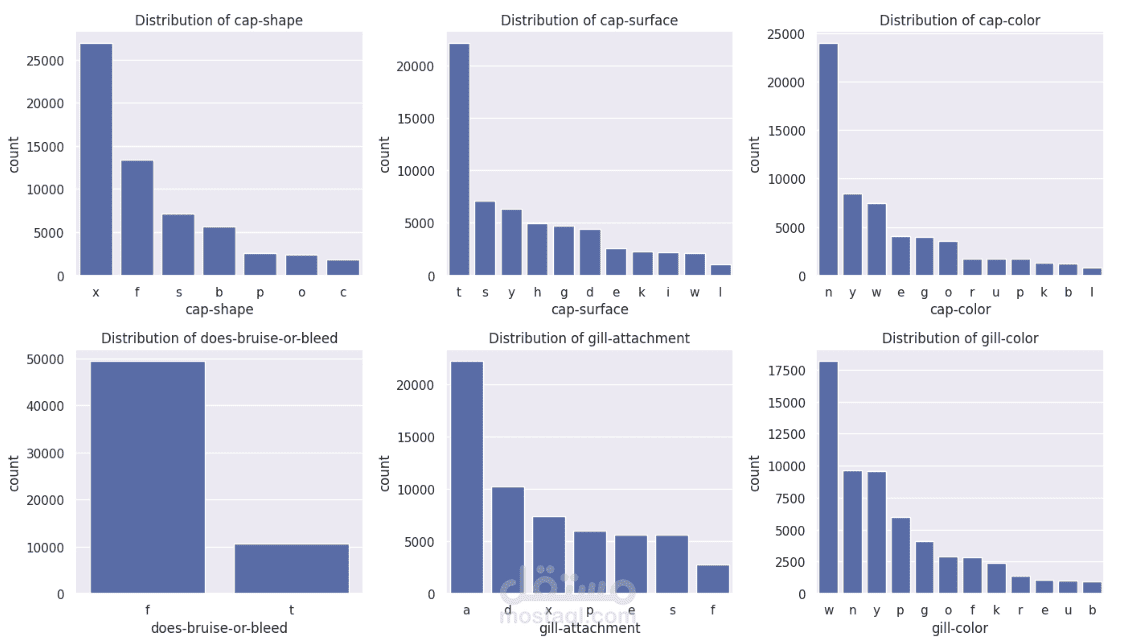
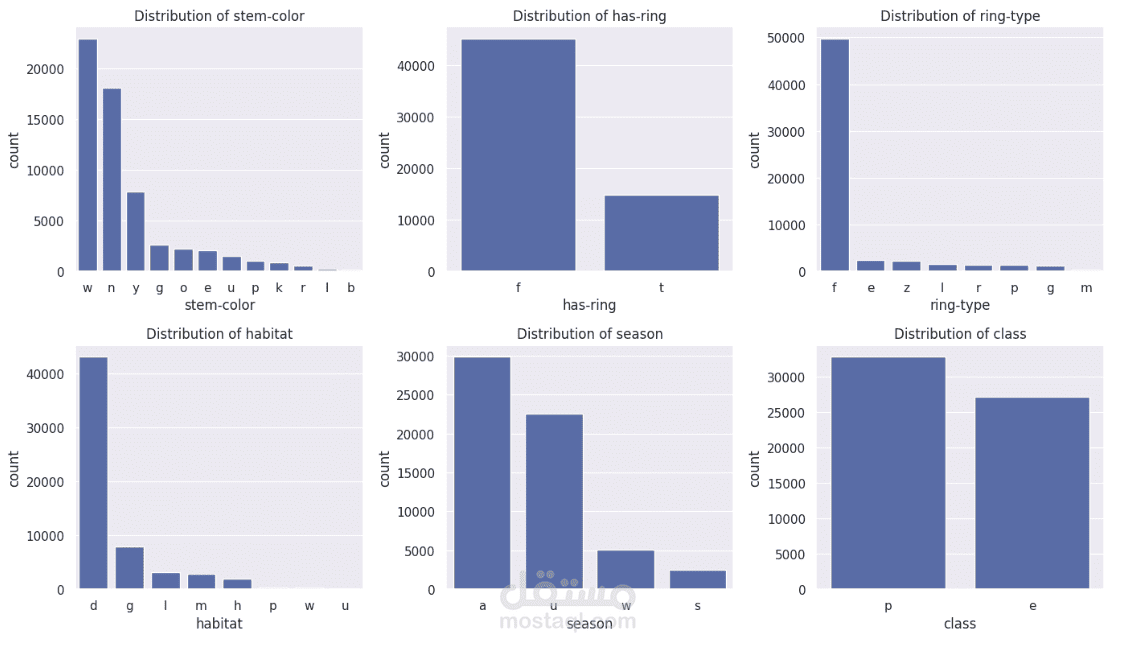
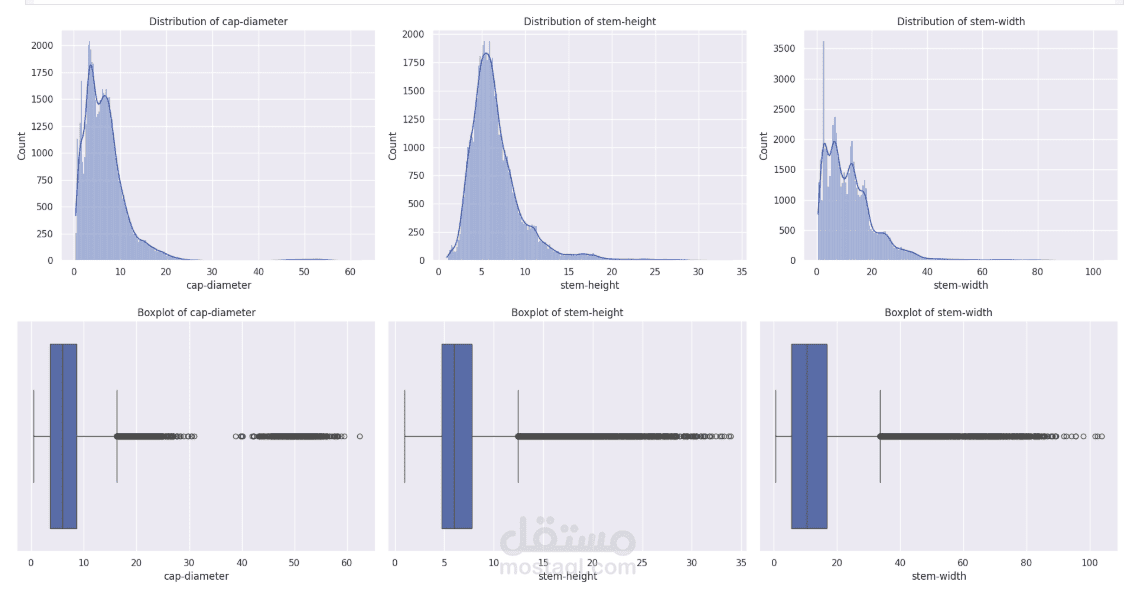
2. التحليل الاستكشافي للبيانات (EDA)
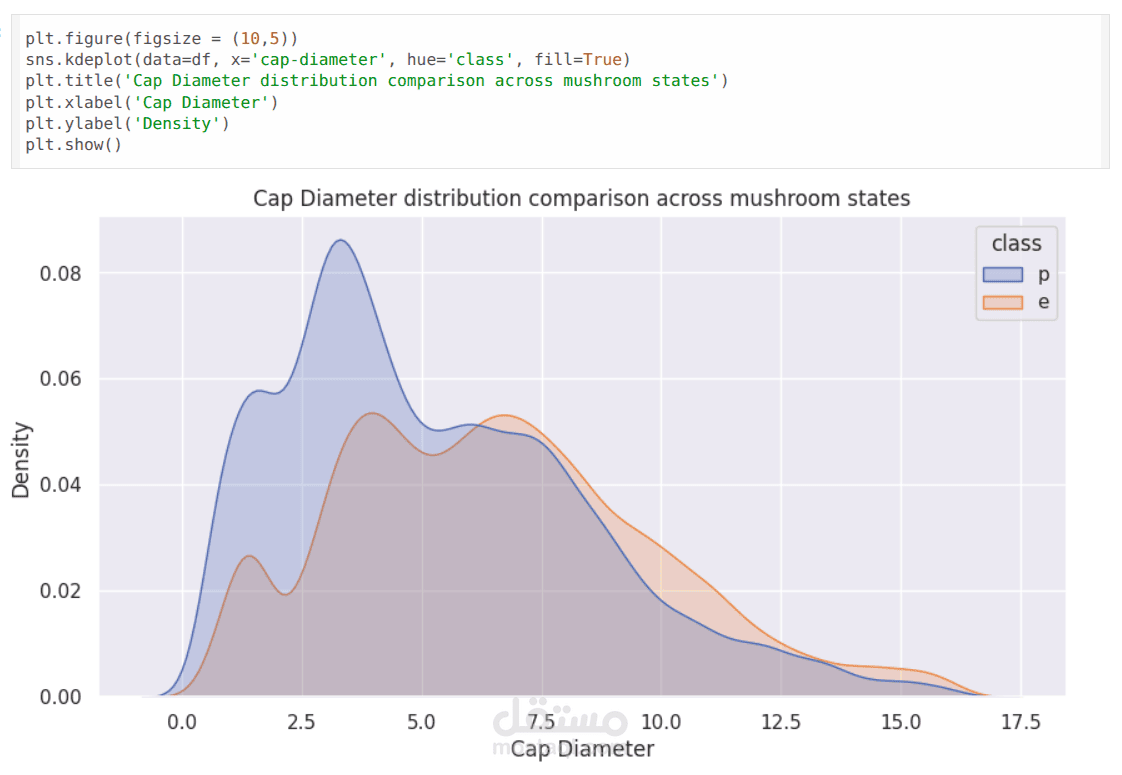
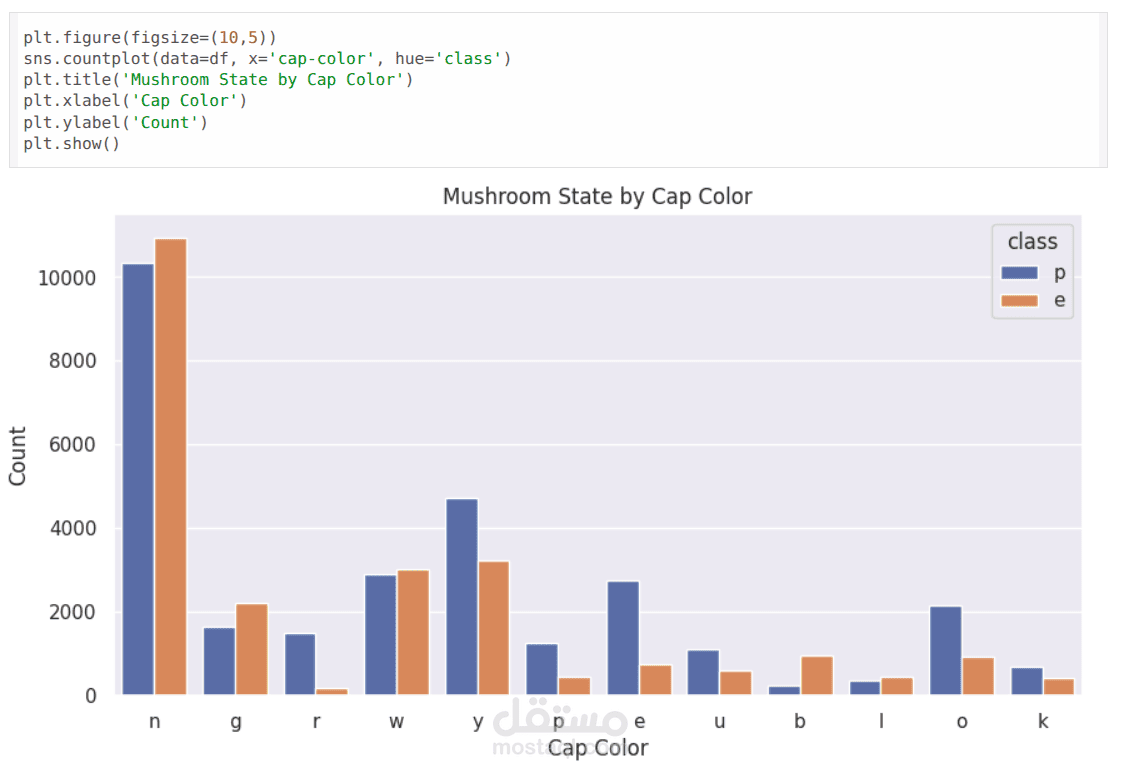
تم تحليل توزيع المتغير الهدف (class).
تم استخدام الرسوم البيانية (الرسوم البيانية الشريطية، رسوم العد) لتحديد الخصائص الفيزيائية الأكثر ارتباطًا بقابلية الفطر للأكل أو سميته.
3. المعالجة المسبقة للبيانات
ترميز التسمية (Label Encoding): تم تحويل المتغير الهدف (class) من تسميات فئوية ('e', 'p') إلى قيم رقمية (0, 1) باستخدام LabelEncoder.
ترميز الخصائص (Feature Encoding): تم تحويل جميع الخصائص الفئوية إلى تنسيق رقمي باستخدام One-Hot Encoding لإنشاء مصفوفة ثنائية لخوارزميات التعلم الآلي.
تقسيم للتدريب والاختبار: تم تقسيم مجموعة البيانات بشكل استراتيجي إلى مجموعة تدريب (عادةً 80%) لتطوير النموذج ومجموعة اختبار (20%) للتقييم غير المتحيز.
4. بناء وتقييم النماذج
الخوارزميات المستخدمة: تم تطبيق مجموعة متنوعة من المصنفات للمقارنة:
الانحدار اللوجستي (Logistic Regression)
الجيران الأقرب (k-Nearest Neighbors)
آلة المتجه الداعم (SVM)
شجرة القرار (Decision Tree)
الغابة العشوائية (Random Forest)
مقاييس الأداء: تم تقييم النماذج بدقة بناءً على:
الدقة (Accuracy)
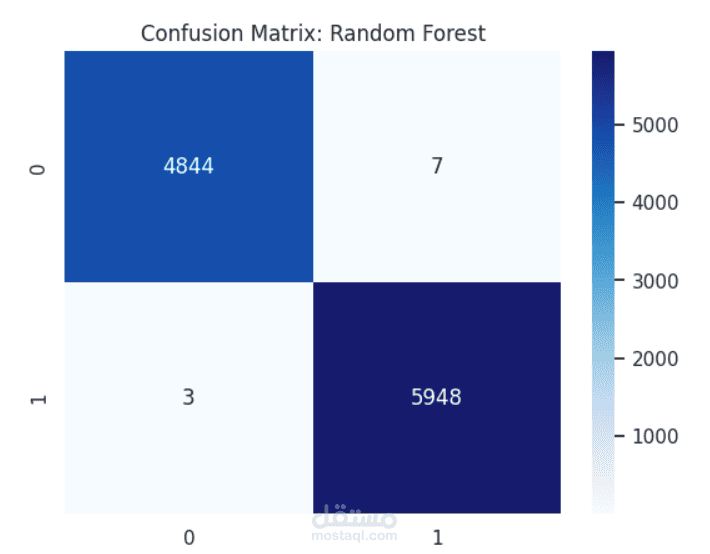
مصفوفة الارتباك (Confusion Matrix)
تقرير التصنيف (Classification Report) (الضبط، الاستدعاء، درجة F1)
النتائج والملخص
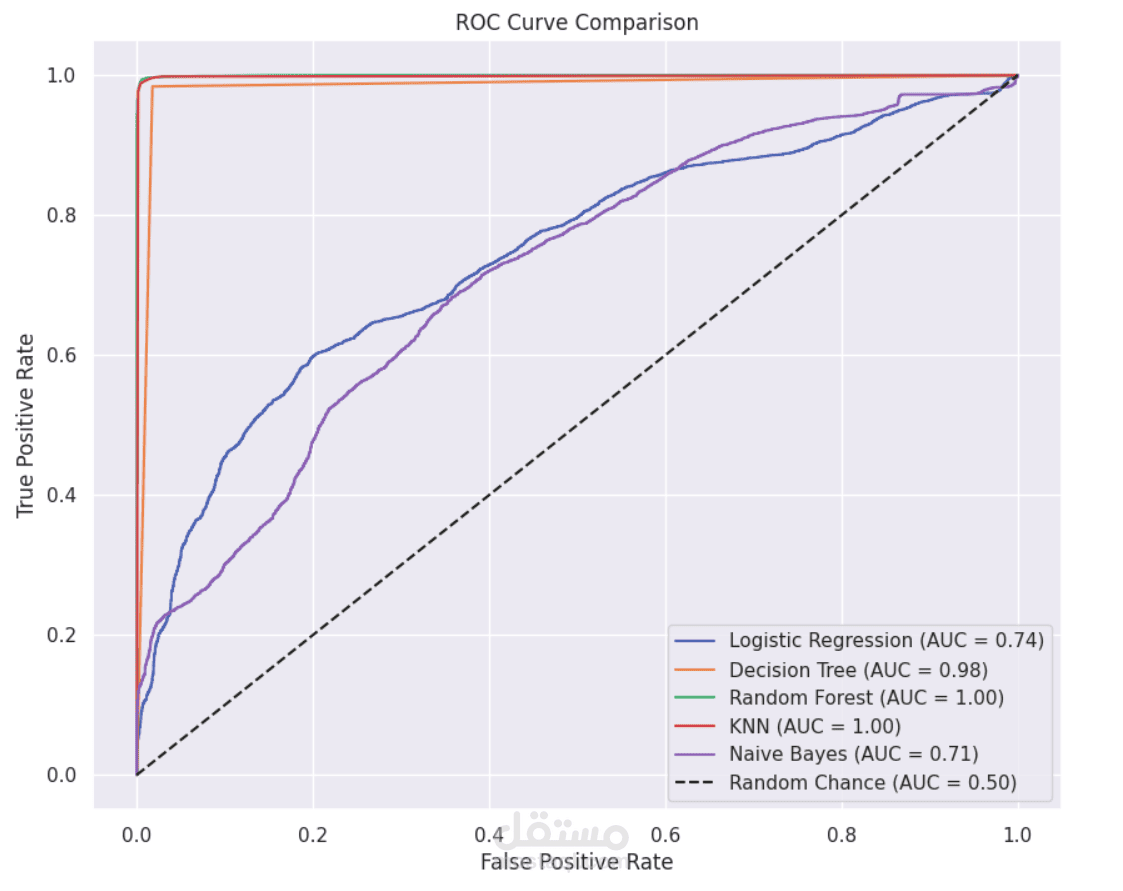
قدرة تنبؤية استثنائية: مجموعة البيانات قابلة للفصل بدرجة عالية، حيث حققت النماذج المُحسّنة درجات دقة للاختبار تتراوح من 99-100%.
الأداء الأفضل: قدمت خوارزمية الغابة العشوائية Random Forest أداءً رائدًا باستمرار، مستفيدة بشكل فعال من مساحة الخصائص المعقدة التي تم إنشاؤها بالترميز.
المؤشرات الرئيسية: أكد التحليل الاستكشافي أن رائحة الفطر هي مؤشر قوي للغاية على فئته، مع ارتباط روائح محددة حصريًا بالأنواع السامة تقريبًا.
الخلاصة
يوضح هذا المشروع بنجاح سير عمل التعلم الآلي الكامل، بدءًا من تحليل البيانات الأولي وصولًا إلى نشر نموذج تصنيف عالي الدقة. إنه يعرض القدرة القوية للتعلم الآلي على معالجة مشكلة عملية وحاسمة للسلامة. تشير النتائج التي تم تحقيقها إلى أن نموذجًا كهذا يمكن أن يكون مكونًا موثوقًا به في أداة مساعدة لتحديد الفطر.
تحسينات مستقبلية محتملة
تطوير التطبيق: دمج النموذج النهائي في تطبيق ويب أو هاتف محمول سهل الاستخدام للاستخدام في العالم الحقيقي.
تحسين النموذج: استكشاف ضبط المعاملات الفائقة (hyperparameter tuning) والأساليب المتقدمة مثل Gradient Boosting (XGBoost, CatBoost) لزيادة تعزيز الأداء.
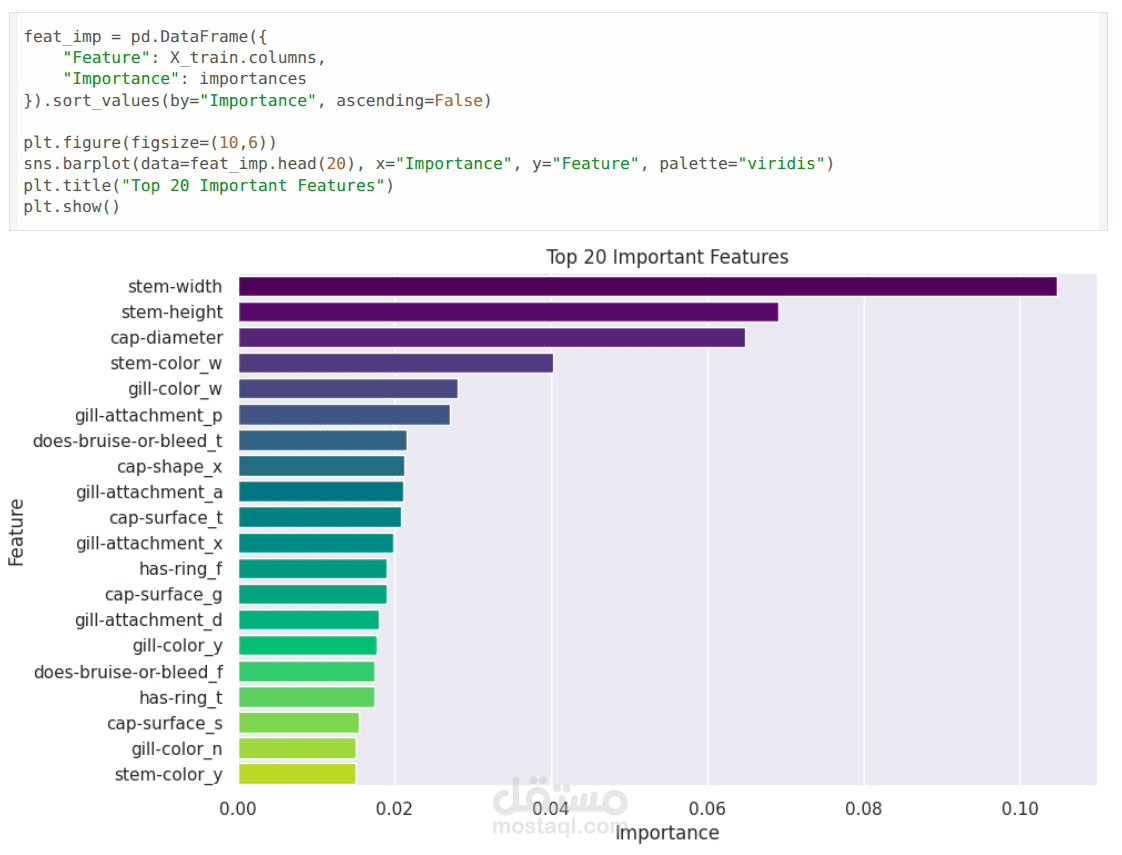
تحليل أهمية الخصائص: إجراء تحليل مفصل باستخدام مقاييس أهمية الخصائص المضمنة في الغابة العشوائية لتوفير قائمة واضحة ومرتبة لأهم المؤشرات للفطر الصالح للأكل.