التنبؤ بسرطان الثدي
تفاصيل العمل

بين الحالات الخبيثة والحميدة اعتمادًا على بيانات طبية حقيقية (Breast Cancer Dataset).
تم تنفيذ المشروع باستخدام Python ومكتبات Pandas، NumPy، Matplotlib، Scikit-learn لتحليل البيانات، تنظيفها، واختيار أفضل الخصائص المؤثرة في التشخيص.
خطوات العمل:
تنظيف ومعالجة البيانات للتأكد من خلوها من القيم المفقودة والضوضاء.
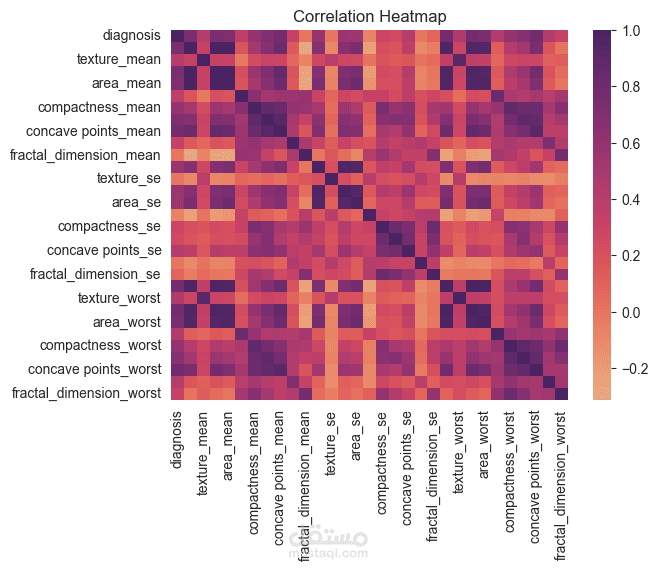
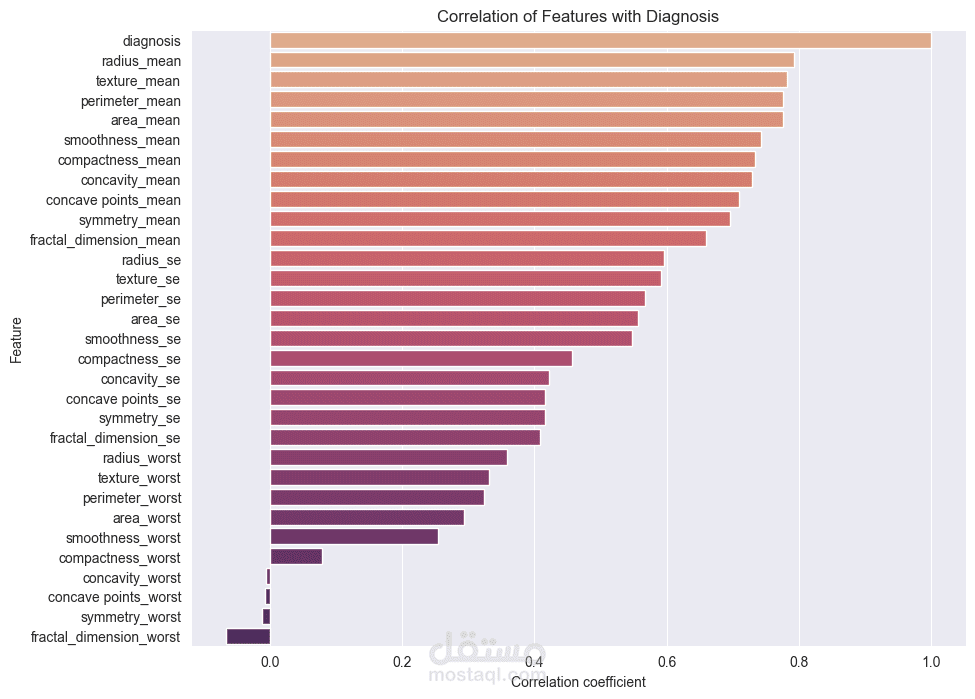
تحليل العلاقات بين الخصائص (Correlation Analysis) وتحديد السمات الأكثر تأثيرًا.
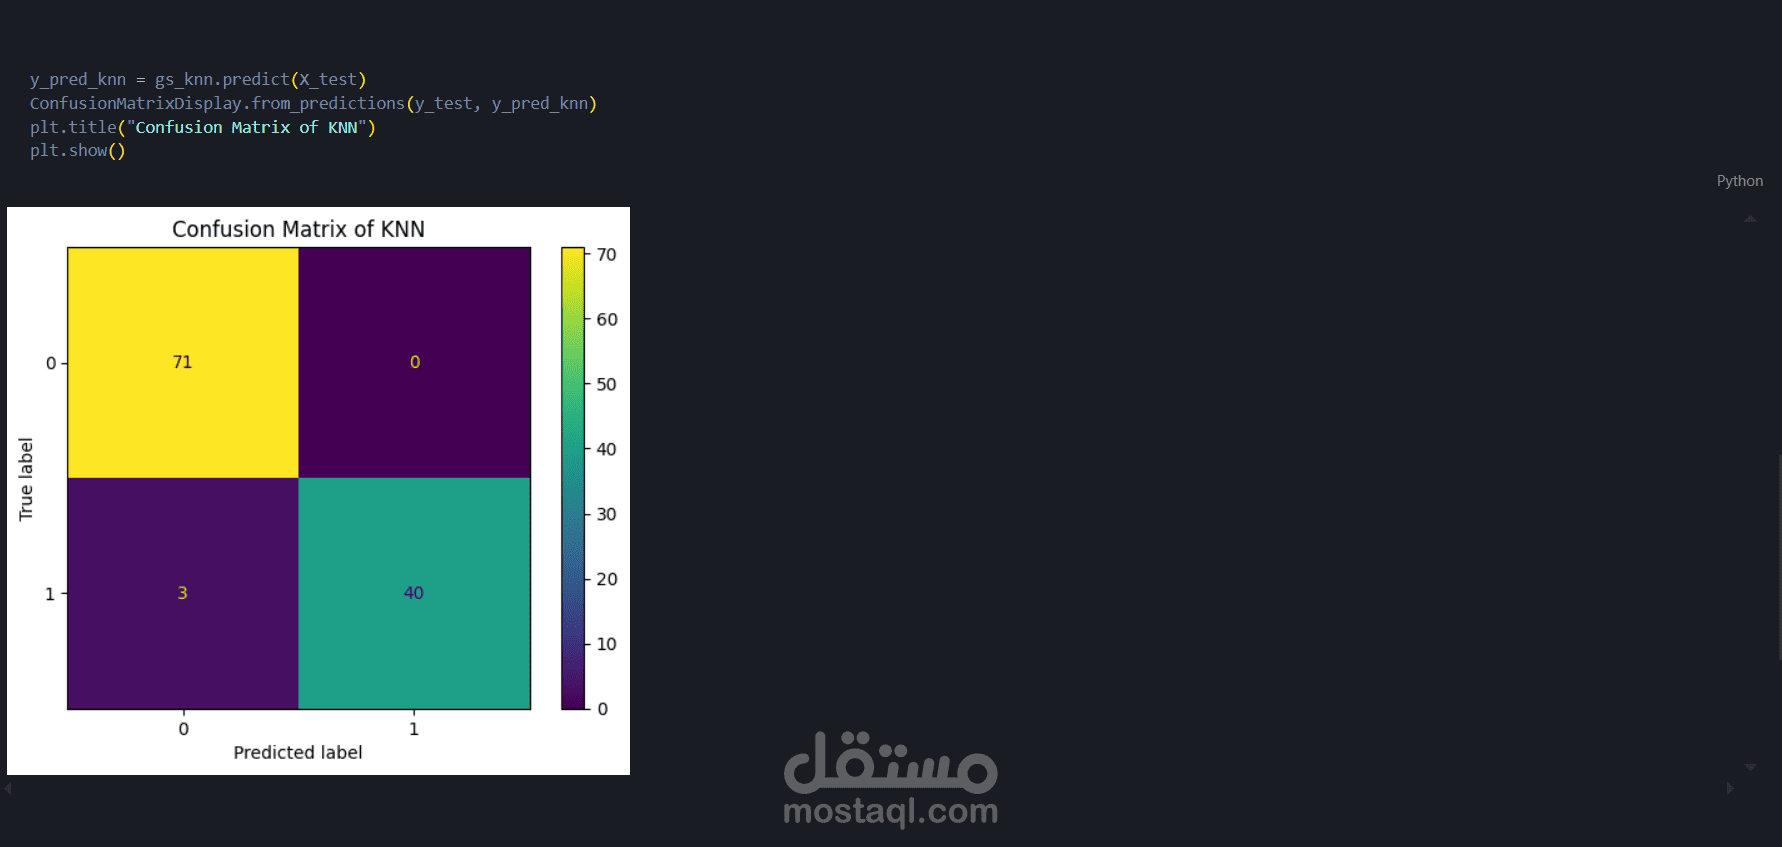
تطبيق خوارزميات مختلفة مثل KNN, Logistic Regression ومقارنة أدائها.
استخدام تجزئة البيانات (Train/Test Split) لقياس دقة النموذج والتحقق من موثوقيته.
عرض النتائج من خلال رسوم بيانية ولوحات تحليلية (Visualization) تسهّل فهم الأداء.
نتائج المشروع:
حقق النموذج دقة عالية في التنبؤ بالحالات المصابة، مما يساعد في دعم الأطباء باتخاذ قرارات أسرع وأكثر دقة.
المشروع قابل للتطوير ليشمل واجهات تفاعلية (Dashboard أو Web App) لتسهيل الاستخدام العملي.