Identification of feature genes to prediction drug efficiency based on machine learning
تفاصيل العمل

تحديد الجينات المميزة للتنبؤ بكفاءة الأدوية باستخدام التعلم الآلي
في هذا المشروع تم تطوير نموذج باستخدام تقنيات التعلم الآلي للتنبؤ بكفاءة الأدوية لعلاج مرض الكبد الدهني غير الكحولي (NASH)، وذلك اعتمادًا على تحليل التعبير الجيني.
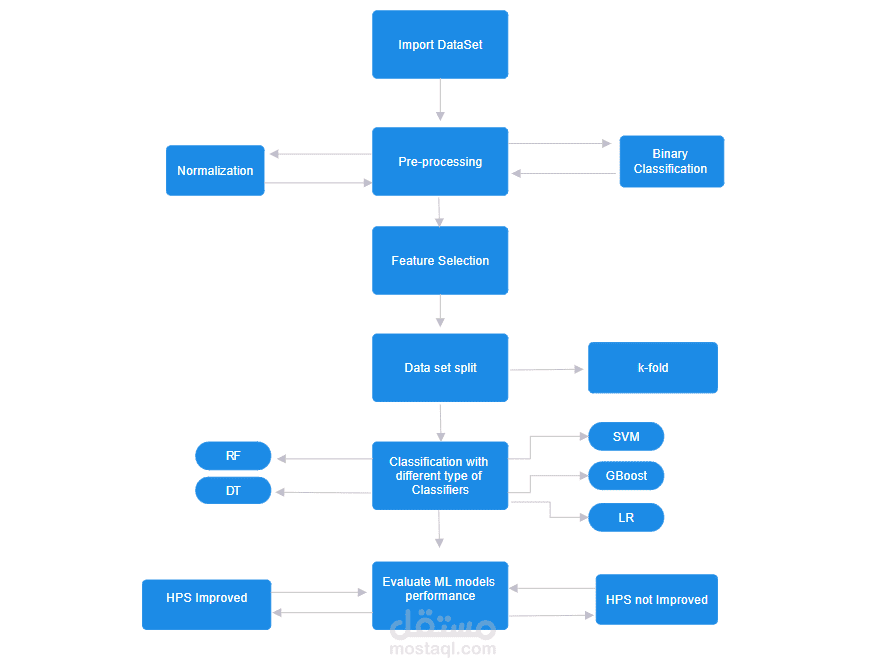
1. استيراد البيانات وتجهيزها:
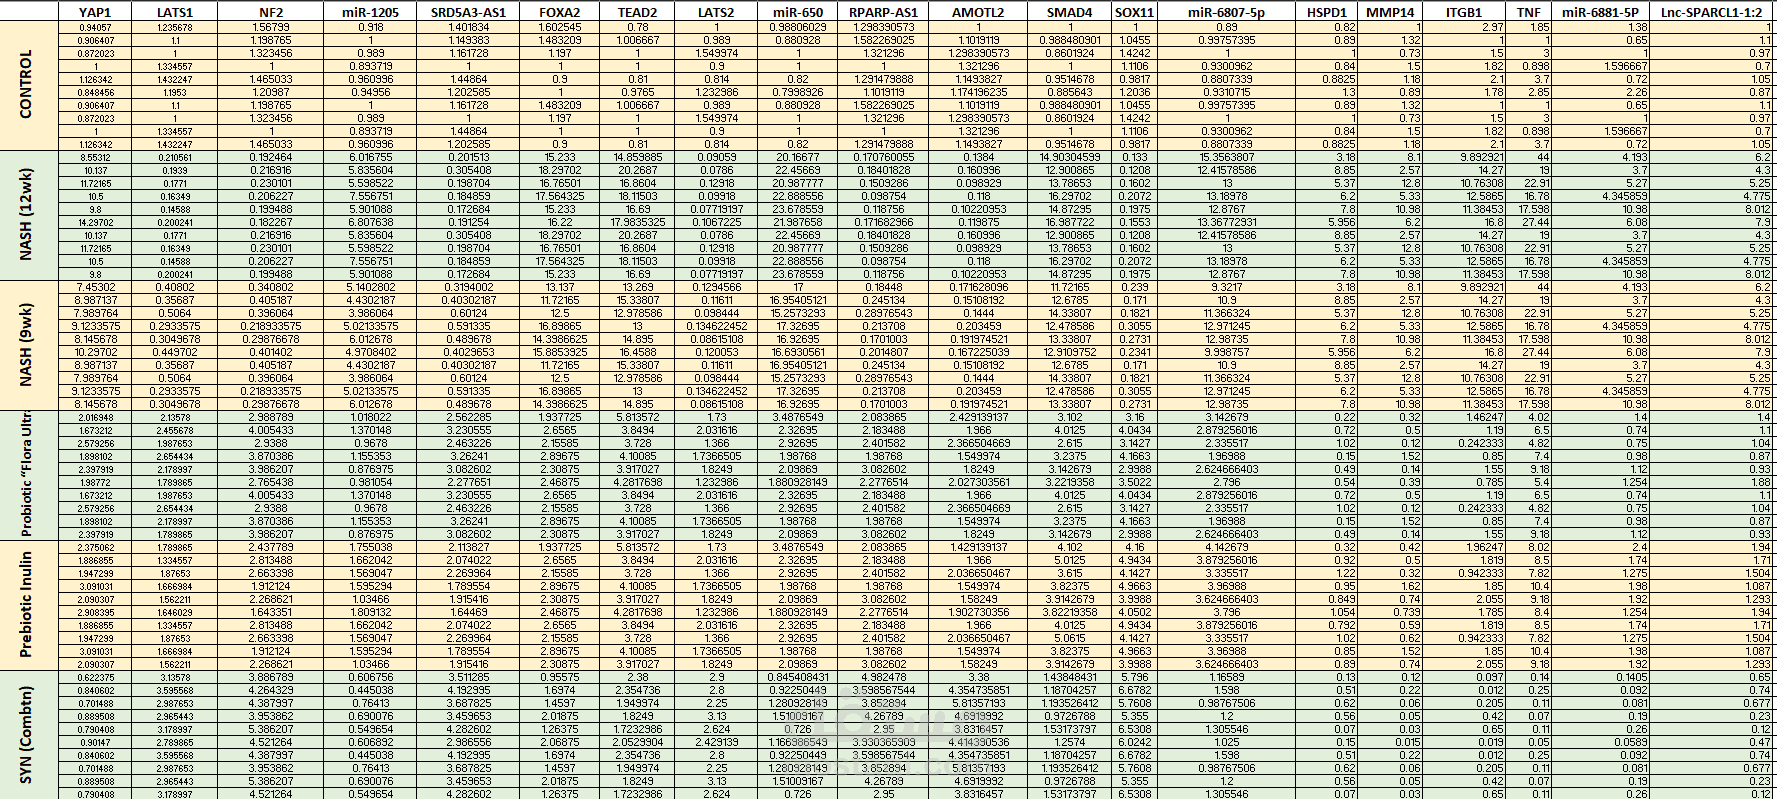
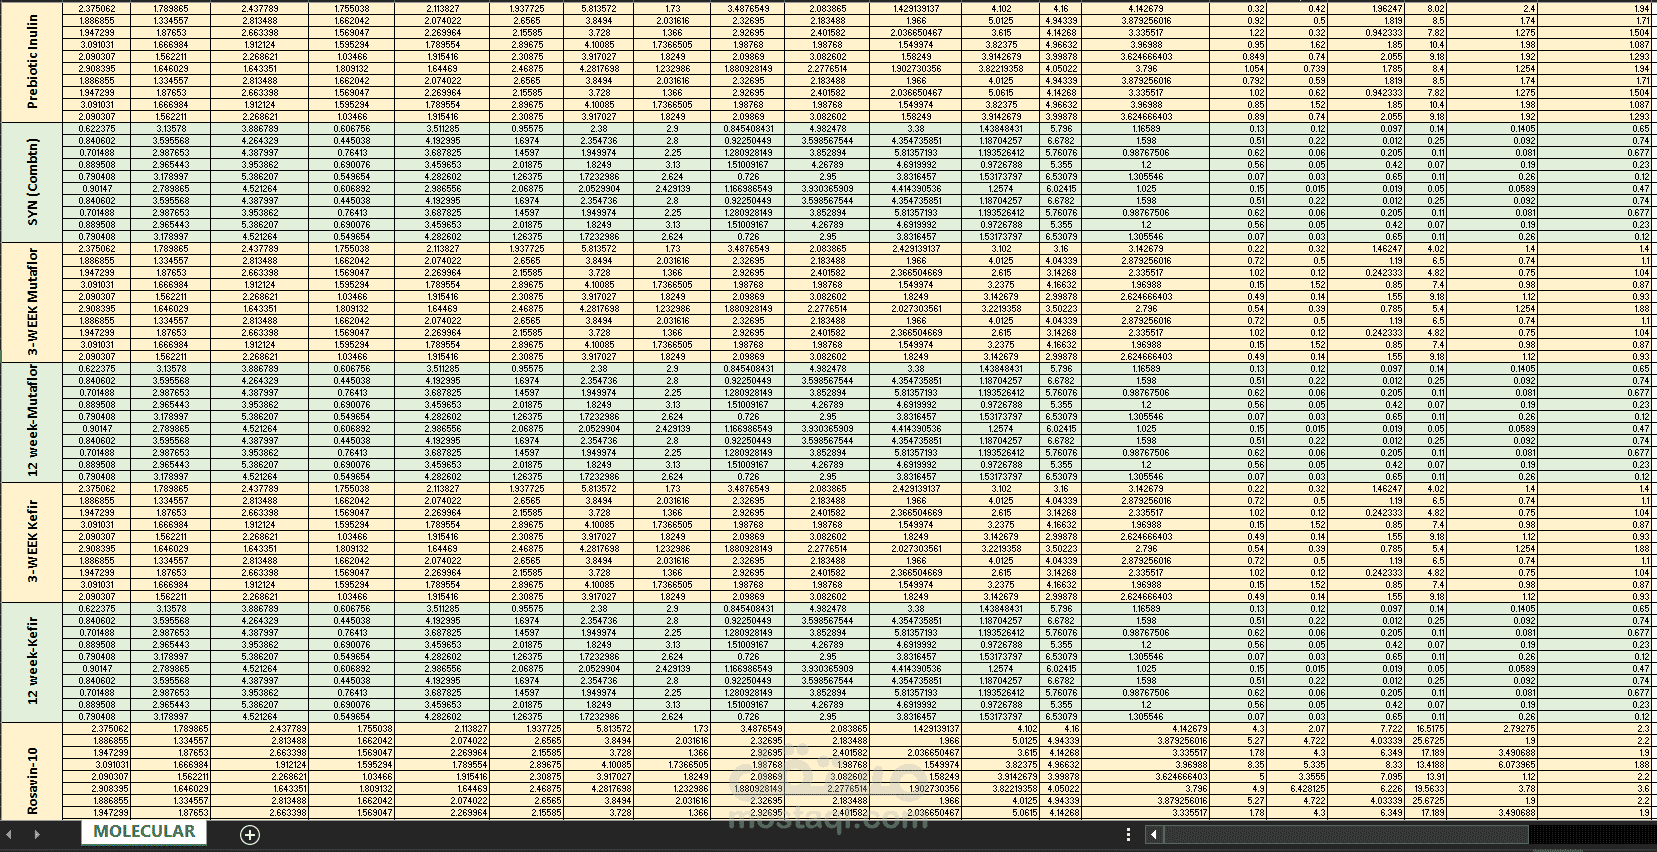
- تم استيراد بيانات التعبير الجيني لفئران مصابة بالمرض وأخرى خالية منه.
- البيانات تضمنت مجموعات علاجية مختلفة مثل البروبيوتيك والبريبايوتيك وعلاجات أخرى.
- تمت مراجعة البيانات للتأكد من عدم وجود قيم مفقودة.
2. معالجة البيانات وتنظيفها:**
- تم استخدام طريقتين للتعامل مع القيم الشاذة:
- طريقة IQR لاكتشاف القيم البعيدة عن المدى الطبيعي.
- طريقة LOF لاكتشاف القيم الشاذة بناءً على كثافة توزيع البيانات.
- ثم تم توحيد البيانات (Normalization) لضمان تناسق القياسات بين الجينات.
**3. تحليل استكشافي للبيانات:
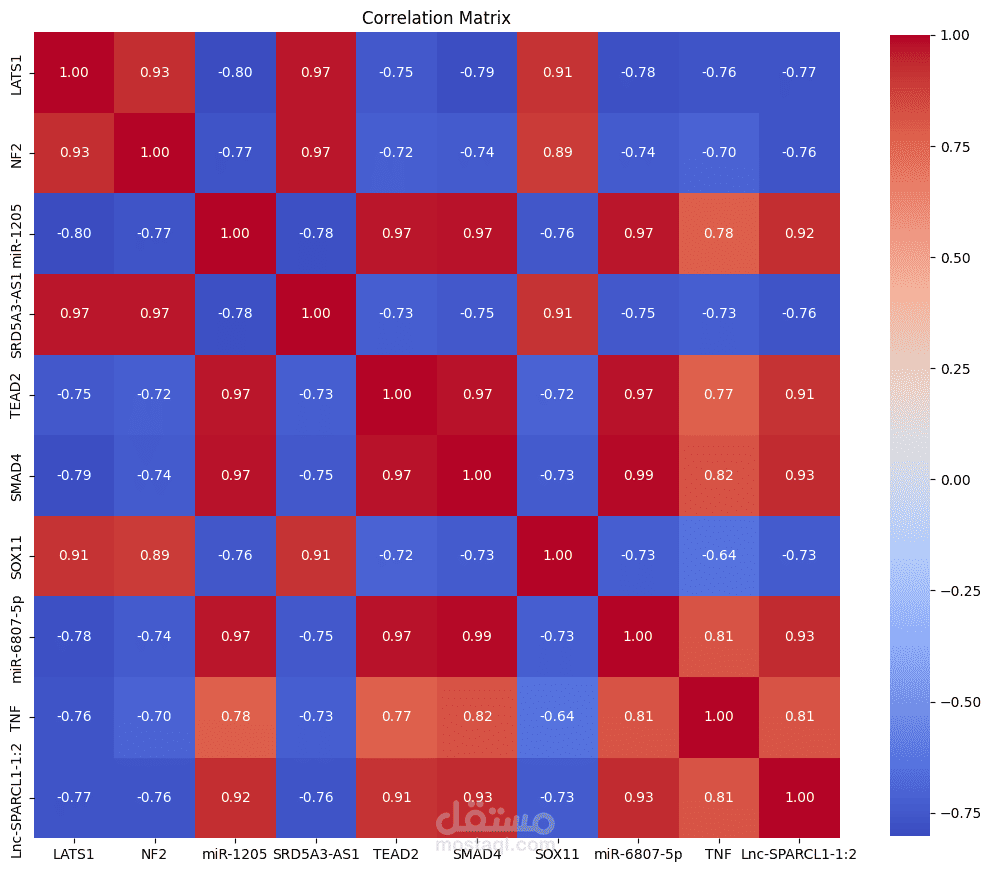
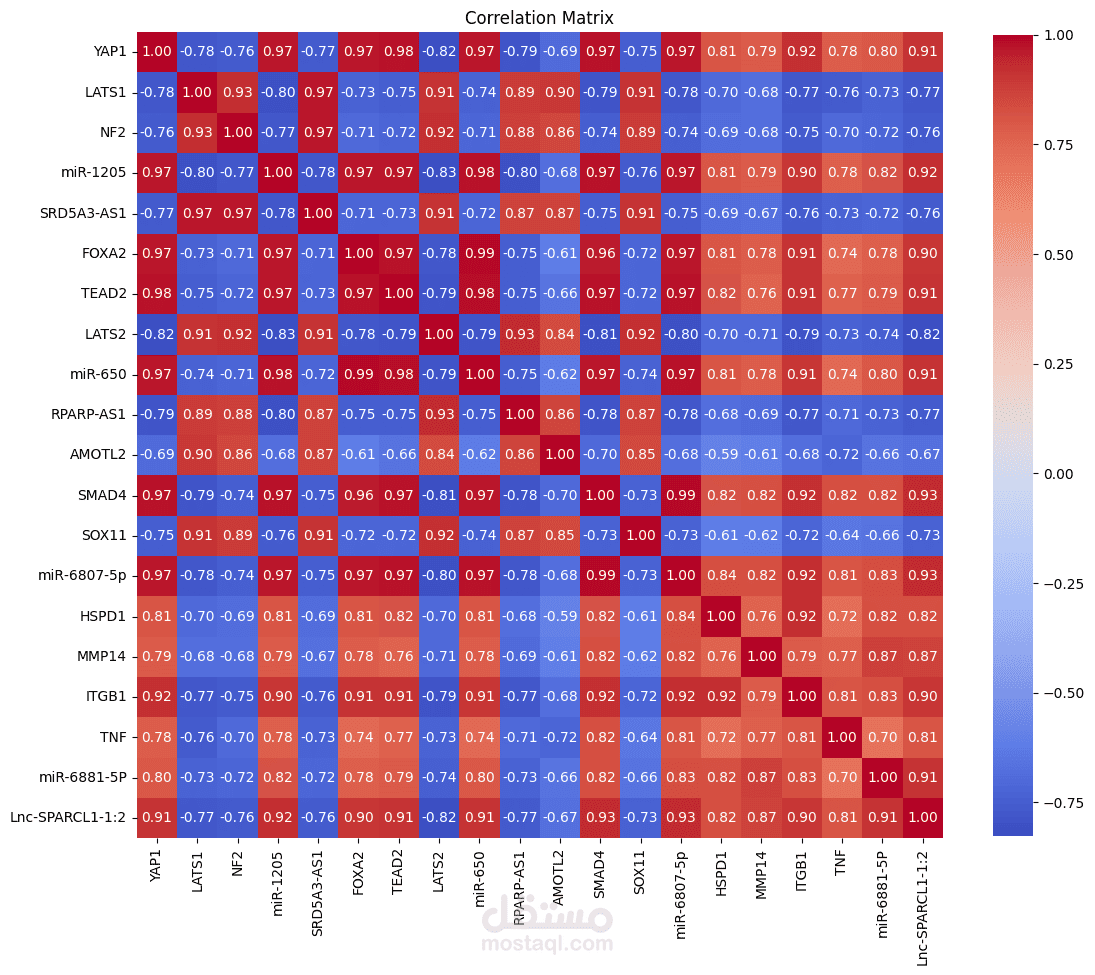
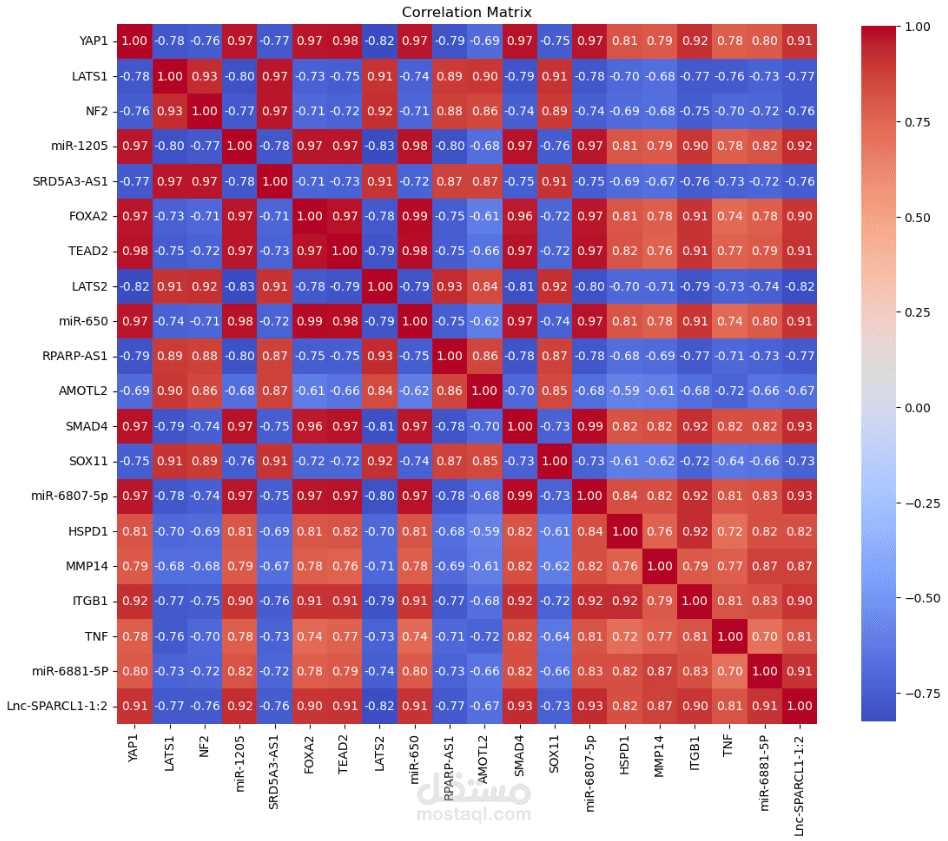
- إنشاء مصفوفة ارتباط بين الجينات لفهم العلاقات بينها.
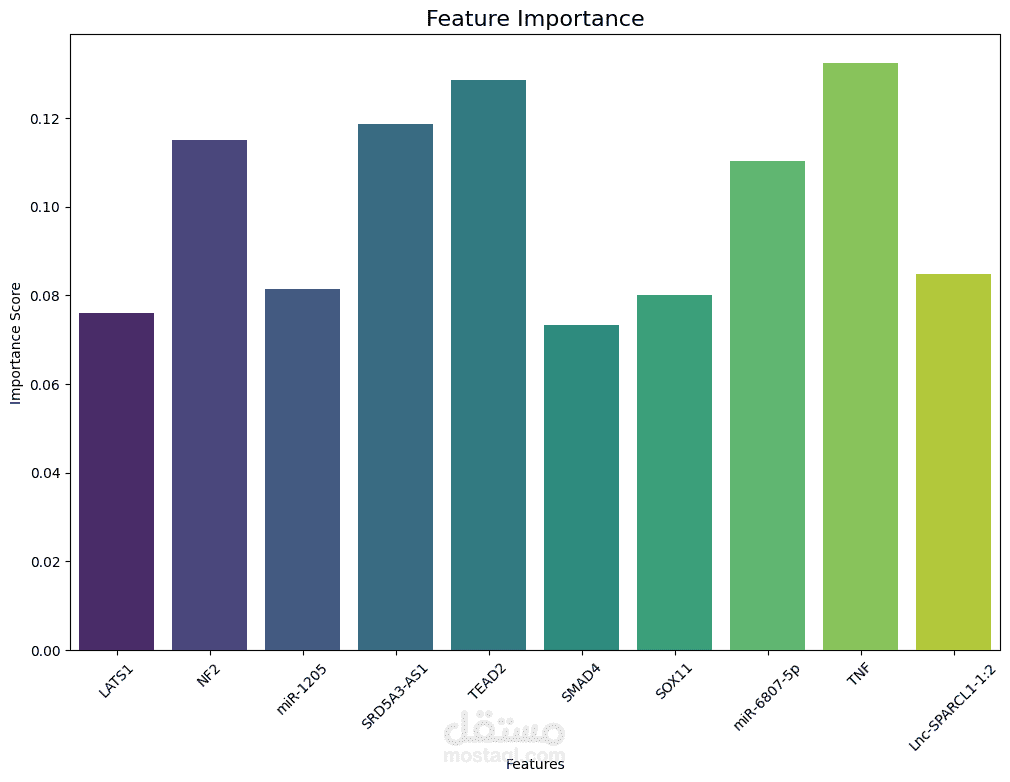
- استخدام تقنيات تحليل التباين وأهمية ميزات الغابات العشوائية (Random Forest) لاختيار أهم الجينات المؤثرة.
4. بناء النماذج:
- تم تقسيم البيانات إلى مجموعة تدريب واختبار باستخدام K-Fold Cross-Validation لضمان تقييم عادل.
- بناء واختبار عدة نماذج تصنيفية منها: Random Forest، Logistic Regression، SVM، Gradient Boosting، وDecision Trees.
5. تقييم أداء النماذج:
- تم تقييم النماذج باستخدام مقاييس الدقة، الاسترجاع، معامل F1، ومؤشر الدقة.
- تبين أن نموذج Random Forest حقق أفضل أداء مقارنة بباقي النماذج.
6. التصوير وتحليل النتائج:
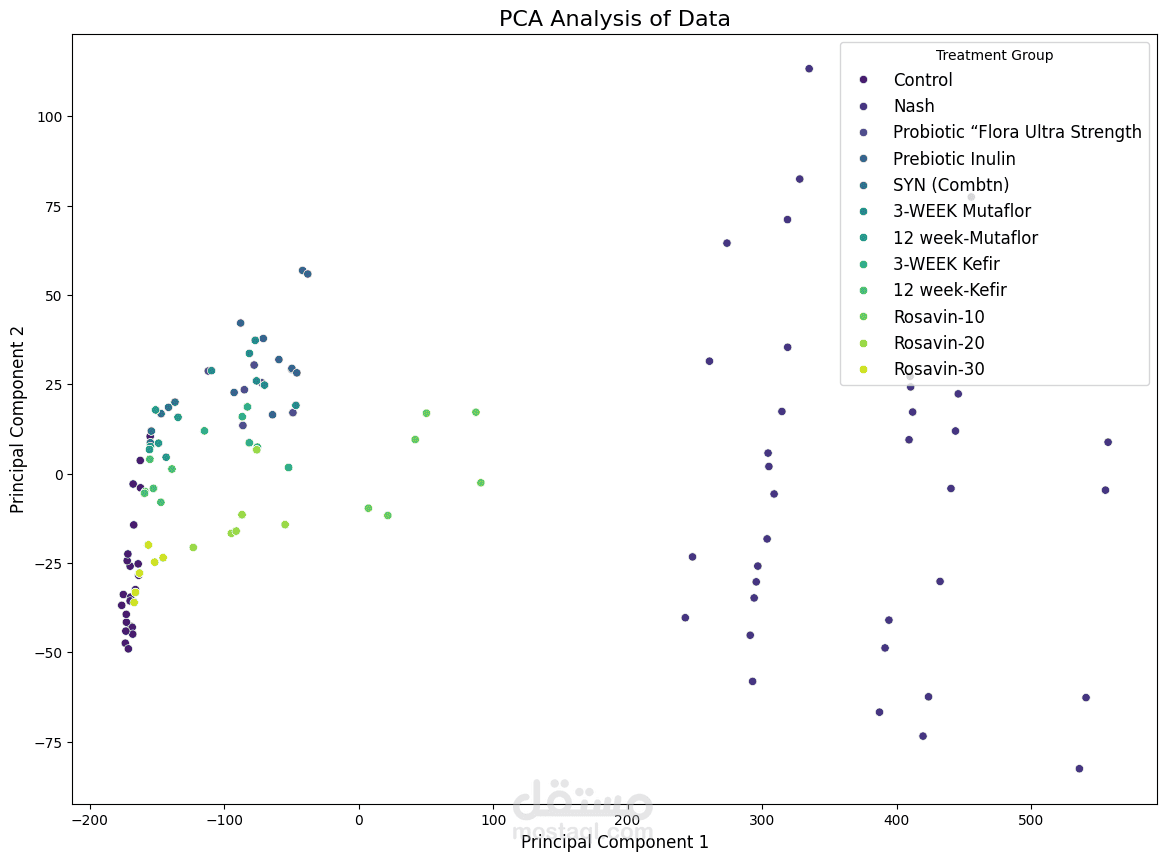
- تم استخدام تقنية تحليل المكونات الرئيسية (PCA) لعرض توزيع العينات بصريًا وتقليل أبعاد البيانات.
- إنشاء خرائط حرارية توضح علاقات الارتباط بين الجينات.
- تحليل أهمية الجينات للتعرف على الجينات الأكثر تأثيرًا في تطور المرض والاستجابة للعلاج.
7. أهم النتائج:
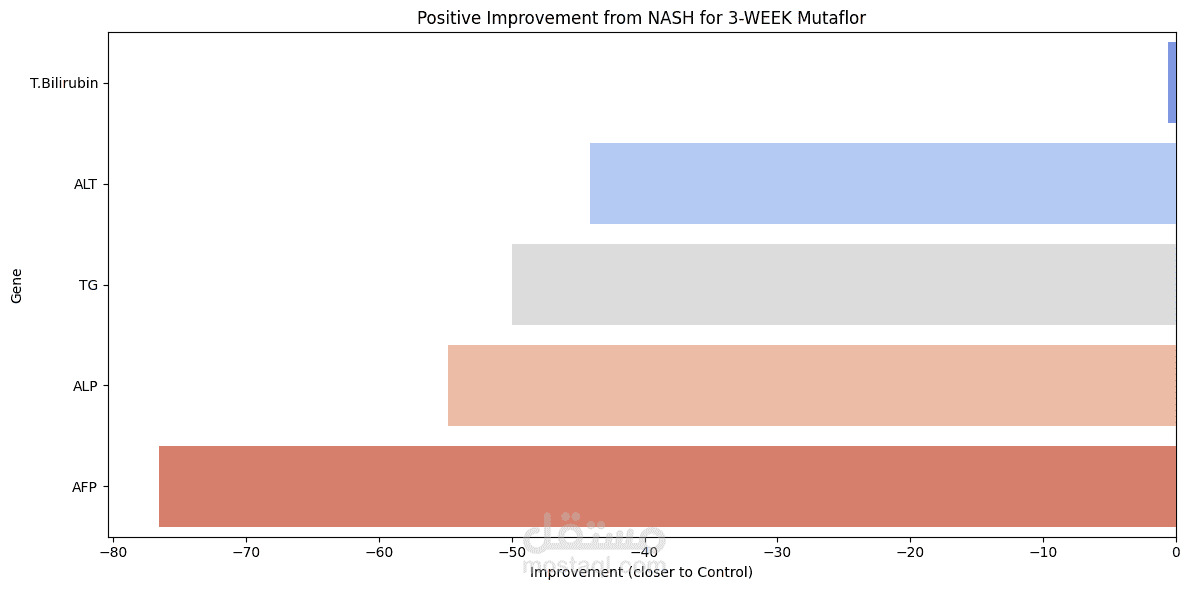
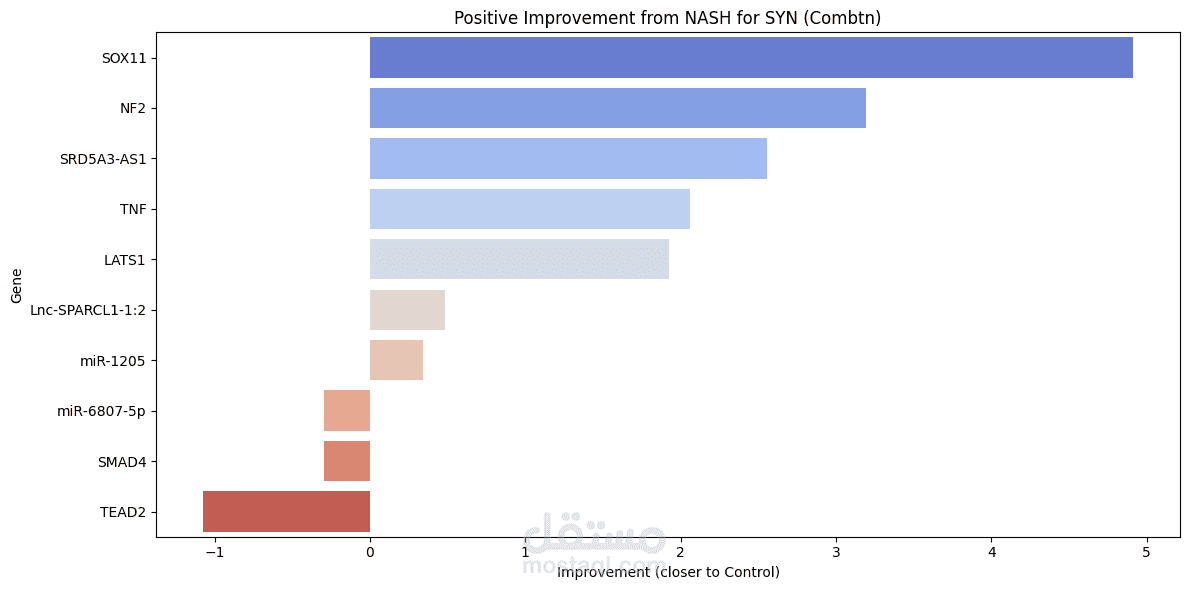
- تم تحديد عدد من الجينات الأساسية المرتبطة بفعالية العلاجات.
- تم فصل مجموعات البيانات (التحكم، المرضى، والعلاجات) بوضوح باستخدام تقنيات التحليل البصري.