تصنيف الاحرف العربية Arabic letters classification
تفاصيل العمل

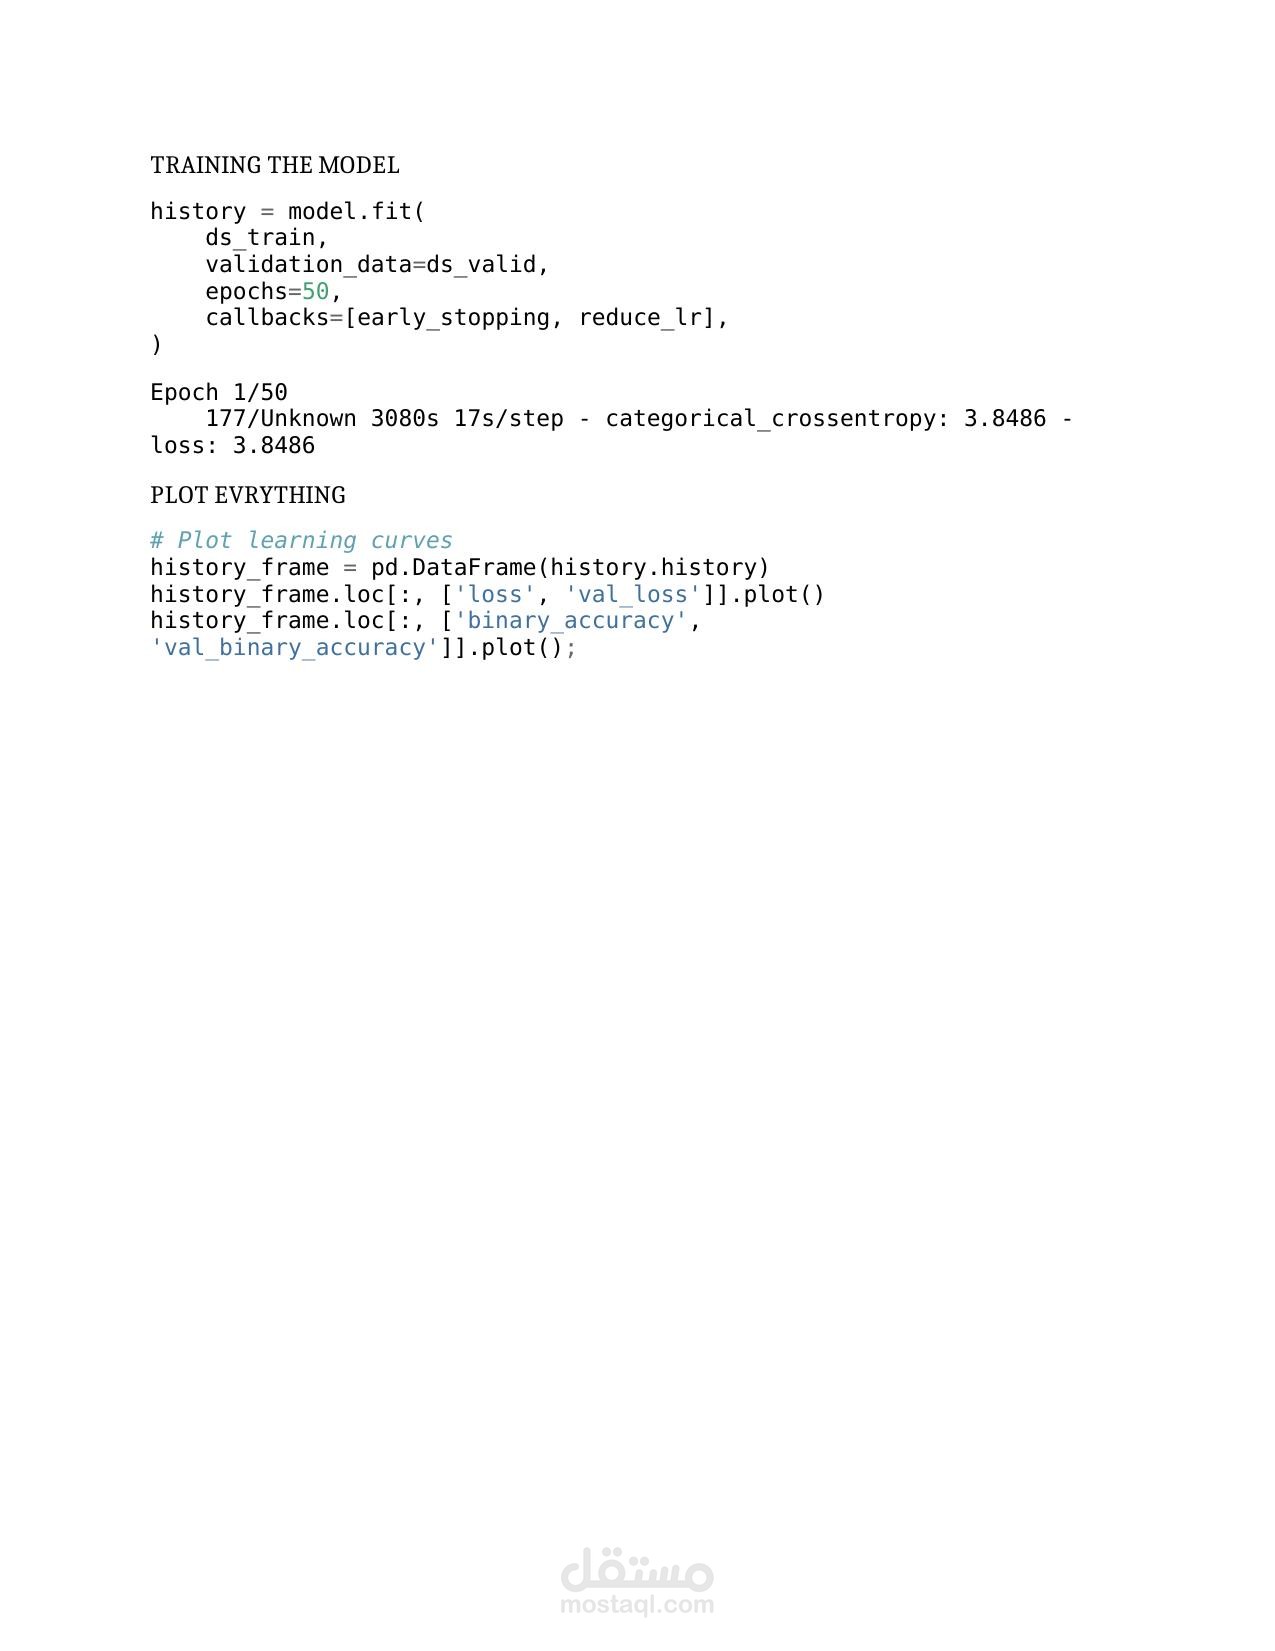
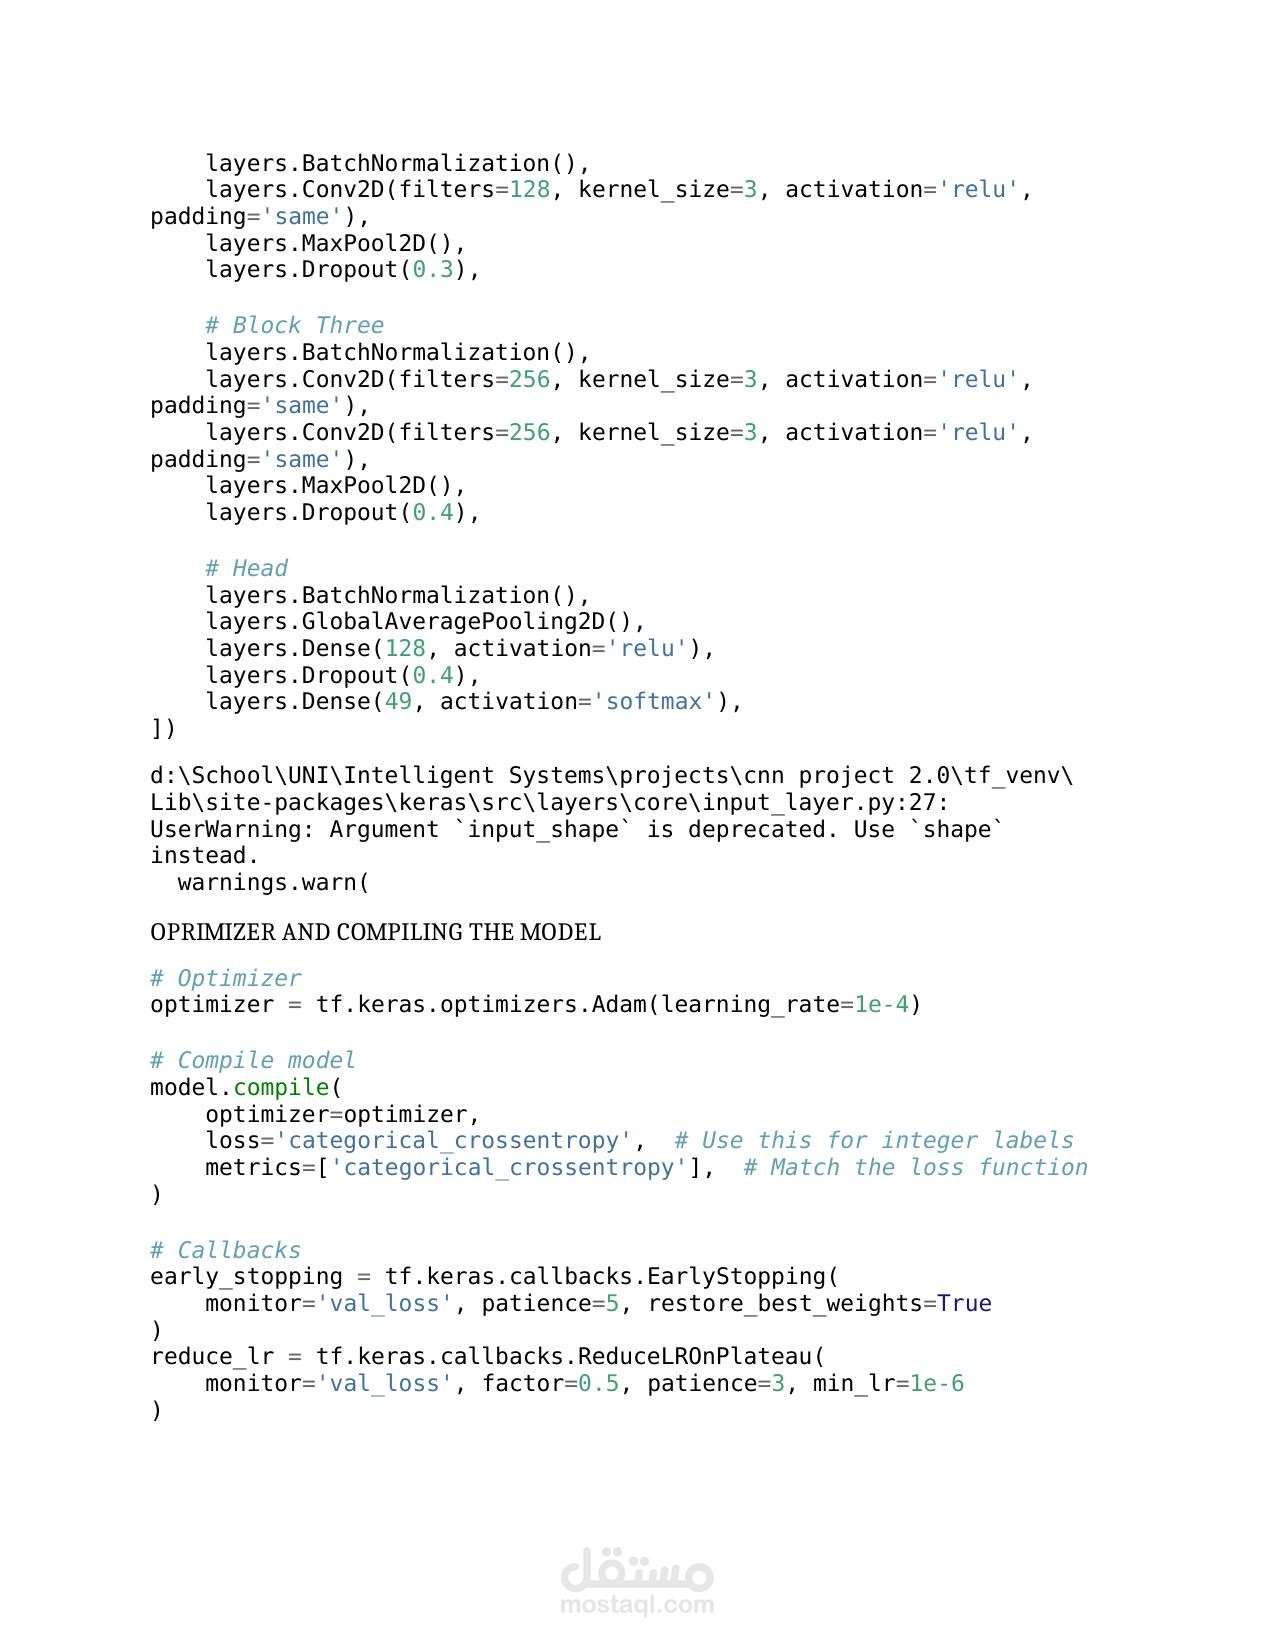
يهدف هذا المشروع إلى **تصنيف الأحرف العربية** باستخدام **الشبكات العصبية التلافيفية (CNNs)**. يتمثل الهدف في تطوير نموذج تعلم عميق قادر على التعرف بدقة على الأحرف العربية المكتوبة يدويًا أو المطبوعة وتصنيفها بشكل صحيح.
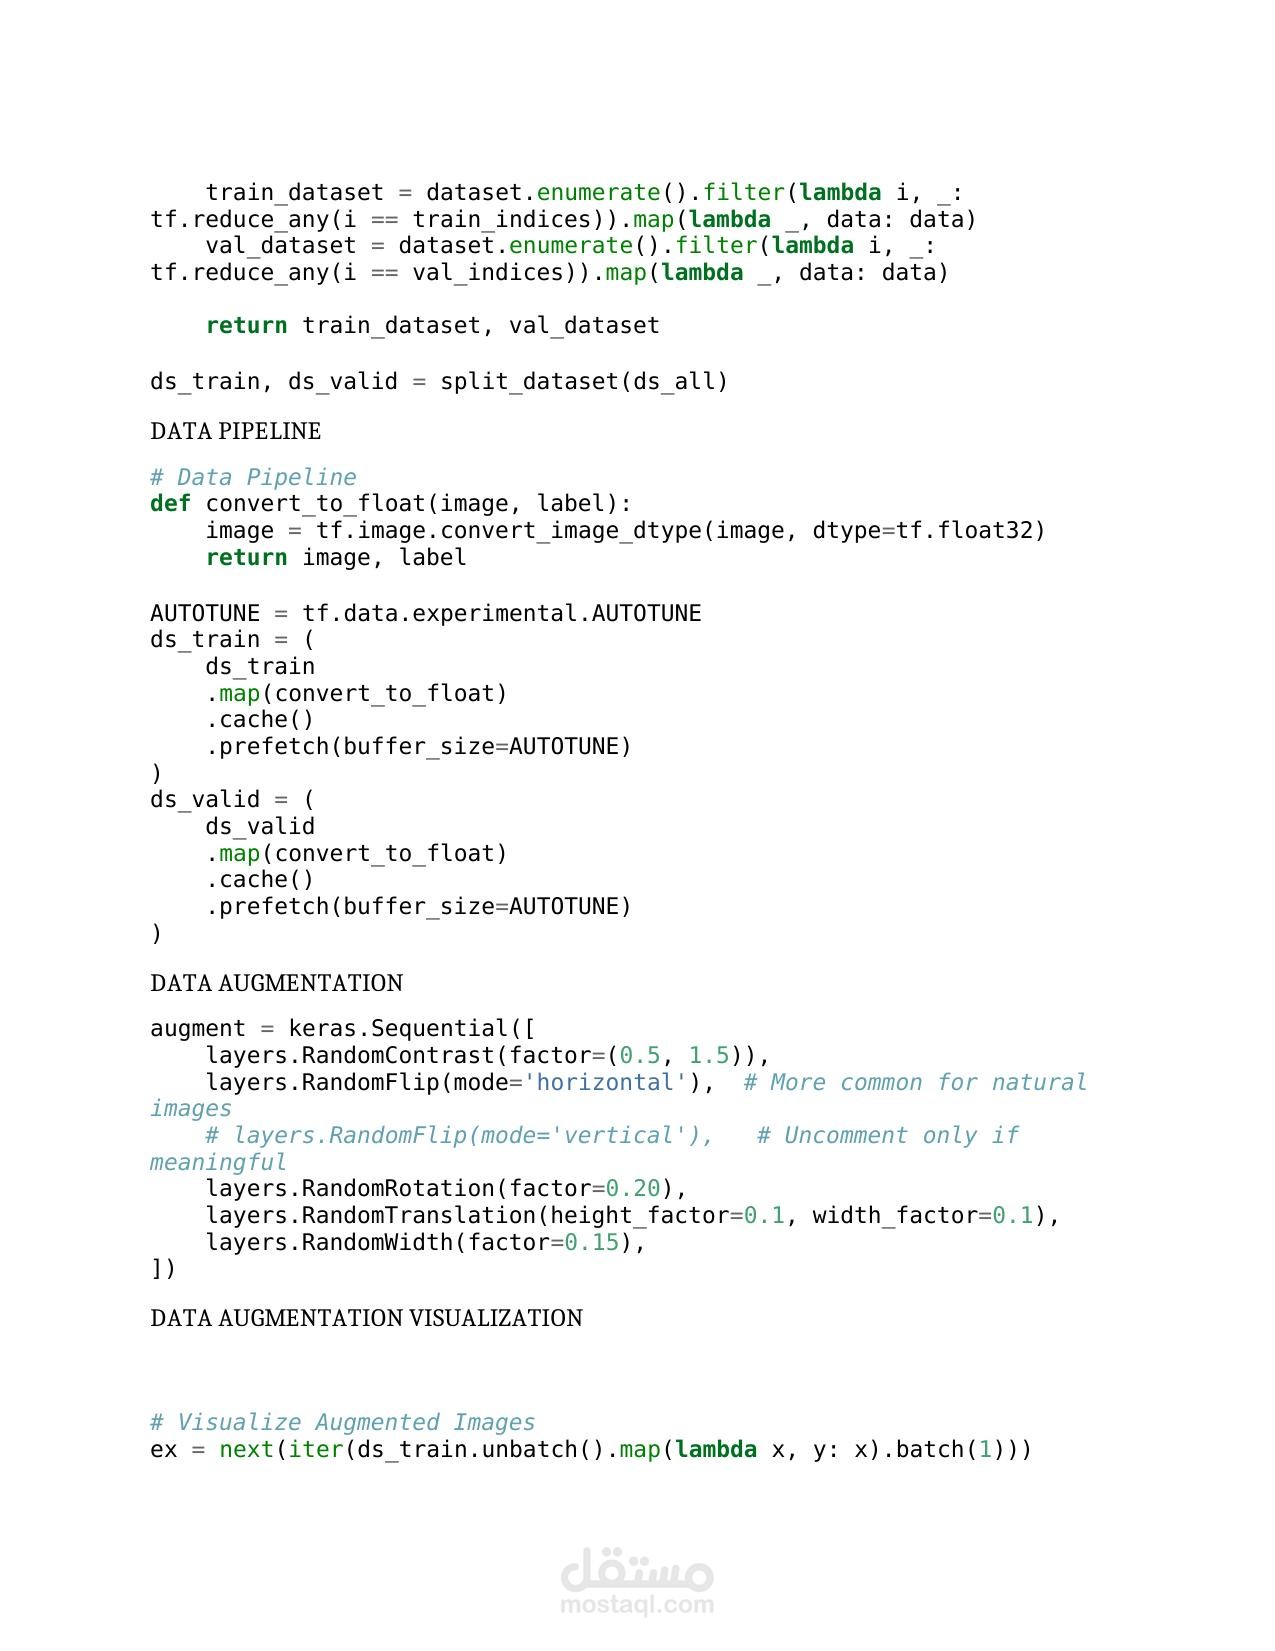
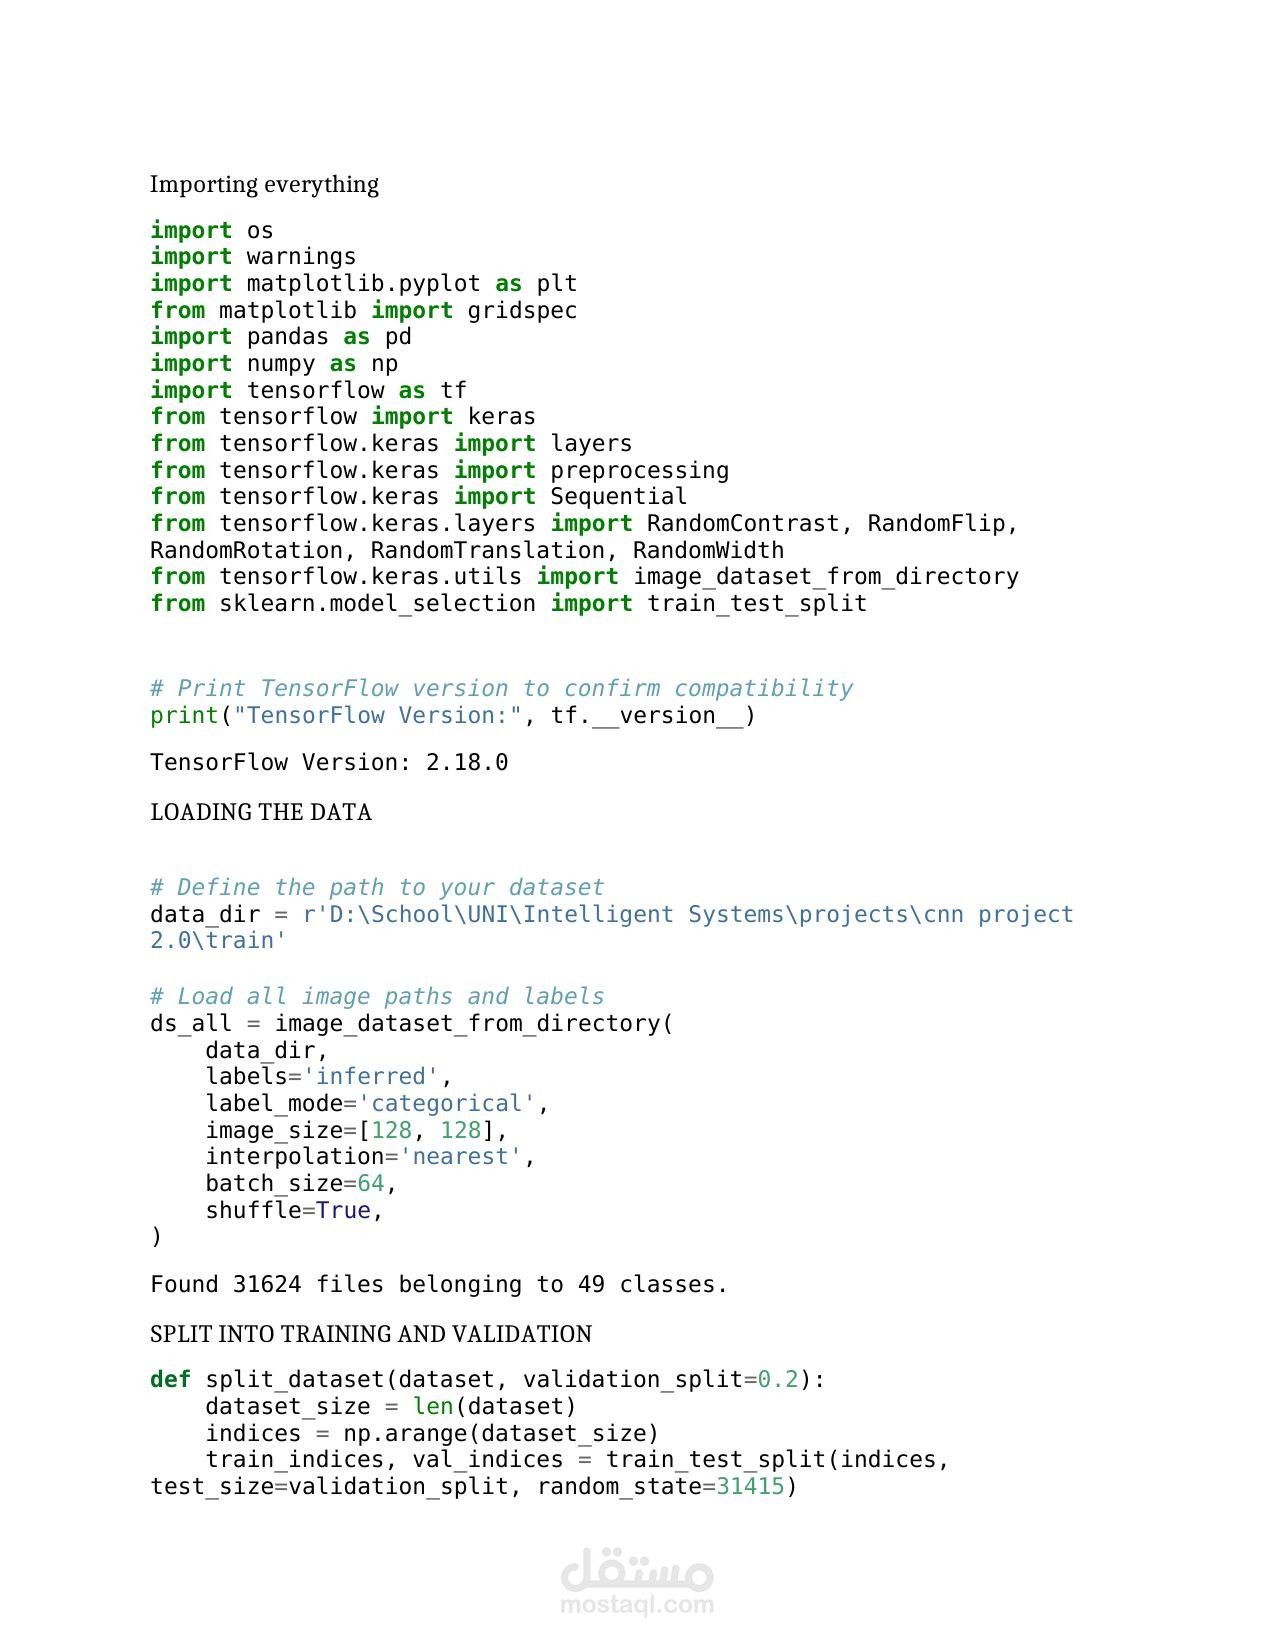
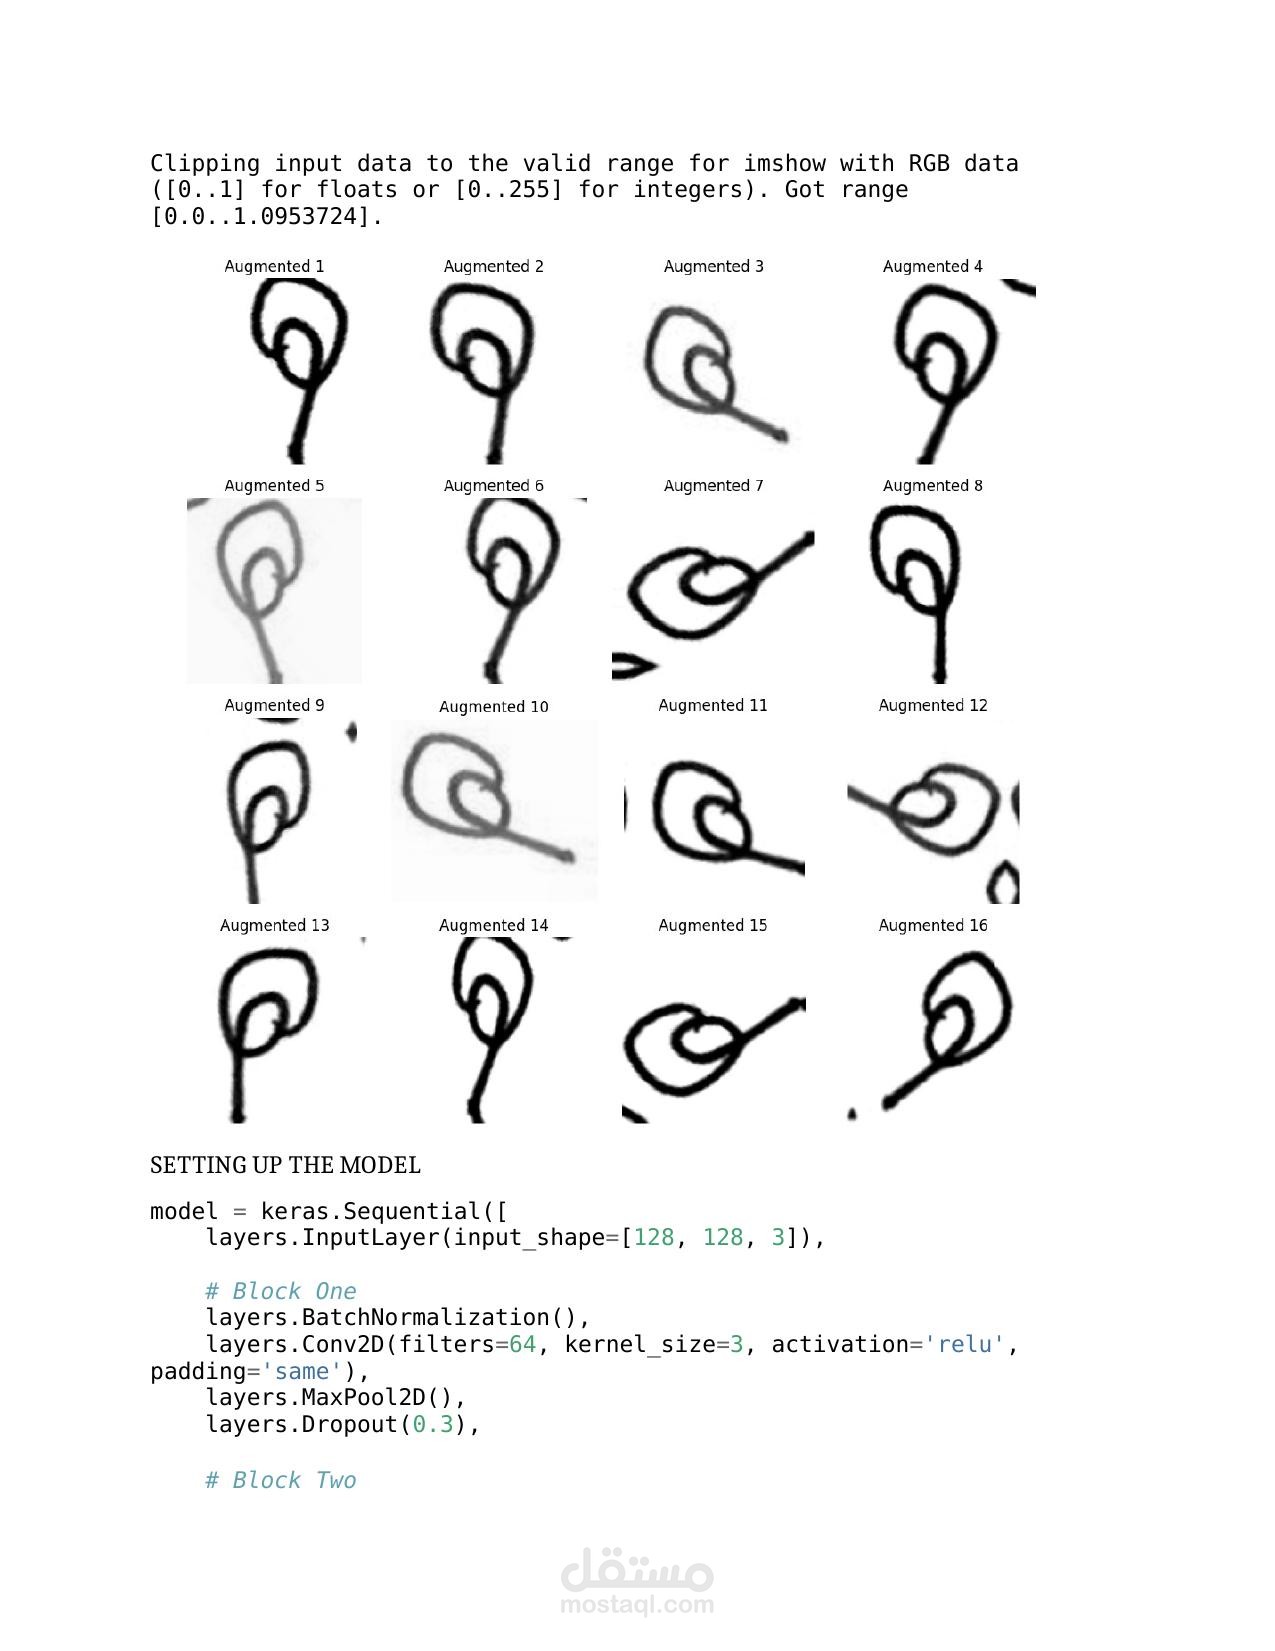
يعتمد النموذج على مجموعة بيانات للأحرف العربية، حيث يتم تطبيق تقنيات **المعالجة المسبقة** مثل **التطبيع والتعزيز** لتحسين الأداء. يتم تصميم **بنية شبكة CNN** لاستخراج الميزات المهمة من البيانات، من خلال استخدام **طبقات الالتفاف والتجميع والتوصيل الكامل** لتحقيق تصنيف دقيق.
يهدف المشروع إلى تحقيق **دقة عالية وموثوقية قوية**، مما يجعله مفيدًا في تطبيقات مثل **التعرف الضوئي على الأحرف (OCR)، والترجمة الآلية، ورقمنة النصوص العربية**.